
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 — jak wybrać? Porównanie dostępności, cen i zastosowań
Gemini 4 Argon: ograniczony dostęp; dostępne GPT-6 Astra i Claude Fable 5.1 wybieraj wg zadania i planu, ceny API poza subskrypcjami, z oficjalnych danych, nie testu w tych samych warunkach.
Weryfikacja materiałów: 30 września 2026 r. (UTC). PandaNpc świadczy usługi AI Agent, co wiąże się z wyborem modelu. W tym artykule zebrano publicznie dostępne informacje od trzech firm i podano zalecenia dotyczące wyboru według zadania; nie uzyskaliśmy jeszcze dostępu testowego do Gemini 4 Argon i nie przeprowadziliśmy testów trzech modeli w tych samych warunkach. Użyte poniżej określenie „pasuje” odnosi się do oficjalnego pozycjonowania i obecnej dostępności, a nie oznacza, że zmierzyliśmy, który model jest lepszy.
Najpierw wniosek: jeśli chcesz używać modelu już dziś, najpierw wybierz między GPT-6 Astra i Claude Fable 5.1 na podstawie zadania i obecnego planu; Gemini 4 Argon jest obecnie dostępny tylko dla niewielkiej liczby zaufanych testerów, więc zwykli użytkownicy nie mogą jeszcze traktować go jako trzeciej opcji dostępnej w każdej chwili. W przypadku działań między aplikacjami, złożonego porządkowania materiałów lub trudnego programowania możesz najpierw wypróbować Astra; w przypadku długotrwałego programowania, wielokrotnego czytania dużych projektów lub złożonych dokumentów możesz najpierw wypróbować Fable 5.1. Gdy Argon stanie się powszechnie dostępny, porównaj na tych samych zadaniach rzeczywistą jakość wykonania i całkowity koszt.
Zobacz oryginalny rozmiar okładki PNG (1672×941)
Najpierw sprawdź, czy można ich użyć: trzy modele nie startują z tego samego miejsca
| Model | Oficjalna data premiery | Kto może go używać na dzień 30 września | Co to oznacza dla zwykłego czytelnika |
|---|---|---|---|
| Gemini 4 Argon | 30.09.2026 | Najpierw udostępniony zaufanym obrońcom cyberbezpieczeństwa i testerom w ramach projektu Google Fairwind; szersze udostępnienie dla deweloperów, firm i konsumentów ma nastąpić w późniejszych etapach | To, że dziś widzisz „premierę”, nie oznacza, że Twoje konto Gemini lub API może już wybrać Argon |
| GPT-6 Astra | 03.09.2026 | Udostępniany etapami płatnym użytkownikom ChatGPT i użytkownikom API; konkretny limit zależy od planu i konta | Możesz sprawdzić swoją listę modeli i limity użycia oraz od razu rozpocząć realne zadania |
| Claude Fable 5.1 | 01.09.2026 | Dostępny w płatnych planach Claude i Claude API, ale plany takie jak Pro mogą wymagać dodatkowych kredytów użycia | Najpierw sprawdź zasady korzystania z Fable w swoim planie, a potem zdecyduj, czy uaktualnić plan lub zapłacić dodatkowo |
Ogłoszenie Google o Gemini 4 Argon wyjaśnia, że obecnie jest to ograniczony dostęp, a w przyszłości planowane jest rozszerzenie począwszy od płatnych użytkowników API i subskrybentów Google AI Ultra; nie podano konkretnej daty, od której zwykli użytkownicy będą mogli z niego korzystać. Ogłoszenie OpenAI o Astra i opis Fable 5.1 od Anthropic opisują obecny zakres dostępności. Astra w tym artykule to model OpenAI, a nie projekt badawczy Google Project Astra.
Porównanie parametrów: nie mieszaj „ile może przeczytać” z „ile może napisać”
Okno kontekstu wejściowego określa, ile materiału można przekazać modelowi za jednym razem; maksymalne wyjście określa, ile treści może wygenerować maksymalnie w jednym przebiegu. Tych liczb nie można stosować wymiennie ani na ich podstawie samodzielnie oceniać jakości odpowiedzi. Poniższe informacje dotyczą konkretnych modeli zweryfikowanych 30 września 2026 r., a nie ogólnych specyfikacji całych rodzin Gemini, GPT lub Claude.
| Parametr | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Okno kontekstu wejściowego | Oficjalny limit nie został ogłoszony | 1 050 000 tokenów | 1 000 000 tokenów |
| Maksymalne wyjście jednorazowe | Google w ogłoszeniu podaje 1 000 000 tokenów; zwykli użytkownicy nie mogą jeszcze tego zweryfikować | 128 000 tokenów | 128 000 tokenów |
| Dane wejściowe, które można przekazać modelowi | Ogłoszenie prezentuje multimodalność i rozumienie długich filmów, ale pełna lista typów danych wejściowych API nie została ogłoszona | Tekst, obrazy | Tekst, obrazy |
| Obecne oficjalne wejście | Zaufani testerzy Fairwind; termin szerokiego udostępnienia nie został ogłoszony | Płatne konta ChatGPT zgodnie z harmonogramem wdrożenia i planem, OpenAI API | Płatne produkty Claude i Claude API; plany takie jak Pro mają dodatkowe warunki dotyczące kredytów użycia |
Źródła: ogłoszenie Google o Gemini 4 Argon, strona modelu GPT-6 Astra od OpenAI, strona modelu Claude Fable 5.1 od Anthropic i opis planów Anthropic. „1 milion” w ogłoszeniu Google odnosi się do limitu wyjścia i nie można go traktować jako ogłoszonego przez Argon „1-milionowego okna kontekstu wejściowego”. Pełna publiczna karta modelu Argon i testy zwykłych użytkowników wciąż czekają na publikację; „nie ogłoszono” w tabeli nie oznacza „brak tej możliwości”.
Powyższa tabela porównuje publiczne specyfikacje, a nie rozstrzyga o wydajności: im więcej treści się zmieści, tym niekoniecznie odpowiedź jest dokładniejsza. Dopiero poniższa tabela zawiera wyniki benchmarków wydajności.
Porównanie oficjalnych wyników: patrz na konkretne zadania, nie wyłaniaj „zwycięzcy ogólnego”
Google DeepMind opublikował na oficjalnej stronie modelu Gemini 4 Argon tabelę wyników czterech modeli. Tutaj wyodrębniono tylko trzy kolumny omawiane w tym artykule: Argon, GPT-6 Astra i Claude Fable 5.1; oryginalna tabela obejmuje także Claude Opus 5.5. Poniższe wyniki pochodzą z rzeczywiście odczytanej 30 września 2026 r. o 23:42 UTC oficjalnej strony Google, zostały zebrane przez Google i nie są testami PandaNpc w tych samych warunkach. Poza wierszami oznaczonymi jako F1, odsetek sukcesu lub wynik częściowy wartości zachowują procenty z oryginalnej tabeli; w każdym wierszu pogrubiono wyższą wartość tylko spośród tych trzech modeli. „—” oznacza, że w oryginalnej tabeli nie ma porównywalnego wyniku, a nie 0 punktów.
| Grupa możliwości | Benchmark (test) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Praca z wiedzą | Vals Index | 68,9% | 63,1% | 65,8% |
| Praca z wiedzą | AutomationBench | 51,3% | 41,4% | 31,4% |
| Praca z wiedzą | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% |
| Praca z wiedzą | Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 6,7% |
| Automatyczne programowanie | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% |
| Automatyczne programowanie | FrontierSWE v2 | 55,0% | 65,5% | 56,3% |
| Automatyczne programowanie | Vibe Code Bench | 91,9% | 89,6% | 90,3% |
| Automatyczne programowanie | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% |
| Inżynieria uczenia maszynowego | PostTrainBench | 45,3% | 44,3% | 40,2% |
| Nauka i matematyka | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% |
| Nauka i matematyka | LABBench 2 | 88,8% | 85,4% | 68,6% |
| Nauka i matematyka | RiemannBench | 76,0% | 72,0% | 65,6% |
| Długie teksty | GraphWalks (≤128K, BFS F1) | 99,7% | 98,7% | 91,4% |
| Długie teksty | GraphWalks (256K–1M, BFS F1) | 84,2% | 71,8% | 65,0% |
| Obsługa komputera | Agent's Last Exam (odsetek sukcesu) | 39,5% | 34,2% | — |
| Obsługa komputera | OSWorld-2.0 (podzbiór offline, wynik częściowy) | 69,2% | 72,6% | — |
| Rozumienie obrazu i tekstu | Chartography | 71,6% | 71,0% | 46,2% |
| Rozumienie wideo | LVBench | 91,7% | 87,5% | 79,7% |
| Bezpieczeństwo defensywne | CWE-bench v1 | 68,0% | 68,0% | 58,0% |
Jak korzystać z tej tabeli? Jeśli zajmujesz się pracą z wiedzą, najpierw spójrz na Vals Index i Finance Agent; jeśli piszesz kod, patrz jednocześnie na DeepSWE, FrontierSWE i Terminal-bench, nie wybieraj tylko jednego wiersza: Argon prowadzi w DeepSWE, ale Astra ma wyższe wyniki w FrontierSWE i Terminal-bench. W przypadku obsługi komputera zachowaj szczególną ostrożność: dwa wiersze dotyczące Fable w tej tabeli Google są brakujące, ale nie oznacza to, że nie potrafi obsługiwać komputera. CWE-bench pokazuje, że Argon i Astra są ex aequo wśród tych trzech; to również nie jest gwarancją wyników w realnej pracy związanej z bezpieczeństwem.
Metodyka testów: W opisie metodologii oceny Google podaje, że wyniki Argon zazwyczaj pochodzą z jednej próby i najwyższego poziomu rozumowania; dane innych modeli często pochodzą od dostawców lub publicznych rankingów i mogą wykorzystywać ich najwyższy lub dostępny poziom rozumowania. Część testów przeprowadził sam Google, część pochodzi od stron trzecich; środowiska narzędziowe i metody próbkowania nie są wszędzie takie same. Na przykład wyniki Argon w DeepSWE i Terminal-bench pochodzą z testów Google, a dla innych modeli użyto publicznych wyników; w LVBench liczba klatek wideo próbkowanych dla różnych modeli jest różna. Wiersz GraphWalks używa BFS F1, a wiersz OSWorld reprezentuje tylko „wynik częściowy” podzbioru offline. Nie można uśredniać wyników między wierszami ani na tej podstawie twierdzić, że któryś model jest kompleksowo pierwszy w jednolitych warunkach testowych. Strona wyników tego PDF z metodologią zawiera dodatkowo zapis „stan na październik 2026 r.”, co nie zgadza się z czasem odczytania tabeli w tym artykule 30 września; nie udało się potwierdzić dokładnej daty ukończenia oceny. W tym artykule jedynie przepisano wyniki widoczne wówczas na oficjalnej stronie; nie wnioskujemy, kiedy ocena została ukończona, ani nie przedstawiamy ich jako wyników przez nas odtworzonych.
Jak porównywać ceny: opłaty miesięczne i koszty API należy rozdzielić
Jeśli chcesz korzystać z modelu tylko w produkcie czatowym lub narzędziu do programowania, najpierw spójrz na subskrypcję i limity użycia. W publicznych cenach w USA ChatGPT Plus kosztuje $20/mies., a Pro ma progi $100, $200, $500/mies. itd.; konkretne zużycie Astra zależy od planu i zadania. Opis cen i zużycia ChatGPT Work/Codex od OpenAI wyraźnie ostrzega: ceny API za milion tokenów nie służą do szacowania, ile zadań można wykonać w ramach subskrypcji.
Miesięczna cena Claude Pro w USA wynosi $20, a Max zaczyna się od $100/mies. (oficjalny cennik Claude). Jednak to, że „Pro może wybrać Fable 5.1”, nie oznacza, że Fable jest objęty zwykłym limitem Pro: zasady planów dla Fable od Anthropic wyjaśniają, że korzystanie z Fable 5.1 w Pro i standardowych stanowiskach Team wymaga dodatkowych kredytów użycia; Max i stanowiska premium mogą korzystać z niego w ramach części tygodniowego limitu. Google nie podał jeszcze rzeczywistej ceny subskrypcji ani daty udostępnienia Argon dla zwykłych użytkowników; obecnej miesięcznej opłaty Google AI Ultra nie można traktować jako ceny „kupna Argon już dziś”.
Jeśli korzystasz z API i płacisz za użycie, dopiero poniżej znajdują się standardowe ceny tekstowe, które można czytać w tych samych jednostkach. Wejście oznacza treść przekazywaną modelowi do przeczytania, a wyjście — odpowiedź, którą generuje. Wszystkie jednostki to cena w USD za 1 milion tokenów (token to jednostka, na którą przy rozliczaniu dzieli się tekst i inne treści); Argon w tabeli to przyszła cena premiery ogłoszona przez Google, a nie rzeczywisty rachunek, który dziś zapłaciliśmy.
| Model | Zwykłe wejście | Zwykłe wyjście | Odczyt z pamięci podręcznej dla powtarzających się treści | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Planowana cena premiery $2; po okresie promocyjnym $4 | Planowana cena premiery $10; po okresie promocyjnym $20 | Google podaje, że w okresie premiery wejście z pamięci podręcznej jest o 95% tańsze od zwykłego wejścia; konkretne zasady po premierze do weryfikacji | Jeszcze nie jest szeroko dostępny |
| GPT-6 Astra | $10 | $50 | $1 | Obecna standardowa cena API |
| Claude Fable 5.1 | $10 | $50 | $0,25 | Obecna standardowa cena API |
Dane pochodzą z ogłoszenia Google o premierze Argon, strony cen modelu Astra od OpenAI i strony modelu Fable 5.1 od Anthropic. Ceny nie obejmują dodatkowych narzędzi, regionów, poziomów szybkości ani różnic platformowych; w przypadku Astra, gdy pojedyncze wejście przekracza 272K tokenów, dla całego żądania cena wejścia i pamięci podręcznej jest mnożona przez 2, a wyjścia przez 1,5. Cena pamięci podręcznej dotyczy tylko treści, które rzeczywiście trafiły do pamięci podręcznej; nie można szacować całego zadania według ceny cache. Nawet jeśli planowana cena jednostkowa Argon jest niższa niż dwóch pozostałych, bez danych o odsetku sukcesu i zużyciu w tych samych zadaniach nie można twierdzić, że wykonanie zadania jest w nim najtańsze.
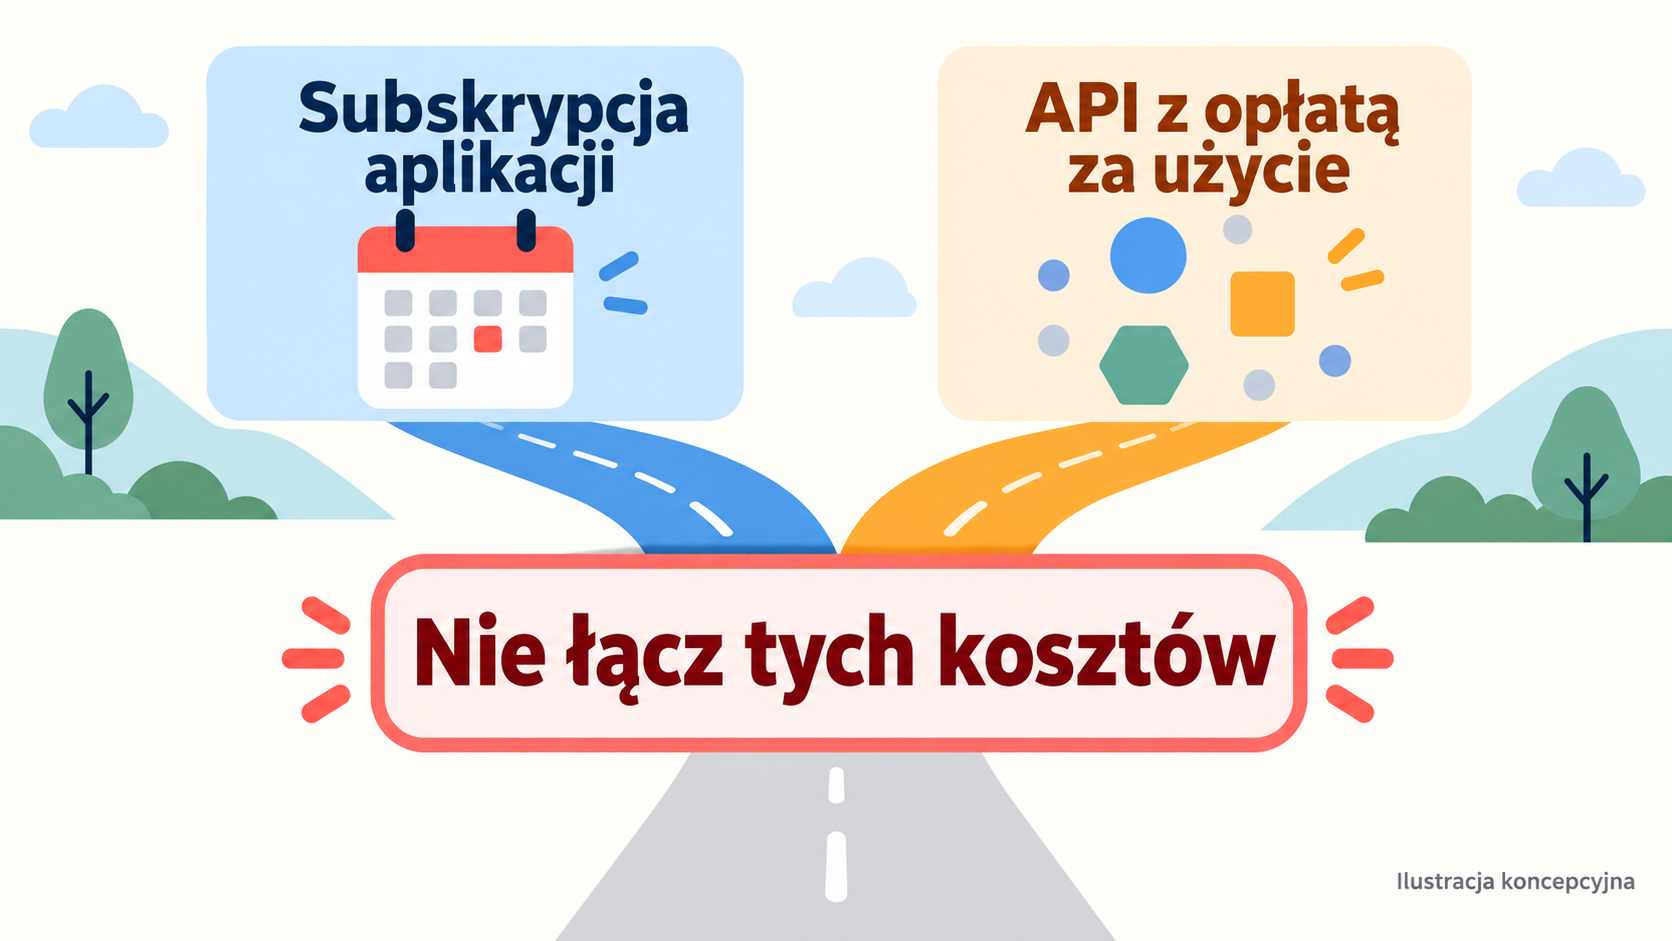
Rysunek: wygenerowany przez AI schemat sposobu rozliczania, nie jest rachunkiem za produkt; miesięcznej opłaty subskrypcji nie można mieszać z ceną jednostkową API. Zobacz obraz w oryginalnym rozmiarze (1672×941).

Jak wybrać według zadania? Najpierw użyj modeli, które masz pod ręką
Zadanie wymaga pracy w wielu programach albo przeglądania stron, obsługi interfejsu i złożonego osądu: najpierw wypróbuj GPT-6 Astra. OpenAI wymienia obsługę komputera, przeglądanie, trudne programowanie i profesjonalne dokumenty jako jego kluczowe możliwości. Jeśli masz już odpowiednie płatne konto ChatGPT lub dostęp do API, już dziś możesz zlecić mu realne zadanie i sprawdzić, czy wynik spełnia wymagania. Opis modelu OpenAI.
Zadanie to kilkugodzinne programowanie, przegląd kodu lub praca z dużymi dokumentami: najpierw wypróbuj Claude Fable 5.1. Anthropic pozycjonuje go do długotrwałych zadań autonomicznych, złożonego programowania i badań. Osoby, które mają już workflow Claude Code, mogą najpierw korzystać z oswojonych narzędzi, ale powinny najpierw sprawdzić, czy plan nie pobiera dodatkowych kredytów użycia; jeśli codziennie wykonują wiele takich zadań, niech porównają rzeczywisty koszt Max i API. Opis modelu Anthropic.
Chcesz wypróbować Gemini 4 Argon: najpierw sprawdź, czy masz oficjalny dostęp. Google ogłosił kierunki obejmujące złożone programowanie, korporacyjną pracę z wiedzą i zadania bezpieczeństwa defensywnego oraz podał planowane ceny; warto je obserwować, ale nie zastępują one rzeczywistych doświadczeń zwykłych użytkowników. Bez dostępu nie zaleca się zmieniania działającego workflow z powodu „przewidywanej niższej ceny” Argon. Oficjalne ogłoszenie Google.
Te zalecenia nie oznaczają, że „skoro model jest dobry w jednym typie zadań, nadaje się tylko do niego”. Jeśli w przyszłości wszystkie trzy będą dostępne, najbezpieczniejszą metodą wyboru jest: wziąć to samo realne zadanie, dać te same materiały i kryteria odbioru, a następnie oddzielnie zapisać, czy zostało ukończone, ile było ręcznych poprawek, ile zajęło czasu i ile łącznie kosztowało. Jedna efektowna demonstracja lub wyniki benchmarków poszczególnych dostawców nie dowodzą bezpośrednio, że Twoje zadanie również da taki sam rezultat.
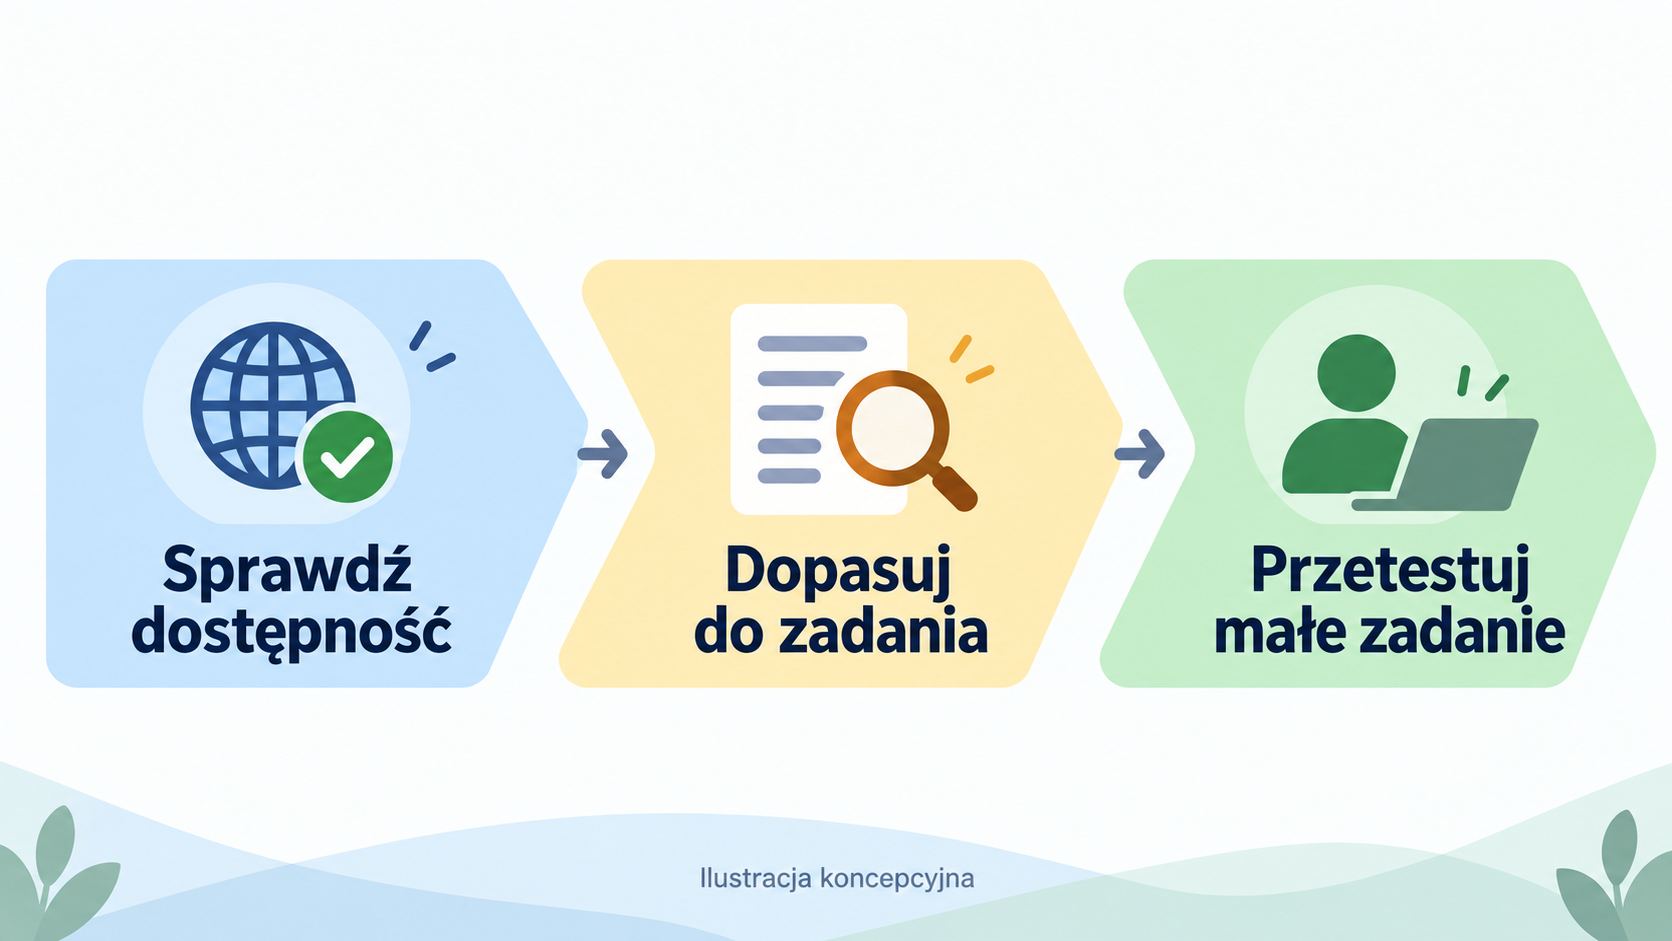
Rysunek: wygenerowany przez AI schemat ścieżki wyboru — najpierw sprawdź dostępność konta i regionu, potem potrzeby zadania, a na końcu zweryfikuj na własnym małym zadaniu. „W tym artykule nie przeprowadzono żadnych testów porównawczych” na rysunku oznacza, że nie uruchomiliśmy samodzielnie testów w tych samych warunkach; powyższa tabela wyników to transkrypcja danych opublikowanych przez Google. Zobacz obraz w oryginalnym rozmiarze (1672×941).

Jeśli Twoim zadaniem jest podział pracy między dwóch asystentów do programowania, zobacz samouczek współpracy Claude Code i Codex; jeśli chcesz przekazać konkretny problem na zalogowaną stronę ChatGPT Pro, zobacz samouczek Codex i Claude Code o pomoc do ChatGPT Pro. Te dwa artykuły opisują działania w workflow i nie oznaczają, że Gemini 4 Argon został podłączony do PandaNpc.
Często zadawane pytania (FAQ)
Gemini 4 Argon został już oficjalnie wydany, dlaczego nie mogę go znaleźć?
„Premiera” oznacza, że Google ogłosił model i udostępnił go w ograniczonym zakresie; oficjalne ogłoszenie nie podaje jeszcze jednolitej daty udostępnienia dla wszystkich deweloperów i zwykłych konsumentów. Najpierw sprawdź oficjalną listę modeli w używanym produkcie Gemini i na swoim koncie; nie traktuj krążącego w plotkach „Gemini 4 Pro” jako dostępnego wejścia do Argon.
Czy Astra to Google Project Astra?
Nie. GPT-6 Astra w tym artykule to model OpenAI; Google Project Astra to inny projekt badawczy i nie można go mieszać w tabeli cen trzech modeli.
Czy mając subskrypcję Claude Pro, mogę używać Fable 5.1 w ramach limitu planu?
Nie zawsze. Obecny opis planów Anthropic wskazuje, że korzystanie z Fable 5.1 w Pro wymaga kredytów użycia, a niektóre plany, takie jak Max, mogą korzystać z niego w ramach ograniczonego tygodniowego limitu. Przed zapłatą sprawdź swoją stronę „zużycie/kredyty”.
Czy na podstawie powyższych cen można od razu stwierdzić, który jest najbardziej opłacalny?
Nie. Tabela API porównuje tylko ceny katalogowe; na wykonanie zadania wpływają także długość wejścia, trafienia powtarzających się treści w pamięć podręczną, koszty narzędzi, liczba rund i poprawki. Zwłaszcza Argon nie jest jeszcze szeroko dostępny, więc nie możemy podać własnego „kosztu na udane zadanie”.
Powiązane przewodniki

GPT-6 Sol vs Claude Opus 5.5: ceny, wyniki i jak wybrać do zadań programistycznych?
Najpierw wypróbuj GPT-6 Sol do ogólnych zadań programistycznych API; w przypadku złożonych zadań możesz porównać Claude Opus 5.5, a GPT-6 Astra i Claude Fable 5.1 potraktować jako opcje dla najtrudniejszych przypadków. W tym artykule weryfikujemy oficjalne specyfikacje czterech modeli, ceny cache'owania i Batch, wyniki benchmarków firm trzecich według jednolitej metodologii oraz przedstawiamy pięć możliwych do ponownego przeliczenia scenariuszy kosztowych.
Przeczytaj artykuł →
Claude Code vs Codex: funkcje, zdalna kontrola, uprawnienia i przypadki użycia — jak wybrać (2026)
W skrócie: Claude Code do zaawansowanej pracy w terminalu, Hooks i ekosystemu Claude; Codex do ChatGPT, zadań w chmurze i wielu Agent; PandaNpc do zdalnego sterowania oboma na Windows, macOS, Linux i telefonie.
Przeczytaj artykuł →
Jak używać ChatGPT Pro z Codex i Claude Code w PandaNpc
W rozmowie Codex lub Claude Code w PandaNpc można przekazać konkretne pytanie do zalogowanej strony internetowej ChatGPT Pro, a odpowiedź wróci do pierwotnej rozmowy.
Przeczytaj artykuł →