
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 – wie wählen? Vergleich von Verfügbarkeit, Preis und Einsatzszenarien
Gemini 4 Argon: begrenzt verfügbar; wähle nach Aufgabe und Tarif GPT-6 Astra oder Claude Fable 5.1, API-Preise separat von Abos, laut offiziellen Daten, kein Test unter gleichen Bedingungen.
Quellenprüfung: 30. September 2026 (UTC). PandaNpc bietet AI-Agent-Dienste an, was für die Modellauswahl relevant ist. Dieser Artikel fasst öffentlich verfügbare Informationen der drei Unternehmen zusammen und gibt Empfehlungen für die Auswahl je nach Aufgabe; wir haben noch keinen Testzugang zu Gemini 4 Argon erhalten und haben keine Vergleichstests der drei Modelle unter gleichen Bedingungen durchgeführt. „Geeignet“ im Folgenden bezieht sich auf die offizielle Positionierung und die aktuelle Verfügbarkeit und bedeutet nicht, dass wir gemessen hätten, welches Modell stärker ist.
Zuerst das Fazit: Wenn Sie es heute nutzen müssen, wählen Sie zunächst zwischen GPT-6 Astra und Claude Fable 5.1 je nach Aufgabe und vorhandenem Tarif; Gemini 4 Argon ist derzeit nur für eine kleine Zahl vertrauenswürdiger Tester geöffnet, normale Nutzer können es noch nicht als jederzeit wählbare dritte Option betrachten. Für softwareübergreifende Bedienung, komplexe Materialaufbereitung oder anspruchsvolle Programmierung können Sie zuerst Astra ausprobieren; für langfristige Programmierung, wiederholtes Lesen großer Projekte oder komplexer Dokumente können Sie zuerst Fable 5.1 ausprobieren. Wenn Argon allgemein verfügbar ist, vergleichen Sie mit denselben Aufgaben die tatsächliche Ergebnisqualität und die Gesamtkosten.
Cover in Originalgröße als PNG ansehen (1672×941)
Zuerst die Verfügbarkeit prüfen: Die drei Modelle starten nicht von derselben Ausgangslinie
| Modell | Offizielles Veröffentlichungsdatum | Wer kann es bis zum 30. September nutzen | Was bedeutet das für normale Leser |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Zunächst für vertrauenswürdige Cyber-Verteidiger und Tester des Google-Fairwind-Projekts geöffnet; die breite Öffnung für Entwickler, Unternehmen und Verbraucher steht noch in späteren Phasen aus | Dass heute „veröffentlicht“ zu sehen ist, bedeutet nicht, dass Ihr Gemini-Konto oder API Argon bereits auswählen kann |
| GPT-6 Astra | 2026-09-03 | Wird für zahlende ChatGPT-Nutzer und API-Nutzer schrittweise eingeführt; das konkrete verfügbare Kontingent hängt vom Tarif und Konto ab | Sie können Ihre Modellliste und Ihr Nutzungskontingent prüfen und sofort mit echten Aufgaben beginnen |
| Claude Fable 5.1 | 2026-09-01 | In kostenpflichtigen Claude-Tarifen und über die Claude API verfügbar, aber Tarife wie Pro können zusätzliche usage credits erfordern | Prüfen Sie zuerst die Fable-Nutzungsregeln Ihres Tarifs und entscheiden Sie dann, ob Sie upgraden oder separat bezahlen |
Googles Gemini 4 Argon-Ankündigung gibt an, dass derzeit eine kleine Öffnung stattfindet und künftig eine Ausweitung beginnend mit zahlenden API-Nutzern und Google AI Ultra-Abonnenten geplant ist; ein konkreter Termin, ab dem normale Nutzer es verwenden können, wurde nicht veröffentlicht. OpenAIs Astra-Ankündigung und Anthropics Fable 5.1-Erklärung beschreiben jeweils den derzeitigen Verfügbarkeitsbereich. Das Astra hier ist ein OpenAI-Modell, nicht Googles Project Astra-Forschungsprojekt.
Parametervergleich: „Wie viel es lesen kann“ und „wie viel es schreiben kann“ nicht verwechseln
Das Eingabe-Kontextfenster gibt an, wie viele Materialien man dem Modell auf einmal übergeben kann; die maximale Ausgabe gibt an, wie viel Inhalt es in einem Durchgang höchstens erzeugen kann. Diese beiden Zahlen sind nicht austauschbar, und allein anhand der Zahlen lässt sich die Antwortqualität nicht beurteilen. Alle folgenden Informationen beziehen sich auf die am 30. September 2026 geprüften konkreten Modellvarianten, nicht auf allgemeine Spezifikationen der gesamten Gemini-, GPT- oder Claude-Familien.
| Parameter | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Eingabe-Kontextfenster | Offizielles Limit nicht veröffentlicht | 1.050.000 Token | 1.000.000 Token |
| Maximale Ausgabe pro Durchgang | Google-Ankündigung nennt 1.000.000 Token; normale Nutzer können dies noch nicht verifizieren | 128.000 Token | 128.000 Token |
| An das Modell übergebbare Eingaben | Die Ankündigung zeigt Multimodalität und Verständnis langer Videos, aber die vollständige Liste der API-Eingabetypen wurde nicht veröffentlicht | Text, Bilder | Text, Bilder |
| Aktueller offizieller Zugang | Fairwind-vertrauenswürdige Tester; Zeitpunkt der breiten Öffnung nicht veröffentlicht | ChatGPT-Zahlungskonten je nach Einführungsfortschritt und Tarif, OpenAI API | Kostenpflichtige Claude-Produkte und Claude API; Tarife wie Pro haben zusätzliche Guthabenbedingungen |
Quellen: Googles Gemini 4 Argon-Ankündigung, OpenAIs GPT-6 Astra-Modellseite, Anthropics Claude Fable 5.1-Modellseite und Anthropics Tarifbeschreibung. Die „1 Million“ in Googles Ankündigung bezieht sich auf das Ausgabelimit und darf nicht als bereits veröffentlichtes „1-Million-Eingabe-Kontextfenster“ von Argon verstanden werden. Die vollständige öffentliche Modellkarte von Argon und Praxistests normaler Nutzer stehen noch aus; „nicht veröffentlicht“ in der Tabelle bedeutet nicht „diese Fähigkeit existiert nicht“.
Die obige Tabelle vergleicht öffentliche Spezifikationen, nicht den Sieger bei der Leistung: Mehr aufnehmbarer Inhalt bedeutet nicht unbedingt genauere Antworten. Die folgende Tabelle zeigt die Benchmark-Ergebnisse zur Leistung.
Vergleich offizieller Benchmarks: konkrete Aufgaben ansehen, nicht den „Gesamtsieger“ ausrechnen
Google DeepMind hat auf der offiziellen Gemini 4 Argon-Modellseite eine Benchmark-Tabelle mit vier Modellen veröffentlicht. Hier werden nur die drei Spalten Argon, GPT-6 Astra und Claude Fable 5.1 herausgegriffen, die in diesem Artikel behandelt werden; die Originaltabelle enthält außerdem Claude Opus 5.5. Die folgenden Ergebnisse stammen von der Google-Webseite, die am 30. September 2026 um 23:42 UTC tatsächlich gelesen wurde, wurden von Google zusammengestellt und sind keine Vergleichstests von PandaNpc unter gleichen Bedingungen. Außer bei Zeilen, die F1, Bestehensrate oder Teilpunkte angeben, werden die Prozentwerte aus der Originaltabelle übernommen; in jeder Zeile wird nur unter diesen drei Modellen der höhere Wert fett gedruckt. „—“ bedeutet, dass die Originaltabelle kein vergleichbares Ergebnis enthält, nicht 0 Punkte.
| Fähigkeitsgruppe | Benchmark (Testaufgabe) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Wissensarbeit | Vals Index | 68,9% | 63,1% | 65,8% |
| Wissensarbeit | AutomationBench | 51,3% | 41,4% | 31,4% |
| Wissensarbeit | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% |
| Wissensarbeit | Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 6,7% |
| Automatische Programmierung | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% |
| Automatische Programmierung | FrontierSWE v2 | 55,0% | 65,5% | 56,3% |
| Automatische Programmierung | Vibe Code Bench | 91,9% | 89,6% | 90,3% |
| Automatische Programmierung | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% |
| Machine-Learning-Engineering | PostTrainBench | 45,3% | 44,3% | 40,2% |
| Wissenschaft und Mathematik | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% |
| Wissenschaft und Mathematik | LABBench 2 | 88,8% | 85,4% | 68,6% |
| Wissenschaft und Mathematik | RiemannBench | 76,0% | 72,0% | 65,6% |
| Langtext | GraphWalks (≤128K, BFS F1) | 99,7% | 98,7% | 91,4% |
| Langtext | GraphWalks (256K–1M, BFS F1) | 84,2% | 71,8% | 65,0% |
| Computerbedienung | Agent's Last Exam (Bestehensrate) | 39,5% | 34,2% | — |
| Computerbedienung | OSWorld-2.0 (Offline-Teilmenge, Teilpunkte) | 69,2% | 72,6% | — |
| Bild- und Textverständnis | Chartography | 71,6% | 71,0% | 46,2% |
| Videoverständnis | LVBench | 91,7% | 87,5% | 79,7% |
| Defensive Sicherheit | CWE-bench v1 | 68,0% | 68,0% | 58,0% |
Wie verwendet man diese Tabelle? Wenn Sie Wissensarbeit machen, schauen Sie zuerst auf Vals Index und Finance Agent; beim Programmieren können Sie zugleich DeepSWE, FrontierSWE und Terminal-bench betrachten und nicht nur eine Zeile herausgreifen: Argon führt bei DeepSWE, aber Astra ist bei FrontierSWE und Terminal-bench höher. Bei Computerbedienung ist besondere Vorsicht geboten: Bei Fable sind die beiden Zeilen in dieser Google-Tabelle nicht vorhanden, deshalb kann man nicht sagen, dass es keine Computer bedienen kann. CWE-bench zeigt, dass Argon und Astra unter den dreien gleichauf liegen; das ist auch keine Garantie für echte Sicherheitsarbeit.
Testmethodik: Googles Beschreibung der Evaluierungsmethodik gibt an, dass Argons Ergebnisse üblicherweise auf einem einzelnen Versuch und der höchsten Denkstufe basieren; die Daten anderer Modelle stammen meist aus Selbstauskünften der Anbieter oder öffentlichen Ranglisten und können ebenfalls deren höchste oder verfügbare Denkstufe verwenden. Einige Projekte wurden von Google selbst durchgeführt, andere stammen von Dritten; Werkzeugumgebung und Sampling-Methoden sind nicht überall gleich. Beispielsweise sind die Argon-Ergebnisse bei DeepSWE und Terminal-bench von Google selbst gemessen, während für andere Modelle öffentliche Ergebnisse verwendet werden; bei LVBench werden für verschiedene Modelle unterschiedlich viele Videoframes extrahiert. Die GraphWalks-Zeile verwendet BFS F1, die OSWorld-Zeile repräsentiert nur „Teilpunkte“ der Offline-Teilmenge. Man darf nicht über Zeilen hinweg mitteln und darf daraus keinen Gesamtsieger unter einheitlichen Testbedingungen ableiten. Die Ergebnisseite dieses Methodik-PDFs nennt außerdem „Stand Oktober 2026“, was nicht mit dem Zeitpunkt übereinstimmt, zu dem die Tabelle in diesem Artikel am 30. September gelesen wurde; das konkrete Abschlussdatum der Evaluierung konnte nicht bestätigt werden. Dieser Artikel gibt nur die damals auf der offiziellen Website sichtbaren Ergebnisse wieder, leitet nicht ab, wann die Evaluierung abgeschlossen wurde, und bezeichnet sie nicht als von uns reproduzierte Ergebnisse.
Wie vergleicht man Preise: Monatsgebühren und API-Kosten müssen getrennt betrachtet werden
Wenn Sie es nur in einem Chat-Produkt oder Programmierwerkzeug verwenden möchten, schauen Sie zuerst auf Abonnement und Nutzungskontingent. Bei den öffentlichen US-Preisen kostet ChatGPT Plus 20 $/Monat, Pro ist in Stufen wie 100 $, 200 $, 500 $/Monat unterteilt; der konkrete Astra-Verbrauch variiert je nach Tarif und Aufgabe. OpenAIs Preis- und Nutzungshinweise zu ChatGPT Work/Codex weisen ausdrücklich darauf hin: Die API-Preise pro 1 Million Token können nicht verwendet werden, um abzuschätzen, wie viele Aufgaben innerhalb eines Abonnements erledigt werden können.
Claude Pro kostet in den USA 20 $/Monat, Max beginnt bei 100 $/Monat (offizielle Claude-Preistabelle). Aber „Pro kann Fable 5.1 auswählen“ bedeutet nicht, dass Fable im regulären Pro-Kontingent enthalten ist: Anthropics Fable-Tarifregeln erklären, dass Pro- und Team-Standardplätze für die Nutzung von Fable 5.1 zusätzliche usage credits benötigen; Max und Premium-Plätze können es im Rahmen eines Teils des wöchentlichen Kontingents nutzen. Google hat noch keine tatsächlichen Abonnementpreise oder ein Öffnungsdatum für die Nutzung von Argon durch normale Nutzer genannt; die aktuellen Monatsgebühren von Google AI Ultra dürfen nicht als Angebot für „Argon heute kaufen“ verstanden werden.
Wenn Sie über die API nach Nutzung bezahlen, sind die folgenden Standardtextpreise diejenigen, die in derselben Einheit gelesen werden können. Eingabe bezeichnet den Inhalt, den Sie das Modell lesen lassen, Ausgabe die von ihm erzeugte Antwort. Die Einheit ist jeweils der Dollarpreis pro 1 Million Token (Token ist die Einheit, in die Text und andere Inhalte bei der Abrechnung zerlegt werden); Argon in der Tabelle ist der von Google veröffentlichte künftige Einführungspreis, keine von uns heute bereits gezahlte tatsächliche Rechnung.
| Modell | Normale Eingabe | Normale Ausgabe | Cache-Lesen wiederholter Inhalte | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Geplanter Startpreis 2 $; nach Aktionszeitraum 4 $ | Geplanter Startpreis 10 $; nach Aktionszeitraum 20 $ | Google zufolge 95 % Rabatt auf Cache-Eingabe zum normalen Eingabepreis beim Start; konkrete Regeln zur Einführung noch zu prüfen | Noch nicht breit verfügbar |
| GPT-6 Astra | 10 $ | 50 $ | 1 $ | Aktueller API-Standardpreis |
| Claude Fable 5.1 | 10 $ | 50 $ | 0,25 $ | Aktueller API-Standardpreis |
Daten stammen aus Googles Argon-Ankündigung, OpenAIs Astra-Modellpreisseite und Anthropics Fable 5.1-Modellseite. Die Preise enthalten keine zusätzlichen Werkzeuge, Regionen, Geschwindigkeitsstufen oder Plattformunterschiede; bei Astra wird bei einer Eingabe von mehr als 272K Token für die gesamte Anfrage der Eingabe- und Cache-Preis mit dem 2-fachen und die Ausgabe mit dem 1,5-fachen berechnet. Der Cache-Preis gilt nur für tatsächlich im Cache gefundene Inhalte; man kann nicht die gesamte Aufgabe zum Cache-Preis schätzen. Selbst wenn Argons geplanter Stückpreis niedriger als bei den beiden anderen liegt, kann man ohne Daten zu Erfolgsrate und Verbrauch bei derselben Aufgabe nicht behaupten, dass es eine Aufgabe am günstigsten erledigt.
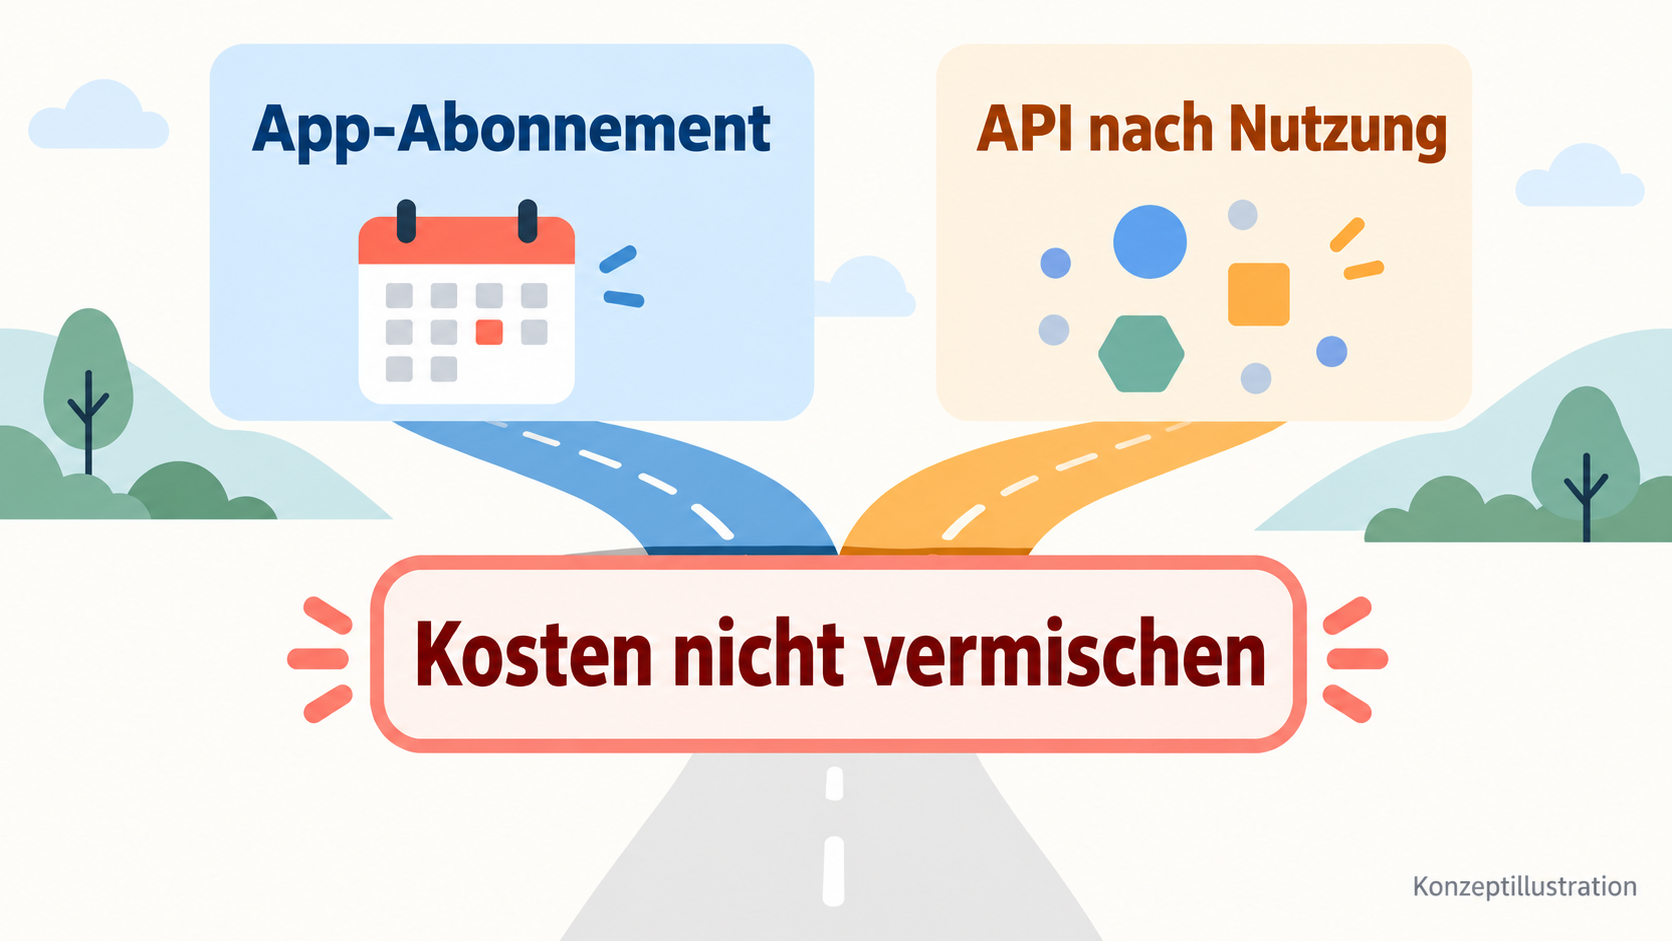
Abbildung: Von KI erzeugte Skizze der Abrechnungsmaßstäbe, keine Produktrechnung; Monatsgebühren für Abonnements dürfen nicht mit API-Stückpreisen vermischt berechnet werden. Originalbild ansehen (1672×941).

Wie wählt man je nach Aufgabe? Zuerst die Modelle verwenden, die man bereits zur Hand hat
Wenn die Aufgabe mehrere Programme umfasst oder Webbrowsing, Bedienung von Oberflächen und komplexe Entscheidungen erfordert: Probieren Sie zuerst GPT-6 Astra. OpenAI nennt Computerbedienung, Browsing, anspruchsvolle Programmierung und professionelle Dokumente als seine Schwerpunktfähigkeiten. Wenn Sie bereits ein geeignetes kostenpflichtiges ChatGPT-Konto oder API-Zugriff haben, können Sie ihm heute eine echte Aufgabe übergeben und sehen, ob das Ergebnis den Anforderungen entspricht. OpenAI-Modellbeschreibung.
Wenn die Aufgabe mehrstündige Programmierung, Code-Review oder Arbeit an großen Dokumenten ist: Probieren Sie zuerst Claude Fable 5.1. Anthropic positioniert es für lang andauernde autonome Aufgaben, komplexe Programmierung und Forschung. Wer bereits einen Claude Code-Workflow hat, kann zunächst die vertrauten Werkzeuge weiterverwenden, sollte aber zuerst prüfen, ob der Tarif zusätzliche Nutzungsguthaben abzieht; wenn täglich viele solcher Aufgaben laufen, vergleichen Sie anschließend die tatsächlichen Kosten von Max und API. Anthropic-Modellbeschreibung.
Wenn Sie Gemini 4 Argon ausprobieren möchten: Prüfen Sie zuerst, ob Sie offiziellen Zugriff erhalten haben. Die von Google genannten Richtungen umfassen komplexe Programmierung, Unternehmenswissensarbeit und defensive Sicherheitsaufgaben, und es wurden geplante Preise genannt; das ist beachtenswert, kann aber die Praxiserfahrung normaler Nutzer noch nicht ersetzen. Wenn Sie keinen Zugriff haben, wird nicht empfohlen, wegen Argons „voraussichtlich günstigerem“ Preis einen laufenden Workflow zu ändern. Googles offizielle Ankündigung.
Diese Empfehlungen bedeuten nicht, dass ein Modell, das bei einer Aufgabengattung stark ist, nur diese eine Art ausführen kann. Wenn alle drei künftig verfügbar sind, ist die sicherste Auswahlmethode: Nehmen Sie dieselbe echte Aufgabe, geben Sie dieselben Materialien und Abnahmekriterien und erfassen Sie getrennt, ob sie erledigt wurde, manuelle Nacharbeit, Zeitaufwand und Gesamtkosten. Eine einmalige schöne Demo oder die jeweiligen Benchmarks verschiedener Anbieter können nicht direkt beweisen, dass Ihre Aufgabe dasselbe Ergebnis erzielt.
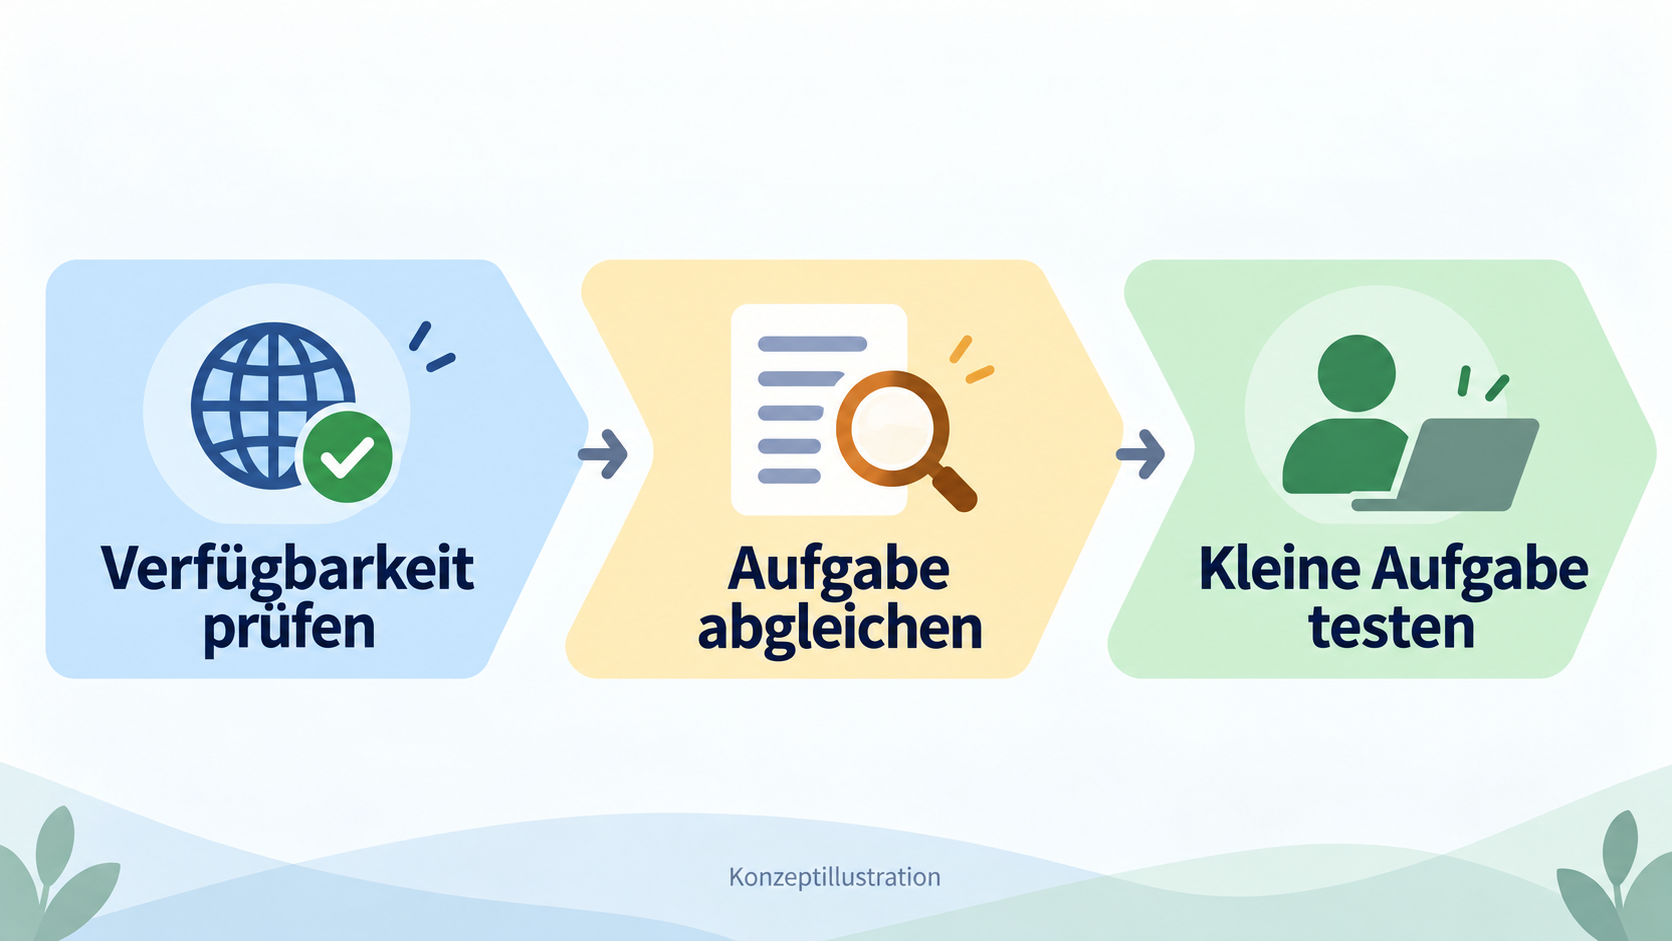
Abbildung: Von KI erzeugte Skizze des Auswahlpfads: zuerst Konto- und Regionsverfügbarkeit prüfen, dann Aufgabenbedarf betrachten, schließlich mit einer eigenen kleinen Aufgabe verifizieren. „In diesem Artikel werden keine Vergleichstests durchgeführt“ in der Abbildung bedeutet, dass wir keine Vergleichstests unter gleichen Bedingungen selbst ausgeführt haben; die obige Benchmark-Tabelle gibt die von Google veröffentlichten Daten wieder. Originalbild ansehen (1672×941).

Wenn Ihre Aufgabe darin besteht, zwei Programmierassistenten aufzuteilen, lesen Sie Tutorial zur Zusammenarbeit von Claude Code und Codex; wenn Sie eine konkrete Frage an eine bereits angemeldete ChatGPT Pro-Seite übergeben möchten, lesen Sie Tutorial: Codex und Claude Code fragen ChatGPT Pro um Hilfe. Diese beiden Artikel beschreiben Workflow-Abläufe und bedeuten nicht, dass Gemini 4 Argon in PandaNpc integriert ist.
FAQ
Gemini 4 Argon wurde offiziell veröffentlicht, warum finde ich es nicht?
„Veröffentlicht“ bedeutet, dass Google das Modell angekündigt und für einen begrenzten Umfang geöffnet hat; die offizielle Ankündigung nennt noch kein einheitliches Öffnungsdatum für alle Entwickler und normalen Verbraucher. Prüfen Sie zuerst die offizielle Modellliste Ihres verwendeten Gemini-Produkts und Kontos und halten Sie das gerüchteweise genannte „Gemini 4 Pro“ nicht für den verfügbaren Zugang zu Argon.
Ist Astra Googles Project Astra?
Nein. Das GPT-6 Astra in diesem Artikel ist ein OpenAI-Modell; Google Project Astra ist ein anderes Forschungsprojekt und darf nicht in die Preistabelle der drei Modelle eingemischt werden.
Kann ich Fable 5.1 im Tarifkontingent nutzen, wenn ich Claude Pro abonniert habe?
Nicht unbedingt. Anthropics aktuelle Tarifbeschreibung gibt an, dass Pro für die Nutzung von Fable 5.1 usage credits benötigt, während einige Tarife wie Max es im Rahmen eines begrenzten wöchentlichen Kontingents nutzen können. Prüfen Sie vor der Zahlung Ihre Seite „Nutzung/Guthaben“.
Kann man anhand der obigen Preise direkt entscheiden, welches am günstigsten ist?
Nein. Die API-Tabelle vergleicht nur Listenpreise; die Erledigung einer Aufgabe wird außerdem von Eingabelänge, ob wiederholte Inhalte den Cache treffen, Werkzeugkosten, Anzahl der Ausführungsrunden und Nacharbeit beeinflusst. Insbesondere Argon ist noch nicht breit verfügbar, sodass wir keine eigenen „Kosten pro erfolgreicher Aufgabe“ angeben können.
Verwandte Anleitungen

GPT-6 Sol vs Claude Opus 5.5: Preis, Benchmarks und Programmieraufgaben – wie wählen?
Für allgemeine API-Programmieraufgaben sollten Sie zuerst GPT-6 Sol ausprobieren; bei komplexen Aufgaben können Sie Claude Opus 5.5 vergleichen und anschließend GPT-6 Astra sowie Claude Fable 5.1 als Optionen für hohe Schwierigkeitsgrade heranziehen. Dieser Artikel prüft die offiziellen Spezifikationen der vier Modelle, Cache- und Batch-Preise sowie Third-Party-Benchmark-Ergebnisse nach einheitlichem Maßstab und bietet fünf nachrechenbare Kostenszenarien.
Artikel lesen →
Claude Code vs. Codex: Welcher Coding-Agent passt zu dir? (2026)
Kurz gesagt: Claude Code für tiefen Terminalzugriff, Hooks und das Claude-Ökosystem; Codex für ChatGPT, Cloud-Aufgaben und Multi-Agent; PandaNpc zur Fernsteuerung beider Systeme auf Windows, macOS, Linux und Mobilgeräten.
Artikel lesen →
ChatGPT Pro mit Codex und Claude Code in PandaNpc nutzen
In einer Codex- oder Claude Code-Konversation bei PandaNpc kann man eine konkrete Frage an die angemeldete ChatGPT Pro-Webseite übergeben, und die Antwort kehrt in die ursprüngliche Konversation zurück.
Artikel lesen →