
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1: como escolher? Comparação de disponibilidade, preços e casos de uso
Dados oficiais, não teste padrão: Gemini 4 Argon tem acesso limitado; para os disponíveis GPT-6 Astra e Claude Fable 5.1, escolha por tarefa e plano, com preços de API fora das assinaturas.
Verificação de informações: 30 de setembro de 2026 (UTC). PandaNpc oferece serviços de AI Agent, relacionados à escolha de modelos. Este artigo reúne informações públicas das três empresas e apresenta recomendações de escolha por tarefa; ainda não obtivemos acesso de teste ao Gemini 4 Argon, não fizemos testes comparativos dos três modelos sob as mesmas condições. O termo "adequado" abaixo refere-se ao posicionamento oficial e à disponibilidade atual, e não significa que medimos qual é mais forte.
Conclusão primeiro: se você precisa usar hoje, escolha primeiro entre GPT-6 Astra e Claude Fable 5.1 de acordo com a tarefa e o plano atual; o Gemini 4 Argon está aberto no momento apenas para um pequeno número de testadores confiáveis, e usuários comuns ainda não podem tratá-lo como uma terceira opção sempre disponível. Para operações entre softwares, organização de materiais complexos ou programação difícil, você pode testar o Astra primeiro; para programação de longo prazo, leitura repetida de projetos grandes ou documentos complexos, pode testar o Fable 5.1 primeiro. Quando o Argon for amplamente disponibilizado, compare a qualidade real de conclusão e o custo total usando a mesma tarefa.
Ver PNG da capa em tamanho original (1672×941)
Primeiro, veja se dá para usar: os três modelos não estão na mesma linha de partida
| Modelo | Data de lançamento oficial | Quem pode usar até 30 de setembro | O que isso significa para o leitor comum |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Aberto primeiro a defensores e testadores confiáveis de segurança cibernética do projeto Google Fairwind; a ampla disponibilização para desenvolvedores, empresas e consumidores ainda depende de fases posteriores | Ver "lançado" hoje não significa que sua conta Gemini ou API já possa selecionar o Argon |
| GPT-6 Astra | 2026-09-03 | Já lançado em fases para usuários pagos do ChatGPT e usuários de API; a cota específica disponível depende do plano e da conta | Você pode verificar sua lista de modelos e cota de uso e começar tarefas reais imediatamente |
| Claude Fable 5.1 | 2026-09-01 | Disponível nos planos pagos do Claude e na Claude API, mas planos como o Pro podem exigir créditos de uso adicionais | Verifique primeiro as regras de uso do Fable no seu plano antes de decidir se faz upgrade ou paga à parte |
O anúncio do Gemini 4 Argon do Google informa que no momento a disponibilização é em pequena escala e que o plano futuro é expandir começando por usuários pagos de API e assinantes do Google AI Ultra; não foi divulgada uma data definida para uso por usuários comuns. O anúncio do Astra da OpenAI e a explicação do Fable 5.1 da Anthropic descrevem, respectivamente, o escopo de disponibilidade atual. O Astra aqui é um modelo da OpenAI, não o projeto de pesquisa Project Astra do Google.
Comparação de parâmetros: não confunda "quanto consegue ler" com "quanto consegue escrever"
Janela de contexto de entrada é quanta informação pode ser entregue ao modelo de uma vez; saída máxima é quanto conteúdo ele pode gerar no máximo de uma vez. Esses dois números não são intercambiáveis, e não se pode julgar a qualidade da resposta apenas pelos números. As informações abaixo são de modelos específicos verificadas em 30 de setembro de 2026, e não especificações genéricas de toda a família Gemini, GPT ou Claude.
| Parâmetro | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Janela de contexto de entrada | Limite oficial não divulgado | 1.050.000 token | 1.000.000 token |
| Saída máxima por vez | O anúncio do Google afirma 1.000.000 token; usuários comuns ainda não podem verificar | 128.000 token | 128.000 token |
| Entradas que podem ser fornecidas ao modelo | O anúncio mostra compreensão multimodal e de vídeos longos, mas a lista completa de tipos de entrada da API não foi divulgada | Texto, imagens | Texto, imagens |
| Entrada oficial atual | Testadores confiáveis do Fairwind; data de ampla disponibilização não divulgada | Contas pagas do ChatGPT conforme o cronograma de lançamento e o plano, OpenAI API | Produtos pagos do Claude e Claude API; planos como Pro têm condições de créditos adicionais |
Fontes: anúncio do Gemini 4 Argon do Google, página do modelo GPT-6 Astra da OpenAI, página do modelo Claude Fable 5.1 da Anthropic e explicação de planos da Anthropic. O "1 milhão" no anúncio do Google refere-se ao limite de saída, e não pode ser tomado como se o Argon já tivesse divulgado "janela de contexto de entrada de 1 milhão". A ficha pública completa do modelo Argon e testes de usuários comuns ainda aguardam publicação; "não divulgado" na tabela não significa "não tem essa capacidade".
A tabela acima compara especificações públicas, não vitórias de desempenho: quanto mais conteúdo cabe, não necessariamente mais precisa será a resposta. A tabela abaixo é que traz resultados de benchmarks de desempenho.
Comparação de benchmarks oficiais: olhe tarefas específicas, não calcule um "campeão geral"
O Google DeepMind publicou uma tabela de benchmarks de quatro modelos na página oficial do modelo Gemini 4 Argon. Aqui extraímos apenas as três colunas discutidas neste artigo: Argon, GPT-6 Astra e Claude Fable 5.1; a tabela original também inclui Claude Opus 5.5. Os resultados abaixo vêm da página oficial do Google efetivamente lida em 30 de setembro de 2026, 23:42 UTC, compilados pelo Google, e não são testes do PandaNpc sob as mesmas condições. Exceto nas linhas que indicam F1, taxa de aprovação ou pontuação parcial, os valores seguem as porcentagens da tabela original; em cada linha, apenas o valor mais alto entre esses três modelos foi colocado em negrito. "—" indica que a tabela original não tem resultado comparável, não que seja 0 ponto.
| Grupo de capacidade | Benchmark (item de teste) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Trabalho de conhecimento | Vals Index | 68,9% | 63,1% | 65,8% |
| Trabalho de conhecimento | AutomationBench | 51,3% | 41,4% | 31,4% |
| Trabalho de conhecimento | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% |
| Trabalho de conhecimento | Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 6,7% |
| Programação automática | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% |
| Programação automática | FrontierSWE v2 | 55,0% | 65,5% | 56,3% |
| Programação automática | Vibe Code Bench | 91,9% | 89,6% | 90,3% |
| Programação automática | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% |
| Engenharia de aprendizado de máquina | PostTrainBench | 45,3% | 44,3% | 40,2% |
| Ciência e matemática | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% |
| Ciência e matemática | LABBench 2 | 88,8% | 85,4% | 68,6% |
| Ciência e matemática | RiemannBench | 76,0% | 72,0% | 65,6% |
| Texto longo | GraphWalks (≤128K, BFS F1) | 99,7% | 98,7% | 91,4% |
| Texto longo | GraphWalks (256K–1M, BFS F1) | 84,2% | 71,8% | 65,0% |
| Operação de computador | Agent's Last Exam (taxa de aprovação) | 39,5% | 34,2% | — |
| Operação de computador | OSWorld-2.0 (subconjunto offline, pontuação parcial) | 69,2% | 72,6% | — |
| Compreensão de imagens e texto | Chartography | 71,6% | 71,0% | 46,2% |
| Compreensão de vídeo | LVBench | 91,7% | 87,5% | 79,7% |
| Segurança defensiva | CWE-bench v1 | 68,0% | 68,0% | 58,0% |
Como usar esta tabela? Se você faz trabalho de conhecimento, pode começar por Vals Index, Finance Agent; para escrever código, veja ao mesmo tempo DeepSWE, FrontierSWE e Terminal-bench, não escolha apenas uma linha: o Argon lidera no DeepSWE, mas o Astra é maior no FrontierSWE e no Terminal-bench. Para operação de computador, preste atenção especial: as duas linhas do Fable nesta tabela do Google estão ausentes, e isso não significa que ele não saiba operar um computador. O CWE-bench mostra que Argon e Astra estão empatados entre os três; isso também não é uma garantia para trabalho real de segurança.
Critérios de teste: A explicação de metodologia de avaliação do Google afirma que os resultados do Argon geralmente são de uma única tentativa e no nível máximo de raciocínio; os dados dos outros modelos vêm em grande parte de autodeclarações dos fornecedores ou rankings públicos, e também podem usar seus respectivos níveis máximos ou disponíveis de raciocínio. Alguns projetos foram executados pelo próprio Google, outros vieram de terceiros, e o ambiente de ferramentas e os métodos de amostragem não são iguais em todos os casos. Por exemplo, os resultados do Argon no DeepSWE e no Terminal-bench são testes próprios do Google, enquanto os outros modelos usam resultados públicos; o LVBench extraiu números diferentes de quadros de vídeo para modelos diferentes. A linha GraphWalks usa BFS F1, e a linha OSWorld representa apenas a "pontuação parcial" do subconjunto offline. Não se pode tirar média entre linhas nem declarar com base nisso um primeiro lugar geral sob condições de teste unificadas. A página de resultados desse PDF de metodologia ainda diz "até outubro de 2026", o que não coincide com o momento em que lemos a tabela em 30 de setembro neste artigo; a data específica de conclusão das avaliações não pôde ser confirmada. Este artigo apenas transcreve os resultados visíveis no site oficial naquele momento, não infere quando as avaliações foram concluídas nem os apresenta como resultados que nós reproduzimos.
Como comparar preços: mensalidade e custos de API devem ser separados
Se você só quer usar em um produto de chat ou ferramenta de programação, veja primeiro a assinatura e a cota de uso. Nos preços públicos dos EUA, o ChatGPT Plus é $20/mês, e o Pro é dividido em faixas como $100, $200 e $500/mês; o uso específico do Astra varia conforme o plano e a tarefa. A explicação de preços e uso do ChatGPT Work/Codex da OpenAI alerta explicitamente: o preço da API por milhão de tokens não pode ser usado para estimar quantas tarefas podem ser concluídas dentro da assinatura.
O preço mensal do Claude Pro nos EUA é $20, e o Max começa em $100/mês (tabela oficial de preços do Claude). Mas "o Pro pode selecionar Fable 5.1" não significa que o Fable esteja incluído na cota normal do Pro: as regras de planos do Fable da Anthropic explicam que o uso do Fable 5.1 no Pro e em assentos padrão do Team exige créditos de uso adicionais; o Max e assentos avançados podem usá-lo dentro de parte da cota semanal. O Google ainda não informou o preço real de assinatura nem a data de disponibilização do Argon para usuários comuns, e não se pode tomar a mensalidade atual do Google AI Ultra como cotação para "comprar Argon hoje".
Se você paga por uso via API, a seguir está a cotação padrão de texto que pode ser lida na mesma unidade. Entrada refere-se ao conteúdo que você entrega ao modelo para leitura, e saída refere-se à resposta que ele gera. A unidade é o preço em dólares por 1 milhão de tokens (token é a unidade usada para dividir textos e outros conteúdos na cobrança); o Argon na tabela é o preço futuro de lançamento divulgado pelo Google, não uma fatura real que já pagamos hoje.
| Modelo | Entrada normal | Saída normal | Leitura de cache de conteúdo repetido | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Preço inicial proposto $2; após o período promocional $4 | Preço inicial proposto $10; após o período promocional $20 | Google afirma que a entrada em cache no lançamento tem 95% de desconto sobre o preço de entrada normal; regras específicas de lançamento a confirmar | Ainda não amplamente disponível |
| GPT-6 Astra | $10 | $50 | $1 | Preço padrão atual da API |
| Claude Fable 5.1 | $10 | $50 | $0.25 | Preço padrão atual da API |
Dados de anúncio de lançamento do Argon do Google, página de preços do modelo Astra da OpenAI e página do modelo Fable 5.1 da Anthropic. Os preços não incluem ferramentas adicionais, região, faixas de velocidade ou diferenças de plataforma; quando o Astra tem entrada única acima de 272K tokens, a requisição inteira tem o preço de entrada e cache multiplicado por 2 e a saída por 1,5. O preço de cache só se aplica ao conteúdo que realmente acerta o cache, e não se pode estimar a tarefa inteira pelo preço de cache. Mesmo que o preço unitário proposto do Argon seja menor que o dos outros dois, sem dados de taxa de sucesso na mesma tarefa e de uso, não se pode afirmar que ele é o mais barato para concluir uma tarefa.
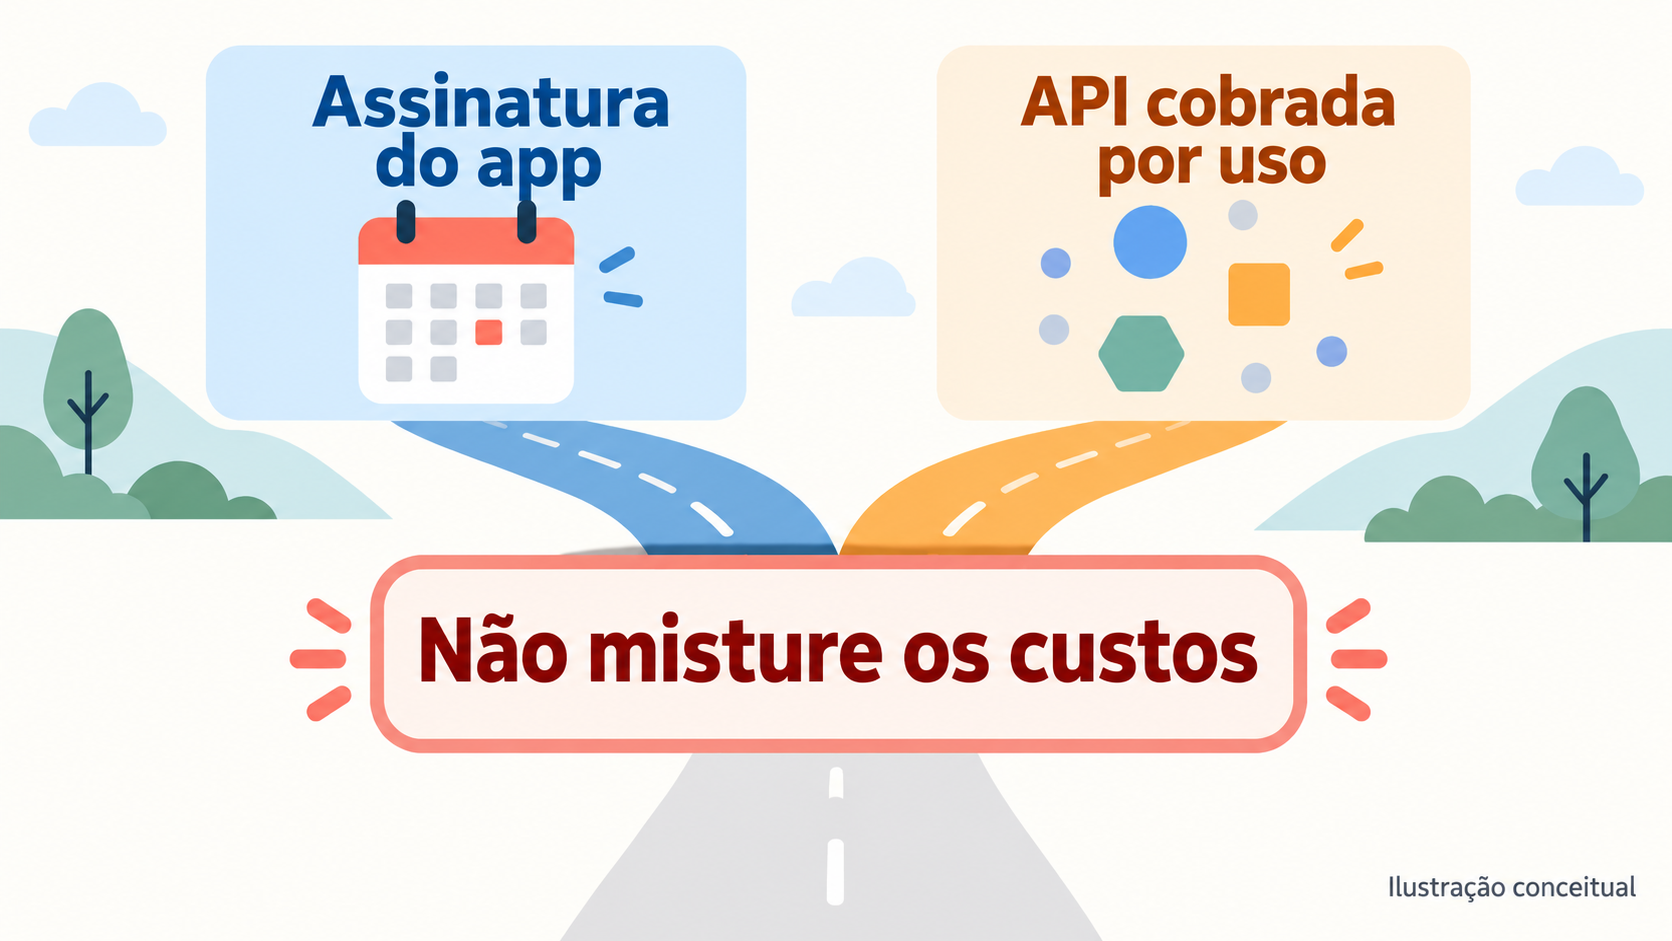
Figura: ilustração gerada por IA sobre critérios de cobrança, não é uma fatura de produto; mensalidade de assinatura não pode ser misturada com preço unitário de API. Ver imagem em tamanho original (1672×941).

Como escolher por tarefa? Use primeiro os modelos disponíveis em mãos
Se a tarefa envolve vários softwares ou exige navegar na web, operar interfaces e fazer julgamentos complexos: teste primeiro o GPT-6 Astra. A OpenAI lista operação de computador, navegação, programação difícil e documentos profissionais como capacidades centrais dele. Se você já tem uma conta paga adequada do ChatGPT ou permissão de API, hoje mesmo pode entregar uma tarefa real a ele e ver se o resultado atende aos requisitos. Explicação do modelo da OpenAI.
Se a tarefa é programação, revisão de código ou trabalho com documentos grandes que dura horas: teste primeiro o Claude Fable 5.1. A Anthropic o posiciona para tarefas autônomas de longa duração, programação complexa e pesquisa. Quem já tem um fluxo de trabalho com Claude Code pode continuar usando as ferramentas familiares, mas deve confirmar primeiro se o plano desconta créditos de uso adicionais; se for executar muitas tarefas desse tipo todos os dias, compare o custo real do Max e da API. Explicação do modelo da Anthropic.
Quer experimentar o Gemini 4 Argon: confirme primeiro se você obteve acesso oficial. As direções divulgadas pelo Google incluem programação complexa, trabalho de conhecimento empresarial e tarefas de segurança defensiva, e também foi apresentado um preço proposto; isso merece atenção, mas ainda não substitui a experiência prática de usuários comuns. Sem permissão, não é recomendável mudar um fluxo de trabalho em andamento por causa da "expectativa de ser mais barato" do Argon. Anúncio oficial do Google.
Essas recomendações não significam que "se um modelo é bom em um tipo de tarefa, ele só pode fazer esse tipo". Se os três estiverem disponíveis no futuro, o método de escolha mais seguro é: pegue a mesma tarefa real, forneça os mesmos materiais e critérios de aceitação, e registre separadamente se foi concluída, retrabalho manual, tempo gasto e custo total. Uma demonstração bonita ou os benchmarks de cada fornecedor não provam diretamente que sua tarefa terá o mesmo resultado.
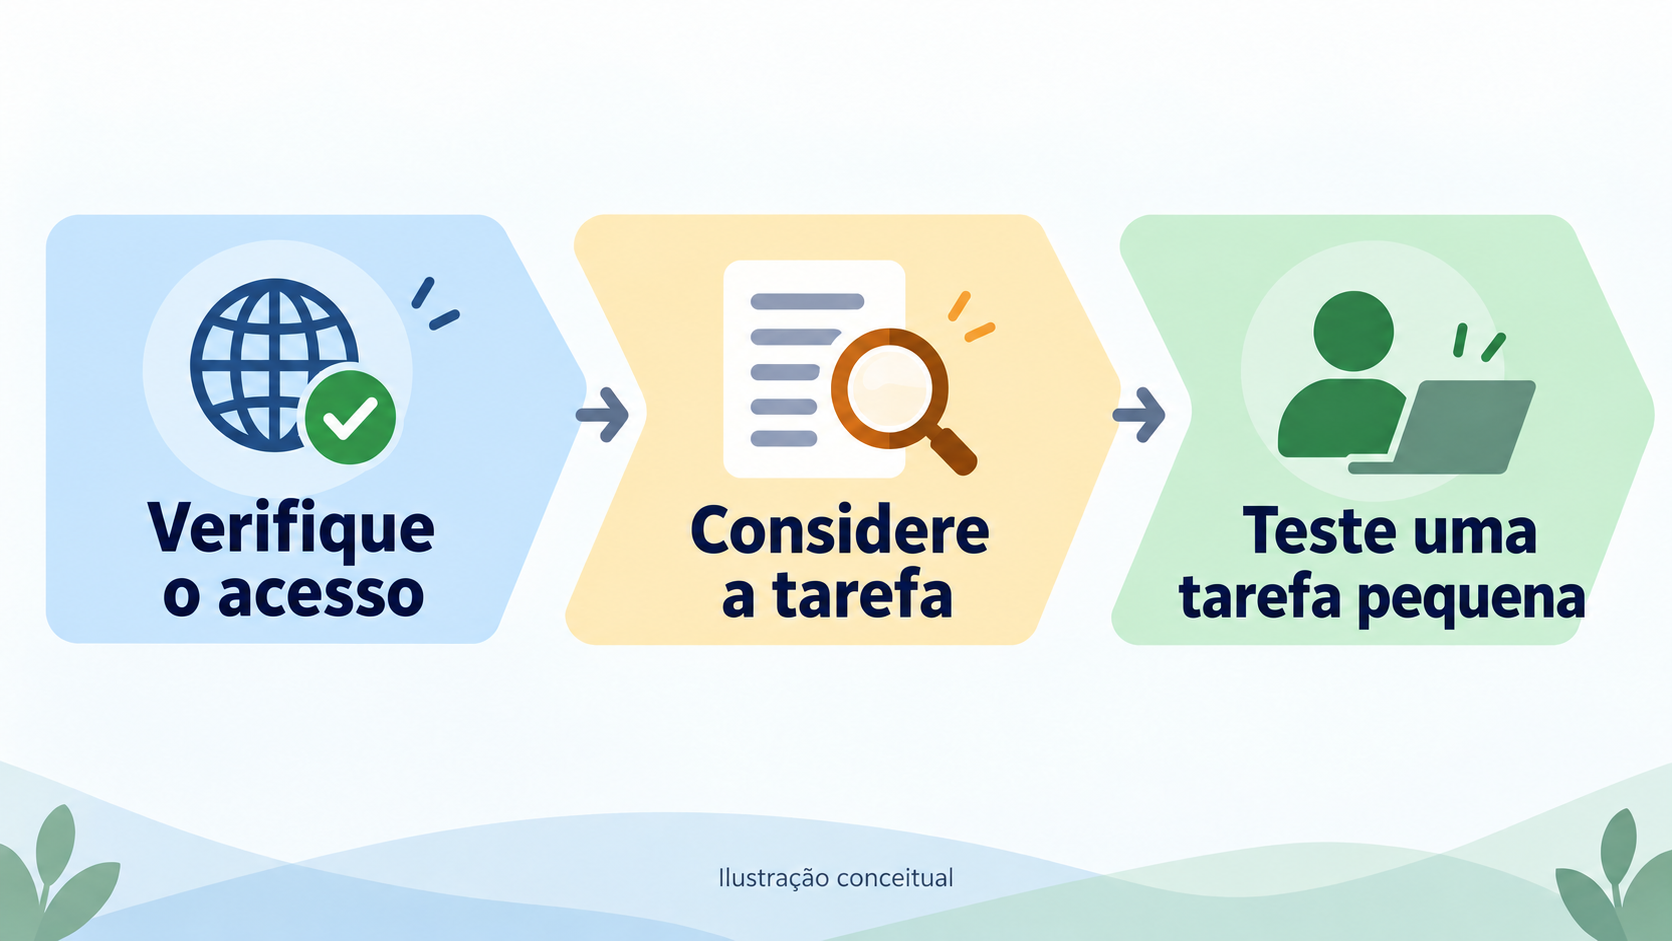
Figura: ilustração gerada por IA do caminho de escolha, primeiro veja a disponibilidade da conta e da região, depois as necessidades da tarefa, e por fim valide com sua própria tarefa pequena. O texto "este artigo não realiza nenhum teste comparativo" na figura significa que não executamos testes sob as mesmas condições por conta própria; a tabela de benchmarks acima transcreve dados divulgados pelo Google. Ver imagem em tamanho original (1672×941).

Se sua tarefa é fazer dois assistentes de programação dividirem o trabalho, veja o tutorial de colaboração entre Claude Code e Codex; se você quer enviar uma pergunta específica para a página já logada do ChatGPT Pro, veja o tutorial de Codex e Claude Code pedindo ajuda ao ChatGPT Pro. Esses dois artigos apresentam operações de fluxo de trabalho e não significam que o Gemini 4 Argon já esteja integrado ao PandaNpc.
FAQ
O Gemini 4 Argon já foi lançado oficialmente, por que não consigo encontrá-lo?
"Lançamento" significa que o Google divulgou o modelo e o abriu para um escopo limitado; o anúncio oficial ainda não forneceu uma data unificada de disponibilização para todos os desenvolvedores e consumidores comuns. Verifique primeiro a lista oficial de modelos do produto Gemini e da conta que você usa, e não trate o suposto "Gemini 4 Pro" como entrada disponível para o Argon.
O Astra é o Project Astra do Google?
Não. O GPT-6 Astra neste artigo é um modelo da OpenAI; o Google Project Astra é outro projeto de pesquisa e não pode ser misturado na tabela de preços dos três modelos.
Assinando o Claude Pro, posso usar o Fable 5.1 dentro da cota do plano?
Não necessariamente. A explicação atual de planos da Anthropic indica que o Pro precisa de créditos de uso para usar o Fable 5.1, enquanto alguns planos como o Max podem usá-lo dentro de uma cota semanal limitada. Antes de pagar, veja sua página de "uso/créditos".
Dá para determinar diretamente qual é o mais vantajoso com base nos preços acima?
Não. A tabela de API compara apenas preços de tabela; ao concluir uma tarefa, também influenciam o comprimento da entrada, se conteúdo repetido acerta o cache, custos de ferramentas, número de rodadas de execução e retrabalho. Em especial, o Argon ainda não está amplamente disponível, então não podemos apresentar nosso próprio "custo por tarefa bem-sucedida".
Guias relacionados

GPT-6 Sol vs Claude Opus 5.5: preços, benchmarks e como escolher para tarefas de programação?
Para tarefas gerais de programação via API, experimente primeiro o GPT-6 Sol; para tarefas complexas, compare com o Claude Opus 5.5 e use o GPT-6 Astra e o Claude Fable 5.1 como opções de alta dificuldade. Este artigo verifica as especificações oficiais dos quatro modelos, os preços de cache e Batch, benchmarks de terceiros com a mesma metodologia e fornece cinco cenários de custo recalculáveis.
Ler artigo →
Claude Code vs Codex: como escolher entre funcionalidades, controle remoto, permissões e casos de uso (2026)
Resumo: Claude Code para terminal avançado, Hooks e ecossistema Claude; Codex para ChatGPT, tarefas na nuvem e vários Agent; PandaNpc para controlar ambos remotamente no Windows, macOS, Linux e celular.
Ler artigo →
Como usar o ChatGPT Pro com Codex e Claude Code no PandaNpc
Em uma conversa do Codex ou do Claude Code no PandaNpc, é possível enviar uma pergunta específica para a página web do ChatGPT Pro com login feito, e a resposta retorna à conversa original.
Ler artigo →