
Gemini 4 Argon, GPT-6 Astra eller Claude Fable 5.1 – hur väljer man? Jämförelse av tillgänglighet, pris och användningsområden
Gemini 4 Argon har begränsad åtkomst; välj nu tillgängliga GPT-6 Astra eller Claude Fable 5.1 per uppgift/plan, med officiella data, API-priser separat från abonnemang, ej samma testvillkor.
Faktakontroll: 30 september 2026 (UTC). PandaNpc tillhandahåller AI Agent-tjänster, vilket är relevant för modellval. Den här artikeln sammanställer offentlig information från de tre företagen och ger råd om val utifrån uppgift; vi har ännu inte fått tillgång att prova Gemini 4 Argon och har inte gjort någon jämförande testning av de tre modellerna under samma förutsättningar. "Lämplig" nedan avser officiell positionering och aktuell tillgänglighet och betyder inte att vi har mätt vem som är starkast.
Först slutsatsen: om du behöver använda något i dag, välj i första hand mellan GPT-6 Astra och Claude Fable 5.1 utifrån uppgift och befintligt abonnemang; Gemini 4 Argon är för närvarande endast öppen för ett litet antal betrodda testare, och vanliga användare kan ännu inte räkna det som ett tredje alternativ som alltid är tillgängligt. För arbete över flera programvaror, komplex materialhantering eller avancerad programmering kan du först prova Astra; för långvarig programmering, upprepad läsning av stora projekt eller komplexa dokument kan du först prova Fable 5.1. När Argon blir allmänt tillgänglig kan du jämföra faktisk kvalitet och total kostnad med samma uppgifter.
Visa omslagsbild i originalstorlek PNG (1672×941)
Börja med att se om de går att använda: de tre modellerna har inte samma startlinje
| Modell | Officiellt releasedatum | Vem kan använda den per 30 september | Vad det betyder för vanliga läsare |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Först till Googles Fairwind-projekts betrodda nätverksförsvarare och testare; bredare tillgänglighet för utvecklare, företag och konsumenter väntar på senare faser | Att se "släppt" i dag betyder inte att ditt Gemini-konto eller API redan kan välja Argon |
| GPT-6 Astra | 2026-09-03 | Har rullats ut stegvis till ChatGPT-betalande användare och API-användare; exakt tillgänglig kvot beror på abonnemang och konto | Du kan kontrollera din modellista och användningskvot och börja med verkliga uppgifter direkt |
| Claude Fable 5.1 | 2026-09-01 | Tillgänglig i Claudes betalabonnemang och Claude API, men abonnemang som Pro kan kräva extra användningskrediter | Kontrollera först reglerna för Fable i ditt abonnemang innan du bestämmer om du ska uppgradera eller betala separat |
Googles meddelande om Gemini 4 Argon anger att den för närvarande är öppen i liten skala, och att planen framöver är att utöka med början hos betalande API-användare och Google AI Ultra-prenumeranter; inget bestämt datum har offentliggjorts för när vanliga användare kan använda den. OpenAI:s Astra-meddelande och Anthropics beskrivning av Fable 5.1 beskriver sina respektive nuvarande tillgänglighetsomfattningar. Astra här är en OpenAI-modell, inte Googles Project Astra-forskningsprojekt.
Parameterjämförelse: blanda inte ihop "hur mycket den kan läsa" med "hur mycket den kan skriva"
Indatakontextfönster är hur mycket material som kan ges till modellen vid ett tillfälle; maximal utdata är hur mycket innehåll den högst kan generera i en omgång. Dessa två siffror kan inte bytas ut mot varandra, och man kan inte bedöma svarskvalitet enbart utifrån siffror. Allt nedan gäller information om specifika modellversioner verifierad den 30 september 2026, inte generella specifikationer för hela Gemini-, GPT- eller Claude-familjerna.
| Parameter | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Indatakontextfönster | Officiell övre gräns ej publicerad | 1 050 000 token | 1 000 000 token |
| Maximal utdata per gång | Googles meddelande anger 1 000 000 token; vanliga användare kan ännu inte verifiera | 128 000 token | 128 000 token |
| Indata som kan ges till modellen | Meddelandet visar multimodal och lång video-förståelse, men den fullständiga listan över API-indatatyper är inte publicerad | Text, bilder | Text, bilder |
| Nuvarande officiella ingång | Fairwind betrodda testare; tid för bred tillgänglighet ej publicerad | ChatGPT-betalda konton beroende på utrullningstakt och abonnemang, OpenAI API | Claude betalprodukter och Claude API; abonnemang som Pro har villkor för extra användningskrediter |
Källor: Googles meddelande om Gemini 4 Argon, OpenAI:s modellsida för GPT-6 Astra, Anthropics modellsida för Claude Fable 5.1 och Anthropics abonnemangsbeskrivning. Googles "1 miljon" i meddelandet avser utdatagränsen och får inte tolkas som att Argon har offentliggjort ett "indatakontextfönster på 1 miljon". Argons fullständiga offentliga modellkort och tester av vanliga användare återstår att publicera; "ej publicerad" i tabellen betyder inte "saknar förmågan".
Tabellen ovan jämför offentliga specifikationer, inte vem som vinner på prestanda: mer innehåll som får plats innebär inte nödvändigtvis mer korrekta svar. Tabellen nedan visar prestandariktmärken.
Jämförelse av officiella benchmarkresultat: titta på specifika uppgifter, utse ingen "totalsegrare"
Google DeepMind publicerade en benchmarktabell för fyra modeller på Gemini 4 Argons officiella modellsida. Här plockar vi endast ut de tre kolumnerna för Argon, GPT-6 Astra och Claude Fable 5.1 som diskuteras i den här artikeln; originaltabellen innehåller även Claude Opus 5.5. Resultaten nedan kommer från Googles officiella webbsida så som den lästes den 30 september 2026 kl. 23:42 UTC, sammanställda av Google, inte en jämförande testning under samma förutsättningar utförd av PandaNpc. Om inget annat anges för rader med F1, godkännandegrad eller delpoäng, följer värdena originaltabellens procenttal; i varje rad har endast det högre värdet bland dessa tre modeller fetmarkerats. "—" betyder att originaltabellen inte har något jämförbart resultat, inte att resultatet är 0.
| Förmågegrupp | Benchmark (testobjekt) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Kunskapsarbete | Vals Index | 68,9 % | 63,1 % | 65,8 % |
| Kunskapsarbete | AutomationBench | 51,3 % | 41,4 % | 31,4 % |
| Kunskapsarbete | Vals Finance Agent v2 | 65,4 % | 53,5 % | 58,9 % |
| Kunskapsarbete | Harvey's Legal Agent Benchmark | 19,6 % | 5,4 % | 6,7 % |
| Automatisk programmering | DeepSWE v1.1 | 77,9 % | 74,1 % | 67,4 % |
| Automatisk programmering | FrontierSWE v2 | 55,0 % | 65,5 % | 56,3 % |
| Automatisk programmering | Vibe Code Bench | 91,9 % | 89,6 % | 90,3 % |
| Automatisk programmering | Terminal-bench 4.0 | 57,4 % | 58,2 % | 57,9 % |
| Maskininlärningsteknik | PostTrainBench | 45,3 % | 44,3 % | 40,2 % |
| Vetenskap och matematik | Terminal-Bench Science 0.1 | 57,6 % | 68,1 % | 52,6 % |
| Vetenskap och matematik | LABBench 2 | 88,8 % | 85,4 % | 68,6 % |
| Vetenskap och matematik | RiemannBench | 76,0 % | 72,0 % | 65,6 % |
| Lång text | GraphWalks (≤128K, BFS F1) | 99,7 % | 98,7 % | 91,4 % |
| Lång text | GraphWalks (256K–1M, BFS F1) | 84,2 % | 71,8 % | 65,0 % |
| Datoranvändning | Agent's Last Exam (godkännandegrad) | 39,5 % | 34,2 % | — |
| Datoranvändning | OSWorld-2.0 (offline-deluppsättning, delpoäng) | 69,2 % | 72,6 % | — |
| Bild- och textförståelse | Chartography | 71,6 % | 71,0 % | 46,2 % |
| Videoförståelse | LVBench | 91,7 % | 87,5 % | 79,7 % |
| Defensiv säkerhet | CWE-bench v1 | 68,0 % | 68,0 % | 58,0 % |
Hur använder man tabellen? Om du arbetar med kunskapsarbete kan du först titta på Vals Index och Finance Agent; om du skriver kod kan du samtidigt titta på DeepSWE, FrontierSWE och Terminal-bench, välj inte bara en rad: Argon leder i DeepSWE, men Astra är högre i FrontierSWE och Terminal-bench. För datoranvändning bör du vara särskilt uppmärksam: Fable saknas i två rader i Googles tabell, vilket inte betyder att den inte kan använda datorer. CWE-bench visar att Argon och Astra ligger lika bland de tre; det är inte heller någon garanti för verkligt säkerhetsarbete.
Testmetodik: Googles beskrivning av utvärderingsmetod anger att Argons resultat vanligtvis bygger på ett enda försök och högsta tänknivå; data för andra modeller kommer mest från respektive leverantörs egna uppgifter eller offentliga topplistor och kan också använda deras högsta eller tillgängliga tänknivå. Vissa projekt kördes av Google själva, andra kommer från tredje part, och verktygsmiljöer och samplingsmetoder är inte identiska överallt. Till exempel är Argons resultat i DeepSWE och Terminal-bench Googles egna tester, medan andra modeller använder offentliga resultat; LVBench använder olika antal extraherade videobildrutor för olika modeller. GraphWalks-raden använder BFS F1, och OSWorld-raden representerar endast "delpoäng" för en offline-deluppsättning. Man kan inte beräkna ett medelvärde över rader och inte utifrån detta hävda en samlad förstaplats under enhetliga testförhållanden. PDF:en med metodiken skriver på resultatsidan "per oktober 2026", vilket inte stämmer med den 30 september då tabellen lästes i den här artikeln; det exakta datumet då utvärderingen slutfördes kunde inte bekräftas. Den här artikeln återger endast resultat som var synliga på den officiella webbplatsen vid den tidpunkten, drar inga slutsatser om när utvärderingen slutfördes och framställer dem inte som resultat vi har reproducerat.
Hur jämför man pris? Månadsavgifter och API-kostnader måste hållas åtskilda
Om du bara vill använda den i en chattprodukt eller ett programmeringsverktyg, titta först på abonnemang och användningskvot. I amerikanska offentliga priser kostar ChatGPT Plus $20/månad och Pro finns i nivåer som $100, $200 och $500/månad; den specifika Astra-användningen varierar med abonnemang och uppgift. OpenAI:s pris- och användningsbeskrivning för ChatGPT Work/Codex påminner uttryckligen om att API-priset per miljon token inte kan användas för att uppskatta hur många uppgifter som kan utföras inom ett abonnemang.
Claude Pro kostar $20 per månad i USA, och Max från $100/månad (Claudes officiella prislista). Men att "Pro kan välja Fable 5.1" betyder inte att Fable ingår i Pros vanliga kvot: Anthropics abonnemangsregler för Fable anger att Pro och standardplatser i Team måste använda extra användningskrediter för Fable 5.1; Max och högre platser kan använda det inom en del av den veckovisa kvoten. Google har ännu inte angett något faktiskt abonnemangspris eller öppningsdatum för vanliga användare att använda Argon, och det nuvarande månadspriset för Google AI Ultra kan inte användas som ett pris för att "köpa Argon i dag".
Om du betalar via API efter användning är det följande som är standardpriser för text som går att läsa i samma enhet. Indata avser innehåll du ger modellen att läsa, utdata avser svaret den genererar. Enheten är i samtliga fall dollar per 1 miljon token (token är enheten som text och annat innehåll delas upp i vid fakturering); Argon i tabellen är Googles publicerade framtida lanseringspris, inte en faktisk räkning vi har betalat i dag.
| Modell | Vanlig indata | Vanlig utdata | Cache-läsning av upprepade data | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Preliminärt lanseringspris $2; $4 efter kampanjperioden | Preliminärt lanseringspris $10; $20 efter kampanjperioden | Google uppger att cachad indata vid lansering får 95 % rabatt på priset för vanlig indata; exakta lanseringsregler återstår att verifiera | Ännu inte allmänt tillgänglig |
| GPT-6 Astra | $10 | $50 | $1 | Nuvarande API-standardpris |
| Claude Fable 5.1 | $10 | $50 | $0,25 | Nuvarande API-standardpris |
Data kommer från Googles lanseringsmeddelande för Argon, OpenAI:s modellprissida för Astra och Anthropics modellsida för Fable 5.1. Priserna omfattar inte extra verktyg, region, hastighetsnivå eller plattformsskillnader; för Astra, när en enskild indata överstiger 272K token, debiteras hela begärans indata och cachepris med 2× och utdata med 1,5×. Cachepriset gäller endast innehåll som faktiskt träffar cachen; man kan inte uppskatta en hel uppgift till cachepris. Även om Argons preliminära styckpris är lägre än de andra två, utan data om framgångsgrad och förbrukning för samma uppgift kan man inte hävda att den är billigast för att slutföra en uppgift.
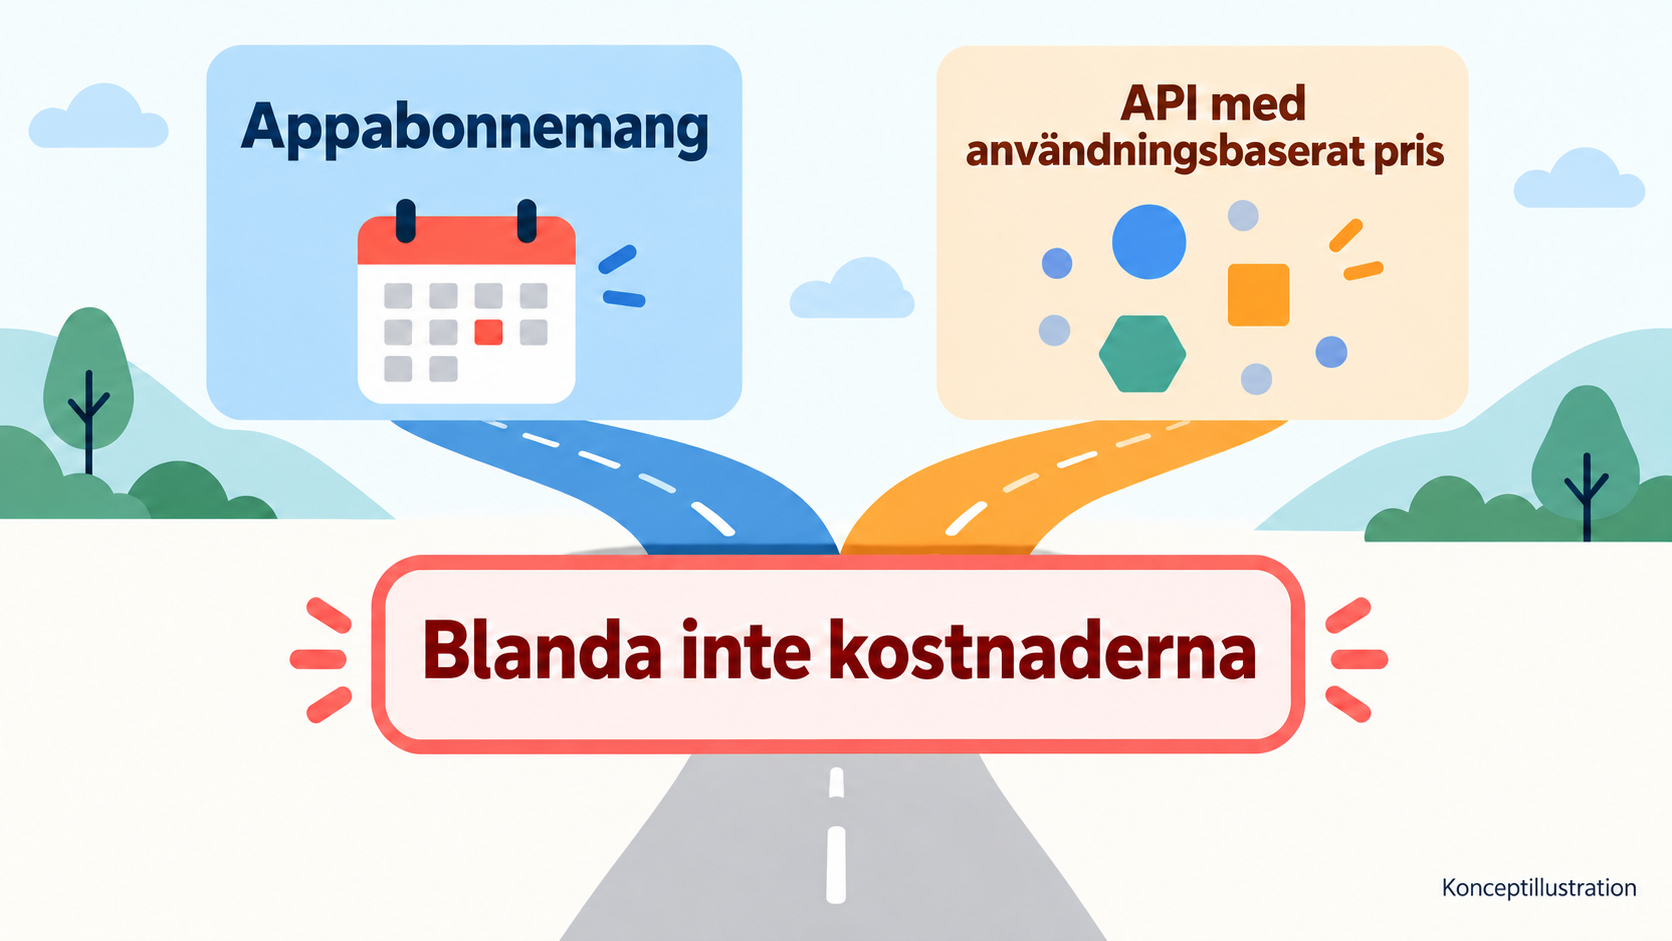
Bild: AI-genererad illustration av faktureringsmodeller, inte en produktfaktura; månadsavgift för abonnemang kan inte blandas ihop med API-styckpris. Visa bild i originalstorlek (1672×941).

Hur väljer man utifrån uppgift? Börja med de modeller du har tillgång till
Om uppgiften sträcker sig över flera programvaror, eller kräver webbläsning, gränssnittsarbete och komplexa bedömningar: prova GPT-6 Astra först. OpenAI listar datoranvändning, surfning, avancerad programmering och professionella dokument som dess nyckelområden. Om du redan har ett lämpligt ChatGPT-betalkonto eller API-behörighet kan du ge det en verklig uppgift i dag och se om resultatet uppfyller kraven. OpenAI:s modellbeskrivning.
Om uppgiften är programmering som varar i flera timmar, kodgranskning eller arbete med stora dokument: prova Claude Fable 5.1 först. Anthropic positionerar den för långvariga autonoma uppgifter, komplex programmering och forskning. Den som redan har ett Claude Code-arbetsflöde kan först fortsätta med de bekanta verktygen, men bör först kontrollera om abonnemanget drar extra användningskrediter; om du kör många sådana uppgifter varje dag kan du sedan jämföra den verkliga kostnaden för Max och API. Anthropics modellbeskrivning.
Vill du prova Gemini 4 Argon: kontrollera först om du har fått officiell åtkomst. Googles angivna inriktning omfattar komplex programmering, företags kunskapsarbete och defensiva säkerhetsuppgifter, och preliminära priser har angetts; detta är värt att följa, men kan ännu inte ersätta vanliga användares praktiska erfarenhet. Om du inte har åtkomst rekommenderas du inte att ändra ett pågående arbetsflöde för att Argon "förväntas bli billigare". Googles officiella meddelande.
Dessa råd betyder inte att "en modell som är bra på en typ av uppgift bara kan användas till den typen". Om alla tre blir tillgängliga i framtiden är den säkraste metoden att ta samma verkliga uppgift, ge samma material och acceptanskriterier och separat dokumentera om den slutfördes, manuellt omarbete, tidsåtgång och total kostnad. En snygg demonstration eller olika leverantörers egna benchmarkresultat kan inte direkt bevisa att din uppgift också får samma resultat.
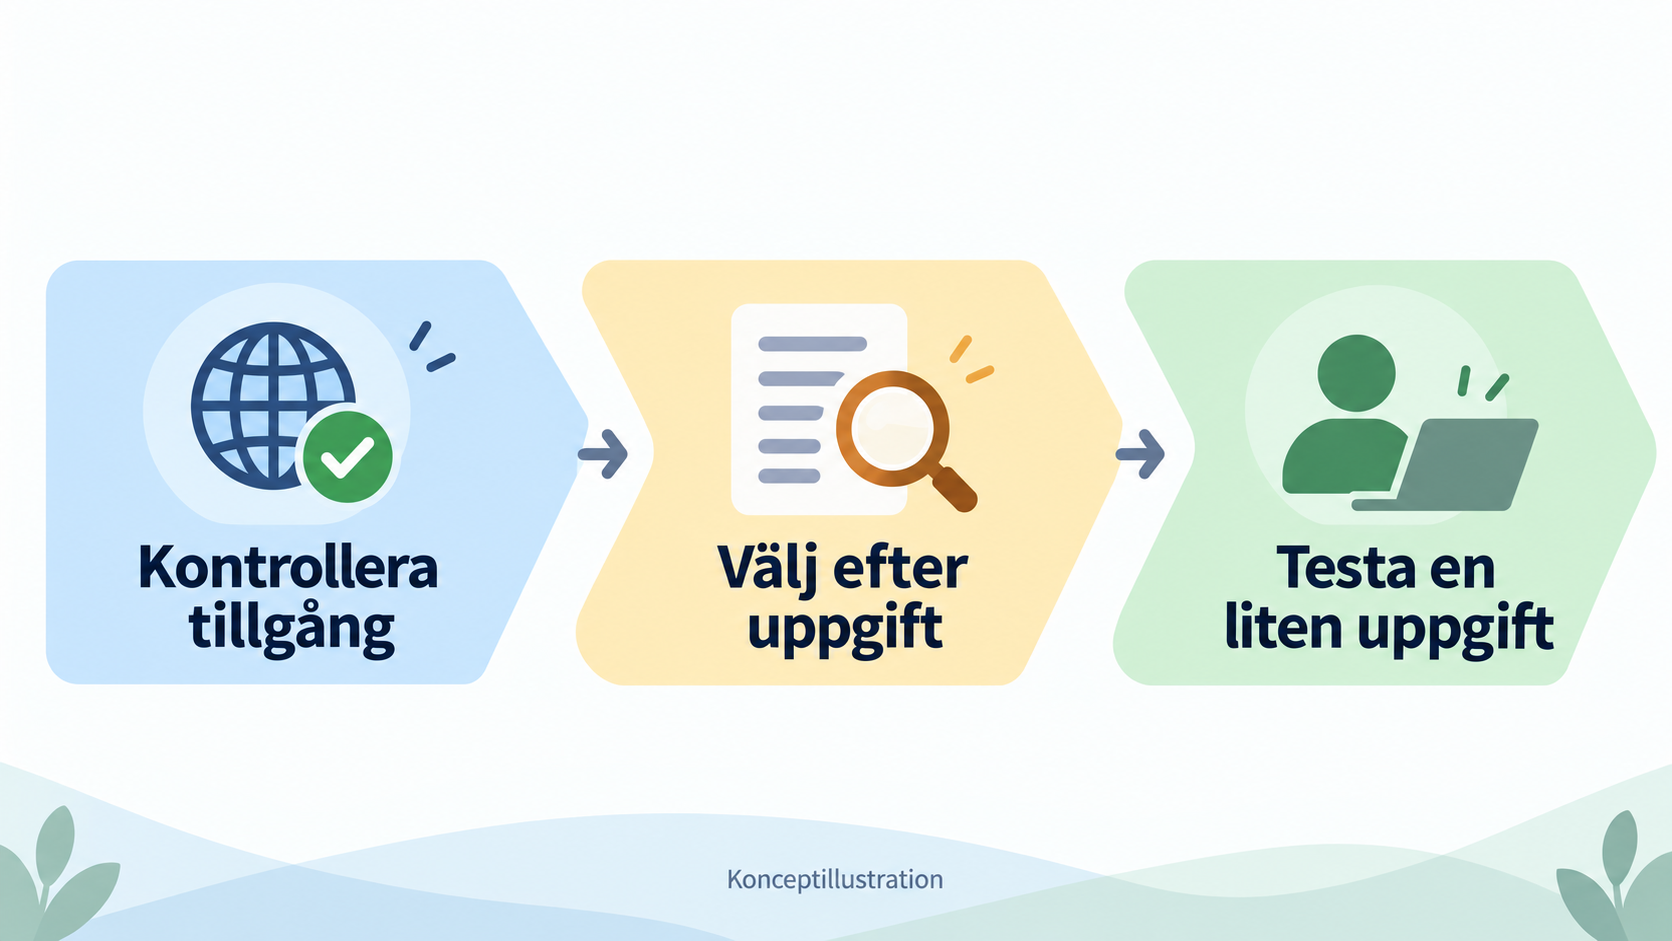
Bild: AI-genererad illustration av valvägen: titta först på konto- och regionstillgänglighet, sedan på uppgiftsbehov och till sist verifiera med din egen lilla uppgift. "Den här artikeln utför inga jämförande tester" i bilden betyder att vi inte själva har kört tester under samma förutsättningar; benchmarktabellen ovan återger data som Google har publicerat. Visa bild i originalstorlek (1672×941).

Om din uppgift är att låta två programmeringsassistenter dela på arbetet kan du läsa handledningen för Claude Code och Codex tillsammans; om du vill skicka en specifik fråga till en inloggad ChatGPT Pro-sida kan du läsa handledningen för att Codex och Claude Code ber ChatGPT Pro om hjälp. Dessa två artiklar beskriver arbetsflödesmoment och betyder inte att Gemini 4 Argon har integrerats i PandaNpc.
Vanliga frågor (FAQ)
Gemini 4 Argon har redan släppts officiellt – varför hittar jag det inte?
"Släppt" betyder att Google har offentliggjort modellen och öppnat den för en begränsad krets; det officiella meddelandet har ännu inte angett ett enhetligt öppningsdatum för alla utvecklare och vanliga konsumenter. Kontrollera först den officiella modellistan för den Gemini-produkt och det konto du använder, och behandla inte det ryktade "Gemini 4 Pro" som en tillgänglig ingång till Argon.
Är Astra Googles Project Astra?
Nej. GPT-6 Astra i den här artikeln är OpenAI:s modell; Google Project Astra är ett annat forskningsprojekt och kan inte blandas in i pristabellen för de tre modellerna.
Om jag prenumererar på Claude Pro, kan jag då använda Fable 5.1 inom abonnemangets kvot?
Inte nödvändigtvis. Anthropics gällande abonnemangsbeskrivning anger att Pro behöver användningskrediter för att använda Fable 5.1, medan vissa abonnemang som Max kan använda det inom en begränsad veckokvot. Titta på din sida för "användning/krediter" innan du betalar.
Kan man direkt avgöra vem som är mest prisvärd utifrån priserna ovan?
Nej. API-tabellen jämför bara listpriser; när en uppgift slutförs påverkas den också av indatalängd, om upprepat innehåll träffar cachen, verktygskostnader, antal körningsomgångar och omarbete. Särskilt Argon är ännu inte allmänt tillgänglig, så vi kan inte ange vår egen "kostnad per lyckad uppgift".
Relaterade guider

GPT-6 Sol vs Claude Opus 5.5: pris, benchmarks och hur väljer man för programmeringsuppgifter?
Prova först GPT-6 Sol för vanliga API-programmeringsuppgifter; för komplexa uppgifter kan du jämföra Claude Opus 5.5 och sedan använda GPT-6 Astra och Claude Fable 5.1 som alternativ för hög svårighetsgrad. Den här artikeln granskar de fyra modellernas officiella specifikationer, cache- och Batch-priser samt tredjepartsbenchmarkresultat enligt samma jämförelsemått, och ger fem kostnadsscenarier som går att räkna om.
Läs artikel →
Claude Code vs Codex: funktioner, fjärrstyrning, behörigheter och användningsområden – hur väljer du? (2026)
Kort sagt: Claude Code för djup terminalåtkomst, Hooks och Claude-ekosystemet; Codex för ChatGPT, molnjobb och flera Agent; PandaNpc för att fjärrstyra båda på Windows, macOS, Linux och mobil.
Läs artikel →
Använd ChatGPT Pro med Codex och Claude Code i PandaNpc
I en PandaNpc-konversation med Codex eller Claude Code kan du skicka en specifik fråga till en inloggad ChatGPT Pro-webbsida, och svaret kommer tillbaka till den ursprungliga konversationen.
Läs artikel →