
Hvordan velge Gemini 4 Argon, GPT-6 Astra og Claude Fable 5.1? Tilgjengelighet, pris og bruksområder sammenlignet
Gemini 4 Argon har begrenset tilgang; velg tilgjengelige GPT-6 Astra eller Claude Fable 5.1 etter oppgave og plan, API- og abonnementspriser atskilt, etter offisielle data, ikke samme test.
Kildekontroll: 30. september 2026 (UTC). PandaNpc tilbyr AI Agent-tjenester og er relevante for modellvalg. Denne artikkelen sammenstiller offentlig informasjon fra tre selskaper og gir råd om valg etter oppgave; vi har ennå ikke fått prøvetilgang til Gemini 4 Argon, og vi har ikke utført tester av de tre modellene under samme betingelser. «Passer for» nedenfor viser til offisiell posisjonering og nåværende tilgjengelighet, og betyr ikke at vi har målt hvem som er sterkest.
Konklusjon først: hvis du må bruke den i dag, velg først mellom GPT-6 Astra og Claude Fable 5.1 ut fra oppgave og eksisterende abonnement; Gemini 4 Argon er foreløpig bare åpen for et lite antall betrodde testere, så vanlige brukere kan ikke regne den som et tredje alternativ som alltid er tilgjengelig. For arbeid på tvers av programvare, kompleks dokumentbearbeiding eller vanskelig programmering kan du først prøve Astra; for langvarig programmering, gjentatt lesing av store prosjekter eller komplekse dokumenter kan du først prøve Fable 5.1. Når Argon blir allment tilgjengelig, kan du sammenligne faktisk fullføringskvalitet og totalkostnad med de samme oppgavene.
Se forsidebilde i full størrelse PNG (1672×941)
Se først om du kan bruke dem: de tre modellene starter ikke fra samme linje
| Modell | Offisiell utgivelsesdato | Hvem kan bruke den per 30. september | Hva betyr det for vanlige lesere |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Først åpnet for betrodde nettverksforsvarere og testere i Googles Fairwind-prosjekt; bred åpning for utviklere, bedrifter og forbrukere avventer senere faser | Å se «utgitt» i dag betyr ikke at Gemini-kontoen eller API-et ditt allerede kan velge Argon |
| GPT-6 Astra | 2026-09-03 | Rulles ut i faser til betalende ChatGPT-brukere og API-brukere; konkrete kvoter avhenger av abonnement og konto | Du kan sjekke modellisten og brukskvoten din og begynne på reelle oppgaver med en gang |
| Claude Fable 5.1 | 2026-09-01 | Tilgjengelig i betalte Claude-abonnementer og Claude API, men abonnementer som Pro kan kreve ekstra brukskreditter | Sjekk først abonnementets Fable-regler før du bestemmer deg for å oppgradere eller betale ekstra |
Googles kunngjøring om Gemini 4 Argon sier at den foreløpig er åpnet i liten skala, og at planen er å utvide først til betalende API-brukere og Google AI Ultra-abonnenter; det er ikke kunngjort noen bestemt dato for når vanlige brukere kan bruke den. OpenAIs Astra-kunngjøring og Anthropics Fable 5.1-informasjon beskriver hver sin nåværende tilgjengelighet. Astra her er en OpenAI-modell, ikke Googles Project Astra-forskningsprosjekt.
Parametersammenligning: ikke bland sammen «hvor mye den kan lese» og «hvor mye den kan skrive»
Inndatakontekstvinduet er hvor mye materiale du kan gi modellen på én gang; maksimal utdata er hvor mye den maksimalt kan generere på én gang. Disse to tallene kan ikke byttes om, og du kan ikke bedømme svarkvaliteten bare ut fra tall. Alt nedenfor er informasjon om spesifikke modeller verifisert 30. september 2026, ikke generelle spesifikasjoner for hele Gemini-, GPT- eller Claude-familiene.
| Parameter | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Inndatakontekstvindu | Offisiell øvre grense ikke publisert | 1 050 000 token | 1 000 000 token |
| Maksimal utdata per gang | Google kunngjør 1 000 000 token; vanlige brukere kan ennå ikke verifisere | 128 000 token | 128 000 token |
| Inndata som kan gis til modellen | Kunngjøringen viser multimodal og lang videoforståelse, men den fullstendige listen over API-inndatatyper er ikke publisert | Tekst, bilder | Tekst, bilder |
| Nåværende offisielle inngang | Fairwind betrodde testere; tid for bred åpning ikke publisert | ChatGPT-betalingskontoer etter utrullingsfremdrift og abonnement, OpenAI API | Betalte Claude-produkter og Claude API; abonnementer som Pro har ekstra kredittvilkår |
Kilder: Googles kunngjøring om Gemini 4 Argon, OpenAIs modellside for GPT-6 Astra, Anthropics modellside for Claude Fable 5.1 og Anthropics abonnementsbeskrivelse. Googles «1 million» i kunngjøringen viser til utdatagrense, og kan ikke tas som at Argon har kunngjort «1 million inndatakontekstvindu». Argon sitt fullstendige offentlige modellkort og vanlige brukeres tester gjenstår å publiseres; «ikke publisert» i tabellen betyr ikke «denne evnen finnes ikke».
Tabellen ovenfor sammenligner offentlige spesifikasjoner, ikke en seier i ytelse: jo mer innhold den kan romme, desto mer nøyaktig er ikke svaret nødvendigvis. Tabellen nedenfor er derimot resultater fra ytelsesbenchmark.
Offisielle benchmark-resultater: se på konkrete oppgaver, ikke kåre en «totalseier»
Google DeepMind har publisert en benchmarktabell med fire modeller på Gemini 4 Argon offisielle modellside. Her trekker vi bare ut de tre kolonnene Argon, GPT-6 Astra og Claude Fable 5.1 som diskuteres i denne artikkelen; originaltabellen inneholder også Claude Opus 5.5. Resultatene nedenfor kommer fra Google-offisielle nettsider faktisk lest 30. september 2026 kl. 23:42 UTC, sammenstilt av Google, ikke en test av PandaNpc under samme betingelser. Bortsett fra rader som angir F1, gjennomføringsrate eller delvis poengsum, følger verdiene prosentene i originaltabellen; i hver rad er bare den høyeste verdien blant disse tre modellene uthevet. «—» betyr at originaltabellen ikke har en sammenlignbar resultatverdi, ikke 0 poeng.
| Evnegruppe | Benchmark (testelement) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Kunnskapsarbeid | Vals Index | 68,9 % | 63,1 % | 65,8 % |
| Kunnskapsarbeid | AutomationBench | 51,3 % | 41,4 % | 31,4 % |
| Kunnskapsarbeid | Vals Finance Agent v2 | 65,4 % | 53,5 % | 58,9 % |
| Kunnskapsarbeid | Harvey's Legal Agent Benchmark | 19,6 % | 5,4 % | 6,7 % |
| Automatisk programmering | DeepSWE v1.1 | 77,9 % | 74,1 % | 67,4 % |
| Automatisk programmering | FrontierSWE v2 | 55,0 % | 65,5 % | 56,3 % |
| Automatisk programmering | Vibe Code Bench | 91,9 % | 89,6 % | 90,3 % |
| Automatisk programmering | Terminal-bench 4.0 | 57,4 % | 58,2 % | 57,9 % |
| Maskinlæringsarbeid | PostTrainBench | 45,3 % | 44,3 % | 40,2 % |
| Vitenskap og matematikk | Terminal-Bench Science 0.1 | 57,6 % | 68,1 % | 52,6 % |
| Vitenskap og matematikk | LABBench 2 | 88,8 % | 85,4 % | 68,6 % |
| Vitenskap og matematikk | RiemannBench | 76,0 % | 72,0 % | 65,6 % |
| Langtekst | GraphWalks (≤128K, BFS F1) | 99,7 % | 98,7 % | 91,4 % |
| Langtekst | GraphWalks (256K–1M, BFS F1) | 84,2 % | 71,8 % | 65,0 % |
| Datamaskinoperasjon | Agent's Last Exam (gjennomføringsrate) | 39,5 % | 34,2 % | — |
| Datamaskinoperasjon | OSWorld-2.0 (offline delsett, delvis poengsum) | 69,2 % | 72,6 % | — |
| Bilde- og tekstforståelse | Chartography | 71,6 % | 71,0 % | 46,2 % |
| Videoforståelse | LVBench | 91,7 % | 87,5 % | 79,7 % |
| Defensiv sikkerhet | CWE-bench v1 | 68,0 % | 68,0 % | 58,0 % |
Hvordan bruker du denne tabellen? Hvis du gjør kunnskapsarbeid, kan du først se på Vals Index og Finance Agent; hvis du skriver kode, kan du se både DeepSWE, FrontierSWE og Terminal-bench, ikke bare velge én rad: Argon leder i DeepSWE, men Astra er høyere i FrontierSWE og Terminal-bench. For datamaskinoperasjon må du være spesielt oppmerksom: Fable mangler de to radene i denne Google-tabellen, og derfor kan du ikke si at den ikke kan bruke datamaskiner. CWE-bench viser at Argon og Astra er side om side blant de tre; dette er heller ikke en garanti for reelt sikkerhetsarbeid.
Testgrunnlag: Googles metodebeskrivelse for evaluering sier at Argons resultater vanligvis er enkeltforsøk på høyeste tenkenivå; dataene for de andre modellene kommer stort sett fra leverandørenes egne rapporter eller offentlige lister, og kan også bruke deres respektive høyeste eller tilgjengelige tenkenivå. Noen prosjekter kjøres av Google selv, andre kommer fra tredjeparter, og verktøymiljø og samplingsmetoder er ikke identiske overalt. For eksempel er Argons resultater i DeepSWE og Terminal-bench Googles egne tester, mens andre modeller bruker offentlige resultater; LVBench trekker ut ulike antall videorammer for ulike modeller. GraphWalks-raden bruker BFS F1, og OSWorld-raden representerer bare «delvis poengsum» for et offline delsett. Du kan ikke ta gjennomsnitt på tvers av rader, og du kan ikke ut fra dette erklære en samlet førsteplass under enhetlige testbetingelser. Resultatsiden i denne metode-PDF-en sier også «per oktober 2026», noe som ikke stemmer med tidspunktet 30. september da vi leste tabellen i denne artikkelen; den nøyaktige datoen for når evalueringen ble fullført, kunne ikke bekreftes. Denne artikkelen transkriberer bare resultatene som var synlige på det offisielle nettstedet da, trekker ikke slutninger om når evalueringen ble fullført, og sier heller ikke at dette er resultater vi har reprodusert.
Hvordan sammenligne pris: månedsavgift og API-kostnader må holdes atskilt
Hvis du bare vil bruke den i et chatprodukt eller programmeringsverktøy, bør du først se på abonnement og brukskvote. I offentlige amerikanske priser er ChatGPT Plus $20/måned, og Pro har nivåer som $100, $200 og $500/måned; det konkrete Astra-forbruket varierer med abonnement og oppgave. OpenAIs pris- og bruksforklaring for ChatGPT Work/Codex minner eksplisitt om at API-prisen per million token ikke kan brukes til å beregne hvor mange oppgaver du kan fullføre innenfor et abonnement.
Claude Pro koster $20 per måned i USA, og Max starter på $100/måned (Claude offisielle prisliste). Men at «Pro kan velge Fable 5.1» betyr ikke at Fable er inkludert i Pros vanlige kvote: Anthropics abonnementsregler for Fable sier at Pro og standard Team-plasser må bruke Fable 5.1 med ekstra brukskreditter; Max og høyere plasser kan bruke den innenfor en del av den ukentlige kvoten. Google har ennå ikke oppgitt faktisk abonnementspris eller åpningsdato for vanlige brukeres bruk av Argon, så du kan ikke bruke Googles nåværende månedspris for Google AI Ultra som et tilbud på «kjøp Argon i dag».
Hvis du betaler etter forbruk via API, er det først nedenfor du kan lese standard tekstpriser i samme enhet. Inndata betyr innholdet du gir modellen å lese, og utdata betyr svaret den genererer. Enhetene er dollar per 1 million token (token er enheten teksten og annet innhold deles inn i ved fakturering); Argon i tabellen er fremtidig lanseringspris kunngjort av Google, ikke en faktisk regning vi har betalt i dag.
| Modell | Vanlig inndata | Vanlig utdata | Lesing fra cache for gjentatt innhold | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Planlagt lanseringspris $2; etter kampanjeperiode $4 | Planlagt lanseringspris $10; etter kampanjeperiode $20 | Google sier at inndata som treffer cachen ved lansering får 95 % rabatt på vanlig inndatapris; konkrete lanseringsregler må bekreftes | Ikke bredt tilgjengelig ennå |
| GPT-6 Astra | $10 | $50 | $1 | Gjeldende standardpris for API |
| Claude Fable 5.1 | $10 | $50 | $0,25 | Gjeldende standardpris for API |
Dataene kommer fra Googles Argon-lanseringskunngjøring, OpenAIs prisside for Astra-modellen og Anthropics modellside for Fable 5.1. Prisene inkluderer ikke ekstra verktøy, region, hastighetsnivå eller plattformforskjeller; for Astra, når en enkelt inndata overstiger 272K token, faktureres hele forespørselens inndata og cache med 2× pris, og utdata med 1,5× pris. Cachepris gjelder bare innhold som faktisk treffer cachen, og du kan ikke estimere hele oppgaven med cachepris. Selv om Argons planlagte enhetspris er lavere enn de to andres, kan vi uten data om suksessrate og forbruk på samme oppgave ikke si at den er billigst for å fullføre en oppgave.
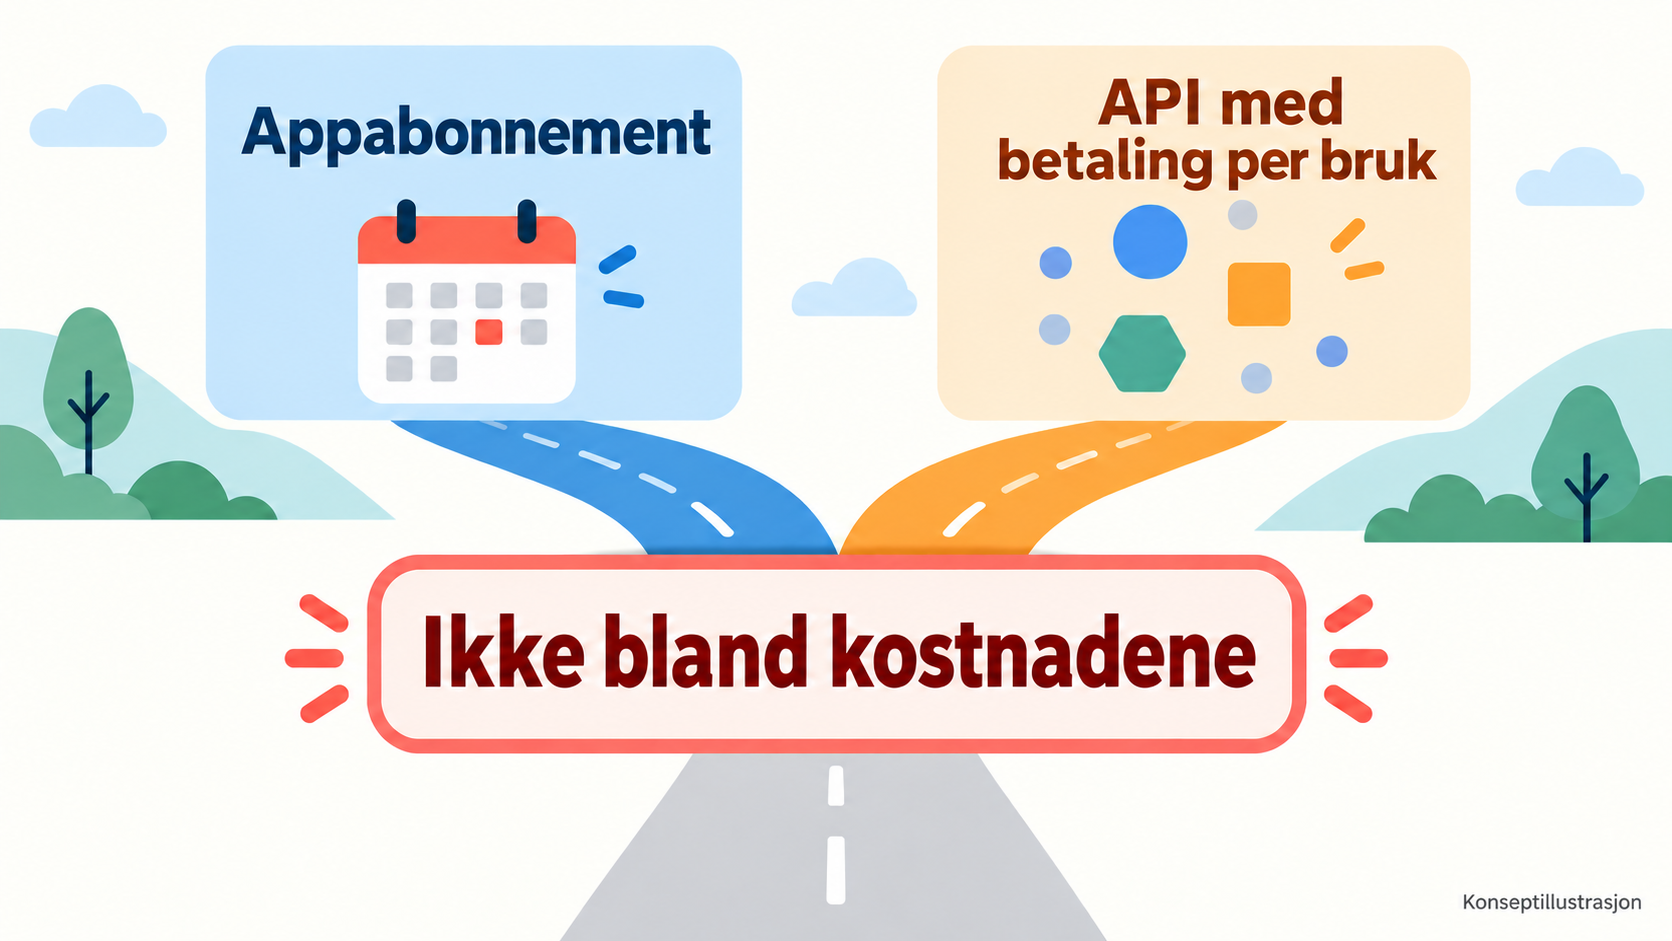
Figur: AI-generert illustrasjon av faktureringsgrunnlag, ikke en produktregning; månedsabonnement kan ikke blandes med API-enhetspris. Se bildet i full størrelse (1672×941).

Hvordan velge etter oppgave? Bruk først modellene du har tilgang til
Oppgaver som går på tvers av flere programmer, eller som krever nettsurfing, grensesnittoperasjoner og komplekse vurderinger: prøv GPT-6 Astra først. OpenAI lister datamaskinoperasjon, surfing, vanskelig programmering og profesjonelle dokumenter som dens sentrale evner. Hvis du allerede har en passende betalt ChatGPT-konto eller API-tilgang, kan du i dag gi den en reell oppgave og se om resultatet holder mål. OpenAI-modellbeskrivelse.
Oppgaver med programmering som varer i flere timer, kodegjennomgang eller store dokumentarbeid: prøv Claude Fable 5.1 først. Anthropic posisjonerer den mot langvarige autonome oppgaver, kompleks programmering og forskning. De som allerede har en Claude Code-arbeidsflyt, kan fortsette med kjente verktøy, men må først bekrefte om abonnementet trekker ekstra brukskreditter; hvis du skal kjøre mange slike oppgaver hver dag, kan du deretter sammenligne den reelle kostnaden for Max og API. Anthropic-modellbeskrivelse.
Vil du prøve Gemini 4 Argon: bekreft først om du har offisiell tilgang. Retningene Google kunngjør omfatter kompleks programmering, bedriftskunnskapsarbeid og defensive sikkerhetsoppgaver, og de oppgir en planlagt pris; dette er verdt å følge med på, men kan ennå ikke erstatte vanlige brukeres faktiske erfaring. Uten tilgang anbefaler vi ikke å endre en fungerende arbeidsflyt fordi Argon «forventes å bli billigere». Googles offisielle kunngjøring.
Disse rådene betyr ikke at «en modell som er god på én type oppgave, bare kan gjøre den typen». Hvis alle tre blir tilgjengelige i fremtiden, er den tryggeste metoden: ta den samme reelle oppgaven, gi samme materiale og godkjenningskriterier, og registrer hver for seg om den fullfører, manuelt omarbeid, tidsbruk og totalkostnad. En fin demonstrasjon eller ulike leverandørers egne benchmark-resultater kan ikke direkte bevise at oppgaven din vil få samme resultat.
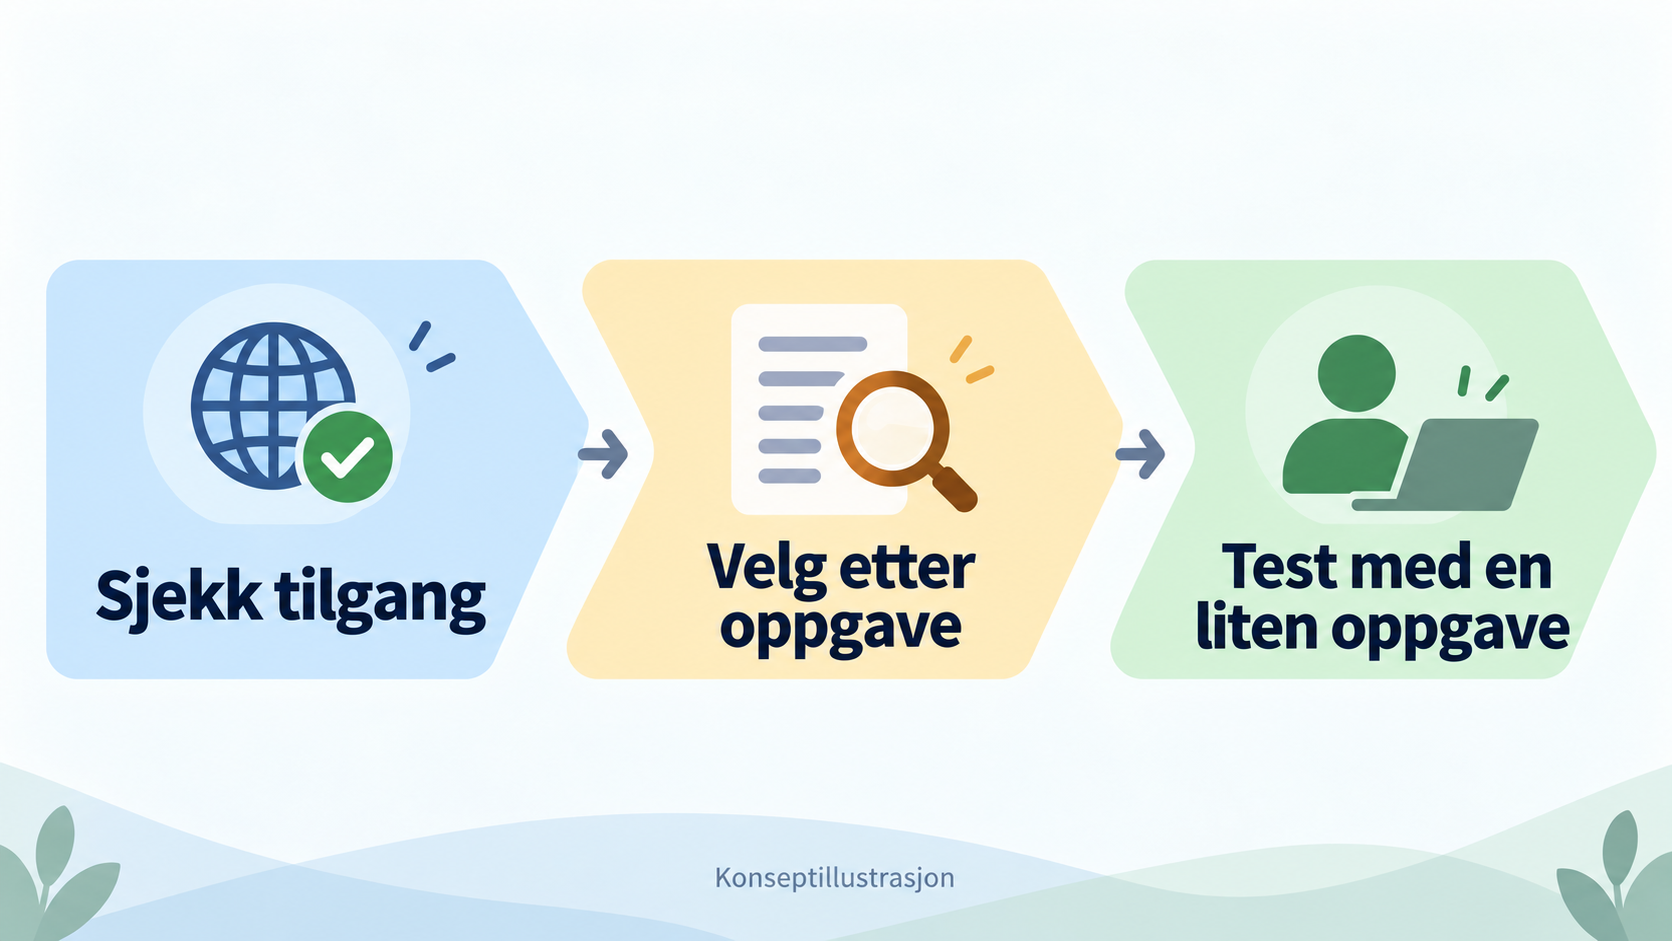
Figur: AI-generert illustrasjon av valgveien: se først på kontotilgjengelighet og region, deretter på oppgavebehov, og til slutt verifiser med din egen lille oppgave. «Denne artikkelen utfører ingen sammenlignende tester» i figuren betyr at vi ikke selv har kjørt tester under samme betingelser; benchmarktabellen ovenfor er en transkripsjon av data publisert av Google. Se bildet i full størrelse (1672×941).

Hvis oppgaven din er å la to programmeringsassistenter dele arbeid, se Claude Code og Codex-samarbeidsveiledning; hvis du vil sende et konkret problem til en innlogget ChatGPT Pro-side, se Codex og Claude Code: veiledning for å be ChatGPT Pro om hjelp. Disse to artiklene beskriver arbeidsflytoperasjoner og betyr ikke at Gemini 4 Argon er integrert i PandaNpc.
FAQ
Gemini 4 Argon er allerede offisielt utgitt, hvorfor finner jeg den ikke?
«Utgitt» betyr at Google har kunngjort modellen og åpnet den for et begrenset omfang; den offisielle kunngjøringen har ennå ikke oppgitt en samlet åpningsdato for alle utviklere og vanlige forbrukere. Sjekk først den offisielle modellisten for Gemini-produktet og kontoen du bruker, og ikke bruk det ryktebaserte «Gemini 4 Pro» som en tilgjengelig inngang til Argon.
Er Astra Googles Project Astra?
Nei. GPT-6 Astra i denne artikkelen er OpenAI-modellen; Google Project Astra er et annet forskningsprosjekt og kan ikke blandes inn i pristabellen for de tre modellene.
Hvis jeg abonnerer på Claude Pro, kan jeg da bruke Fable 5.1 innenfor abonnementskvoten?
Ikke nødvendigvis. Anthropics gjeldende abonnementsbeskrivelse sier at Pro trenger brukskreditter for å bruke Fable 5.1, mens enkelte abonnementer som Max kan bruke den innenfor en begrenset ukentlig kvote. Se på «forbruk/kreditter»-siden din før du betaler.
Kan jeg avgjøre hvem som er mest lønnsom bare ut fra prisene ovenfor?
Nei. API-tabellen sammenligner bare listepriser; når en oppgave skal fullføres, påvirkes den også av inndatalengde, om gjentatt innhold treffer cachen, verktøykostnader, antall kjøringsrunder og omarbeid. Spesielt Argon er ennå ikke bredt tilgjengelig, så vi kan ikke oppgi vår egen «kostnad per vellykkede oppgave».
Relaterte guider

GPT-6 Sol vs Claude Opus 5.5: Hvordan velge med tanke på pris, benchmarkresultater og programmeringsoppgaver?
Prøv GPT-6 Sol først for vanlige API-programmeringsoppgaver; for komplekse oppgaver kan du sammenligne med Claude Opus 5.5, og deretter bruke GPT-6 Astra og Claude Fable 5.1 som alternativer for høy vanskelighetsgrad. Denne artikkelen verifiserer de fire modellenes offisielle spesifikasjoner, cache- og Batch-priser og tredjeparts benchmarkresultater etter samme målemetode, og tilbyr fem kostnadsscenarier som kan regnes på nytt.
Les artikkel →
Claude Code vs Codex: Hvordan velge mellom funksjoner, ekstern kontroll, tillatelser og bruksscenarier (2026)
Kort sagt: Claude Code for dyp terminaltilgang, Hooks og Claude-økosystemet; Codex for ChatGPT, skyoppgaver og flere Agent; PandaNpc for å fjernstyre begge på Windows, macOS, Linux og mobil.
Les artikkel →
Slik bruker du ChatGPT Pro med Codex og Claude Code i PandaNpc
I en Codex- eller Claude Code-samtale i PandaNpc kan du sende et konkret spørsmål til en pålogget ChatGPT Pro-nettside, og svaret kommer tilbake i den opprinnelige samtalen.
Les artikkel →