
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1: як вибрати? Порівняння доступності, цін і сценаріїв використання
За офіційними даними, Gemini 4 Argon має обмежений доступ, а наявні GPT-6 Astra і Claude Fable 5.1 обирайте за завданням і планом; ціни API та підписок різні, це не тест в однакових умовах.
Перевірка даних: 30 вересня 2026 року (UTC). PandaNpc надає послуги AI Agent, що стосується вибору моделей. У цій статті зібрано публічну інформацію трьох компаній і наведено поради щодо вибору залежно від завдання; ми ще не отримали доступ до тестування Gemini 4 Argon, не проводили порівняльного тестування трьох моделей в однакових умовах. Далі слово «підходить» означає офіційне позиціонування та поточну доступність, а не те, що ми виміряли, хто сильніший.
Спочатку висновок: якщо потрібно використовувати вже сьогодні, вибирайте між GPT-6 Astra і Claude Fable 5.1 залежно від завдання та наявного тарифу; Gemini 4 Argon наразі відкритий лише для невеликої кількості довірених тестувальників, звичайні користувачі ще не можуть вважати його третьою опцією, доступною будь-коли. Для міжпрограмних операцій, складної обробки матеріалів або складного програмування можна спершу спробувати Astra; для тривалого програмування, повторного читання великих проєктів або складних документів можна спершу спробувати Fable 5.1. Після широкого відкриття Argon порівняйте фактичну якість виконання та загальні витрати на тих самих завданнях.
Переглянути обкладинку в оригінальному розмірі PNG (1672×941)
Спершу перевірте, чи можна користуватися: три моделі не на одній стартовій лінії
| Модель | Офіційна дата випуску | Хто може користуватися станом на 30 вересня | Що це означає для звичайного читача |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Спочатку відкрито для довірених фахівців із мережевого захисту та тестувальників проєкту Google Fairwind; широке відкриття для розробників, підприємств і споживачів очікується на наступних етапах | Те, що сьогодні ви бачите «випущено», не означає, що ваш акаунт Gemini або API вже може вибрати Argon |
| GPT-6 Astra | 2026-09-03 | Поетапно впроваджується для платних користувачів ChatGPT та користувачів API, конкретні доступні обсяги залежать від тарифу й акаунта | Можна перевірити свій список моделей та ліміти й одразу почати реальне завдання |
| Claude Fable 5.1 | 2026-09-01 | Доступний у платних тарифах Claude і Claude API, але для тарифів на кшталт Pro може знадобитися додаткове використання кредитів | Спершу перевірте правила використання Fable у своєму тарифі, а потім вирішуйте, чи оновлювати тариф або платити окремо |
Оголошення Google про Gemini 4 Argon зазначає, що наразі відкриття обмежене, а в майбутньому планується розширити його, починаючи з платних користувачів API та підписників Google AI Ultra; точної дати, коли ним зможуть користуватися звичайні користувачі, не опубліковано. Оголошення OpenAI про Astra і опис Fable 5.1 від Anthropic окремо пояснюють наявний обсяг відкриття. Тут Astra — це модель OpenAI, а не дослідницький проєкт Google Project Astra.
Порівняння параметрів: не плутайте «скільки може прочитати» з «скільки може написати»
Вхідне контекстне вікно — це скільки матеріалу можна за один раз передати моделі; максимальний вихід — це максимум, скільки вмісту вона може згенерувати за один раз. Ці два числа не можна підміняти одне одним, і не можна судити про якість відповіді лише за числами. Наведені нижче дані — це інформація про конкретні моделі, перевірена 30 вересня 2026 року, а не загальні специфікації всього сімейства Gemini, GPT або Claude.
| Параметр | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Вхідне контекстне вікно | Офіційна верхня межа не опублікована | 1,050,000 token | 1,000,000 token |
| Максимальний вихід за один раз | Google в оголошенні заявляє 1,000,000 token; звичайні користувачі ще не можуть перевірити | 128,000 token | 128,000 token |
| Доступні для передачі моделі вхідні дані | В оголошенні показано мультимодальне та довге відеорозуміння, але повний перелік типів вхідних даних API не опубліковано | Текст, зображення | Текст, зображення |
| Поточний офіційний вхід | Довірені тестувальники Fairwind; час широкого відкриття не оголошено | Платні акаунти ChatGPT відповідно до етапу впровадження й тарифу, OpenAI API | Платні продукти Claude і Claude API; для тарифів на кшталт Pro є умова додаткових кредитів |
Джерела: оголошення Google про Gemini 4 Argon, сторінка моделі GPT-6 Astra від OpenAI, сторінка моделі Claude Fable 5.1 від Anthropic та опис тарифів Anthropic. Google в оголошенні під «1 мільйоном» має на увазі ліміт виходу, і це не можна вважати опублікованим «вхідним контекстним вікном на 1 мільйон» для Argon. Повна публічна картка моделі Argon і тестування звичайними користувачами ще мають бути опубліковані; «не опубліковано» в таблиці не означає «немає такої можливості».
У таблиці вище порівнюються публічні специфікації, а не переможець за продуктивністю: чим більше вмісту вміщується, тим не обов’язково точніша відповідь. Лише таблиця нижче показує результати бенчмарків продуктивності.
Порівняння офіційних результатів: дивіться на конкретні завдання, а не шукайте «абсолютного чемпіона»
Google DeepMind на офіційній сторінці моделі Gemini 4 Argon опублікував таблицю результатів чотирьох моделей. Тут вибрано лише три стовпці, які обговорюються в цій статті: Argon, GPT-6 Astra, Claude Fable 5.1; оригінальна таблиця також включає Claude Opus 5.5. Наведені нижче результати походять із фактично прочитаної 30 вересня 2026 року о 23:42 UTC сторінки офіційного сайту Google, зібрані Google, а не є тестуванням PandaNpc в однакових умовах. Крім рядків, де зазначено F1, відсоток проходження або частковий бал, числові значення відповідають відсоткам з оригінальної таблиці; у кожному рядку серед цих трьох моделей жирним виділено вище значення. «—» означає, що в оригінальній таблиці немає порівнюваного результату, а не 0 балів.
| Група здібностей | Benchmark (тестове завдання) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Робота зі знаннями | Vals Index | 68.9% | 63.1% | 65.8% |
| Робота зі знаннями | AutomationBench | 51.3% | 41.4% | 31.4% |
| Робота зі знаннями | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| Робота зі знаннями | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| Автоматичне програмування | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| Автоматичне програмування | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| Автоматичне програмування | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| Автоматичне програмування | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| Інженерія машинного навчання | PostTrainBench | 45.3% | 44.3% | 40.2% |
| Наука й математика | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| Наука й математика | LABBench 2 | 88.8% | 85.4% | 68.6% |
| Наука й математика | RiemannBench | 76.0% | 72.0% | 65.6% |
| Довгі тексти | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 91.4% |
| Довгі тексти | GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 65.0% |
| Робота з комп’ютером | Agent's Last Exam (відсоток проходження) | 39.5% | 34.2% | — |
| Робота з комп’ютером | OSWorld-2.0 (офлайн-підмножина, частковий бал) | 69.2% | 72.6% | — |
| Розуміння зображень і тексту | Chartography | 71.6% | 71.0% | 46.2% |
| Розуміння відео | LVBench | 91.7% | 87.5% | 79.7% |
| Захисна безпека | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
Як користуватися цією таблицею? Якщо ви займаєтеся роботою зі знаннями, спершу дивіться на Vals Index, Finance Agent; якщо пишете код, дивіться одночасно на DeepSWE, FrontierSWE і Terminal-bench, не вибирайте лише один рядок: Argon лідирує в DeepSWE, але Astra вищий у FrontierSWE і Terminal-bench. Для роботи з комп’ютером слід звернути особливу увагу: два рядки Fable в цій таблиці Google відсутні, і не можна через це казати, що він не вміє працювати з комп’ютером. CWE-bench показує, що Argon і Astra серед трьох рівні; це також не гарантія для реальної безпекової роботи.
Методологія тестування: опис методів оцінювання Google зазначає, що результати Argon зазвичай отримані за одну спробу на найвищому рівні міркування; дані інших моделей переважно походять із самозвітів постачальників або публічних рейтингів і також можуть використовувати їхні найвищі або доступні рівні міркування. Частину проєктів Google запускав самостійно, частину взято від третіх сторін; середовища інструментів і методи вибірки не всюди однакові. Наприклад, результати Argon у DeepSWE та Terminal-bench — це власні тести Google, а для інших моделей використано публічні результати; LVBench для різних моделей витягує різну кількість кадрів відео. У рядку GraphWalks використано BFS F1, рядок OSWorld представляє лише «частковий бал» офлайн-підмножини. Не можна усереднювати між рядками й не можна на цій підставі заявляти про комплексне перше місце за єдиних умов тестування. У PDF з методологією на сторінці результатів також написано «станом на жовтень 2026 року», що не збігається з часом 30 вересня, коли ми читали таблицю; точну дату завершення оцінювання підтвердити не вдалося. Ми лише відтворюємо результати, видимі тоді на офіційному сайті, не робимо висновків про те, коли оцінювання було завершено, і не подаємо їх як відтворені нами.
Як порівнювати ціни: місячну плату й витрати на API слід розділяти
Якщо ви хочете користуватися лише в чат-продукті або інструменті для програмування, спершу дивіться на підписку та ліміти використання. Серед опублікованих цін у США ChatGPT Plus коштує $20/місяць, Pro має рівні $100, $200, $500/місяць тощо; конкретний обсяг використання Astra залежить від тарифу й завдання. Опис цін і обсягів використання ChatGPT Work/Codex від OpenAI прямо попереджає: ціну API за мільйон token не можна використовувати, щоб оцінити, скільки завдань можна виконати в межах підписки.
Місячна ціна Claude Pro у США — $20, Max — від $100/місяць (офіційна таблиця цін Claude). Але те, що «у Pro можна вибрати Fable 5.1», не означає, що Fable включено у звичайні ліміти Pro: правила тарифів Fable від Anthropic пояснюють, що для використання Fable 5.1 у Pro та стандартних місцях Team потрібні додаткові usage credits; Max і преміум-місця можуть використовувати його в межах частини тижневого ліміту. Google ще не надав фактичну ціну підписки для використання Argon звичайними користувачами або дату відкриття, тому не можна вважати поточну місячну плату Google AI Ultra ціною «купити Argon сьогодні».
Якщо ви платите за API за обсягом використання, лише наведене нижче можна читати в однакових одиницях — це стандартна ціна для тексту. Вхід — це вміст, який ви даєте моделі для читання, вихід — це відповідь, яку вона генерує. Одиниця всюди — ціна в доларах США за кожен 1 мільйон token (token — це одиниця, на яку під час білінгу розбивають текст тощо); у таблиці Argon — це майбутня ціна запуску, оголошена Google, а не фактичний рахунок, який ми вже сплатили сьогодні.
| Модель | Звичайний вхід | Звичайний вихід | Читання кешу для повторюваного вмісту | Статус |
|---|---|---|---|---|
| Gemini 4 Argon | Початково заплановано $2; після пільгового періоду $4 | Початково заплановано $10; після пільгового періоду $20 | Google заявляє, що початковий кешований вхід має знижку 95% від ціни звичайного входу; точні правила запуску ще потрібно перевірити | Ще не відкрито широко |
| GPT-6 Astra | $10 | $50 | $1 | Поточна стандартна ціна API |
| Claude Fable 5.1 | $10 | $50 | $0.25 | Поточна стандартна ціна API |
Дані з оголошення Google про запуск Argon, сторінки цін на модель Astra від OpenAI та сторінки моделі Fable 5.1 від Anthropic. Ціни не включають додаткові інструменти, регіон, рівні швидкості або відмінності платформ; для Astra, коли одиничний вхід перевищує 272K token, ціна входу та кешу для всього запиту множиться на 2, а виходу — на 1.5. Ціна кешу застосовується лише до вмісту, який фактично потрапив у кеш, і не можна оцінювати все завдання за ціною кешу. Навіть якщо запланована ціна Argon нижча за дві інші, без даних про відсоток успішності на тих самих завданнях і обсяг використання не можна стверджувати, що він найдешевший для виконання завдання.
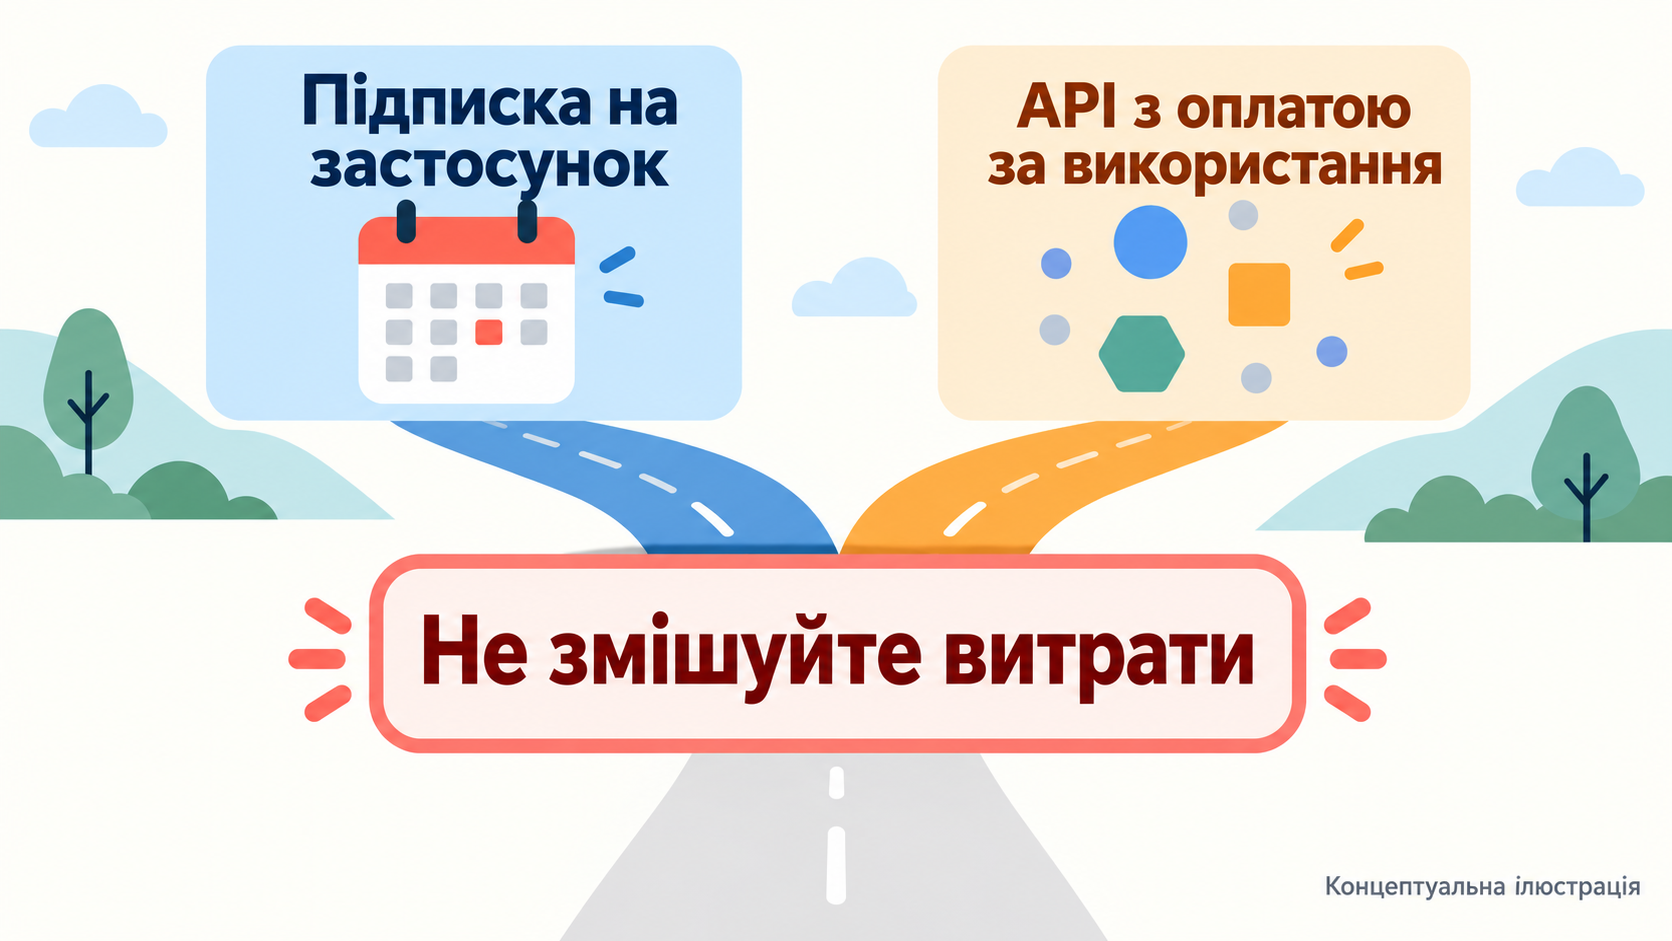
Рис.: згенерована ШІ схема підходів до білінгу, а не рахунок продукту; місячну плату за підписку не можна змішувати з ціною API. Переглянути зображення в оригінальному розмірі (1672×941).

Як вибрати за завданням? Спершу використовуйте моделі, доступні вам зараз
Завдання охоплює кілька програм або потребує перегляду вебсторінок, роботи з інтерфейсом і складних суджень: спершу спробуйте GPT-6 Astra. OpenAI визначає роботу з комп’ютером, перегляд вебсторінок, складне програмування та професійні документи як його ключові здібності. Якщо у вас уже є відповідний платний акаунт ChatGPT або доступ до API, сьогодні можна дати йому реальне завдання й подивитися, чи результат відповідає вимогам. Опис моделі OpenAI.
Завдання — це програмування, рецензування коду або робота з великими документами протягом кількох годин: спершу спробуйте Claude Fable 5.1. Anthropic позиціонує його для тривалих автономних завдань, складного програмування й досліджень. Ті, хто вже має робочий процес Claude Code, можуть спершу використовувати звичні інструменти, але слід спочатку переконатися, чи не списуються додаткові кредити за тарифом; якщо такі завдання потрібно запускати багато щодня, тоді порівняйте реальну вартість Max і API. Опис моделі Anthropic.
Хочете спробувати Gemini 4 Argon: спершу переконайтеся, чи маєте офіційний доступ. Google оголосив напрями, серед яких складне програмування, корпоративна робота зі знаннями та завдання захисної безпеки, і навів заплановані ціни; на це варто звернути увагу, але це ще не замінює фактичного досвіду звичайних користувачів. Якщо доступу немає, не рекомендується змінювати поточний робочий процес через «очікувану дешевизну» Argon. Офіційне оголошення Google.
Ці поради не означають, що «модель, яка добре вміє один тип завдань, може робити лише його». Якщо згодом усі три стануть доступними, найнадійніший спосіб вибору такий: візьміть те саме реальне завдання, дайте однакові матеріали й критерії приймання, окремо запишіть, чи виконано завдання, обсяг ручного доопрацювання, витрачений час і загальні витрати. Один гарний демонстраційний приклад або окремі результати бенчмарків від різних постачальників не можуть прямо довести, що ваше завдання дасть такий самий результат.
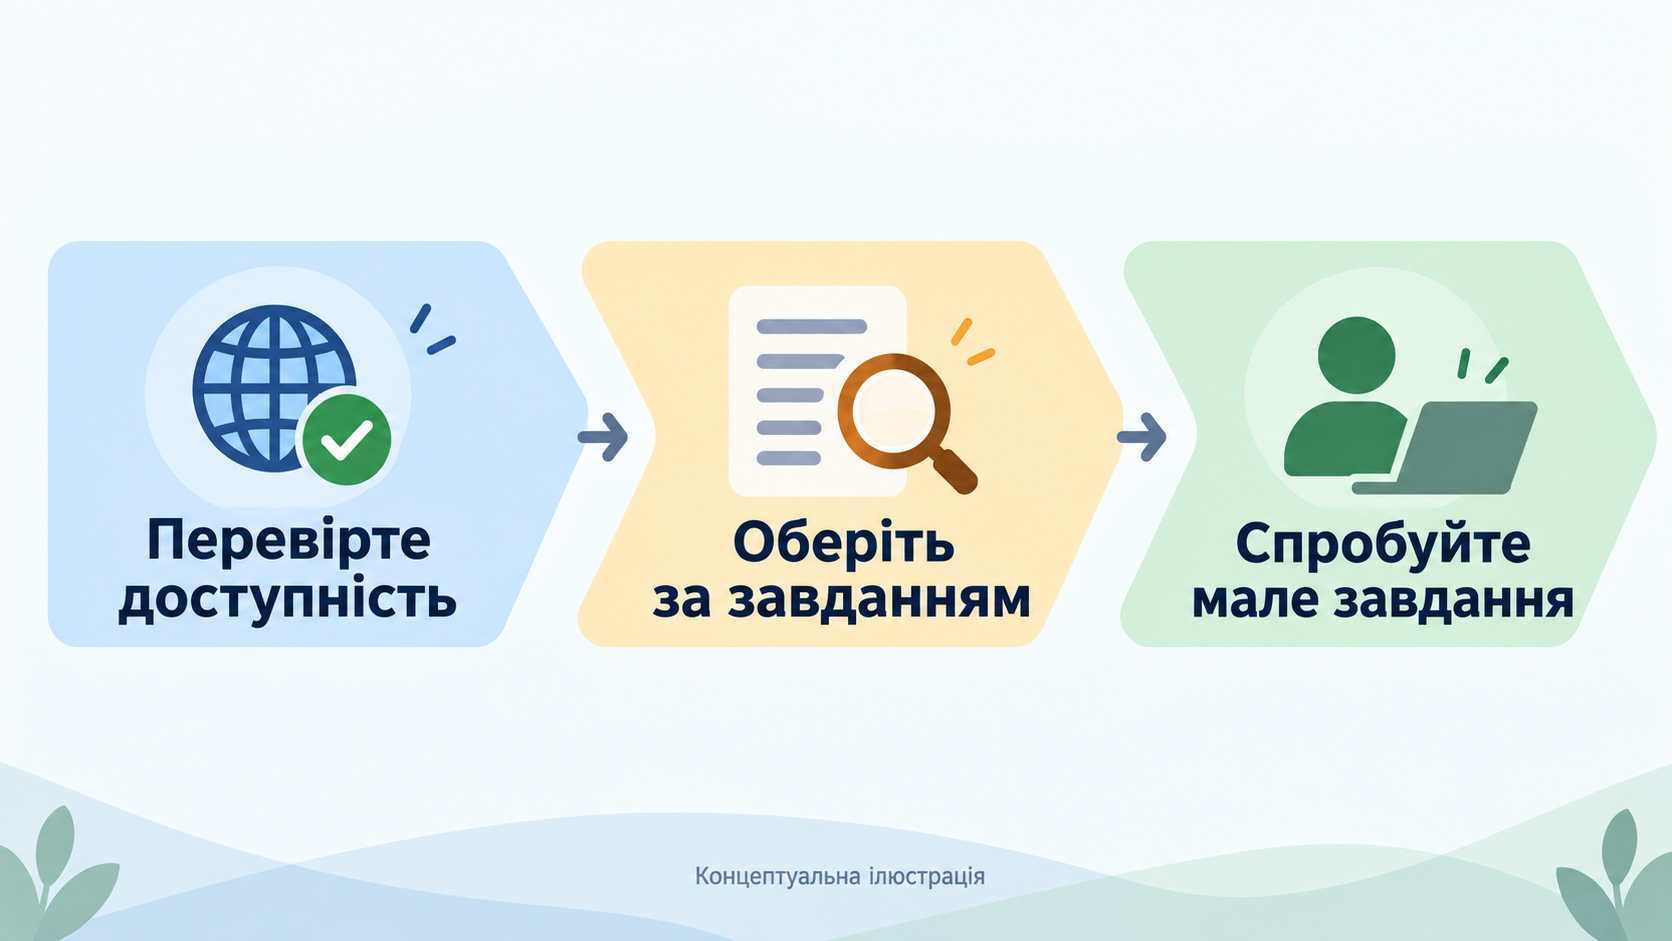
Рис.: згенерована ШІ схема шляху вибору: спершу подивіться на доступність акаунта й регіону, потім на потреби завдання, і нарешті перевірте на власному невеликому завданні. Фраза «у цій статті не проводиться жодного порівняльного тестування» означає, що ми не запускали власних тестів в однакових умовах; таблиця результатів вище — це відтворення даних, опублікованих Google. Переглянути зображення в оригінальному розмірі (1672×941).

Якщо ваше завдання — розподілити роботу між двома помічниками з програмування, дивіться посібник із спільної роботи Claude Code і Codex; якщо потрібно передати конкретне питання на сторінку ChatGPT Pro, де ви вже ввійшли, дивіться посібник, як Codex і Claude Code звертаються по допомогу до ChatGPT Pro. Ці дві статті описують операції робочого процесу й не означають, що Gemini 4 Argon уже підключено до PandaNpc.
FAQ
Gemini 4 Argon уже офіційно випущено, чому я не можу його знайти?
«Випуск» означає, що Google оголосив модель і відкрив до неї обмежений доступ; офіційне оголошення ще не наводить єдиної дати відкриття для всіх розробників і звичайних споживачів. Спершу перегляньте офіційний список моделей у продукті Gemini та акаунті, якими користуєтеся, і не вважайте чутки про «Gemini 4 Pro» доступним входом до Argon.
Astra — це Google Project Astra?
Ні. GPT-6 Astra у цій статті — це модель OpenAI; Google Project Astra — це інший дослідницький проєкт, і його не можна змішувати з таблицею цін трьох моделей.
Якщо я оформив Claude Pro, чи можу використовувати Fable 5.1 у межах лімітів тарифу?
Не обов’язково. Чинний опис тарифів від Anthropic зазначає, що для використання Fable 5.1 у Pro потрібні usage credits, а деякі тарифи, як-от Max, можуть використовувати його в межах обмеженого тижневого ліміту. Перед оплатою перегляньте свою сторінку «Використання/кредити».
Чи можна прямо за наведеними цінами визначити, хто найвигідніший?
Ні. Таблиця API порівнює лише номінальні ціни; на виконання завдання також впливають довжина входу, чи потрапив повторюваний вміст у кеш, витрати на інструменти, кількість раундів запуску та доопрацювання. Особливо Argon ще не відкрито широко, тому ми не можемо навести власну «вартість кожного успішного завдання».
Пов'язані посібники

GPT-6 Sol vs Claude Opus 5.5: ціни, результати бенчмарків і як обирати для задач програмування?
Для типових завдань програмування з API спершу спробуйте GPT-6 Sol; для складних завдань можна порівняти Claude Opus 5.5, а GPT-6 Astra і Claude Fable 5.1 — як варіанти для високої складності. У цій статті перевірено офіційні специфікації чотирьох моделей, ціни на кешування та Batch, сторонні бенчмарки за єдиною методологією, а також наведено п’ять сценаріїв витрат, які можна перерахувати.
Читати статтю →
Claude Code vs Codex: функції, віддалене керування, дозволи та сценарії використання — як обрати (2026)
Висновок: Claude Code — для глибокої роботи в терміналі, Hooks та екосистеми Claude; Codex — для ChatGPT, хмарних завдань і кількох Agent; PandaNpc — для віддаленого керування обома з Windows, macOS, Linux і телефона.
Читати статтю →
Як користуватися ChatGPT Pro з Codex і Claude Code у PandaNpc
У діалозі Codex або Claude Code у PandaNpc можна передати конкретне запитання на вебсторінку ChatGPT Pro, де ви вже увійшли в систему, і відповідь повернеться до вихідного діалогу.
Читати статтю →