
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 : comment choisir ? Comparaison de la disponibilité, des prix et des cas d’usage
Gemini 4 Argon à disponibilité limitée ; GPT-6 Astra et Claude Fable 5.1, disponibles, à choisir selon tâche et forfait, prix API/abonnements séparés, données officielles non test identique.
Vérification des informations : 30 septembre 2026 (UTC). PandaNpc fournit des services d’agents IA, ce qui est lié au choix de modèles. Cet article rassemble les informations publiques des trois entreprises et donne des recommandations de choix selon la tâche ; nous n’avons pas encore obtenu d’accès d’essai à Gemini 4 Argon, nous n’avons pas réalisé de test comparatif des trois modèles dans des conditions identiques. Dans la suite, « adapté » renvoie au positionnement officiel et à la disponibilité actuelle, et ne signifie pas que nous ayons mesuré lequel est le plus performant.
Conclusion d’abord : si vous devez l’utiliser dès aujourd’hui, choisissez d’abord entre GPT-6 Astra et Claude Fable 5.1 selon la tâche et votre offre existante ; Gemini 4 Argon n’est actuellement ouvert qu’à un petit nombre de testeurs de confiance, et les utilisateurs ordinaires ne peuvent pas encore le considérer comme une troisième option toujours disponible. Pour des opérations inter-logiciels, la synthèse de documents complexes ou la programmation difficile, vous pouvez d’abord essayer Astra ; pour de la programmation longue durée, la lecture répétée de grands projets ou de documents complexes, vous pouvez d’abord essayer Fable 5.1. Une fois Argon largement ouvert, comparez avec les mêmes tâches la qualité réelle d’exécution et le coût total.
Voir la couverture PNG en taille originale (1672×941)
D’abord, vérifiez si vous pouvez les utiliser : les trois modèles ne sont pas sur la même ligne de départ
| Modèle | Date de publication officielle | Qui peut l’utiliser au 30 septembre | Ce que cela signifie pour le lecteur ordinaire |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | D’abord ouvert aux défenseurs et testeurs de cybersécurité de confiance du projet Google Fairwind ; l’ouverture large aux développeurs, aux entreprises et aux consommateurs attend encore des phases ultérieures | Voir aujourd’hui « déjà publié » ne signifie pas que votre compte Gemini ou votre API peut déjà sélectionner Argon |
| GPT-6 Astra | 2026-09-03 | Déployé par étapes auprès des utilisateurs payants de ChatGPT et des utilisateurs de l’API, le quota disponible dépendant de l’offre et du compte | Vous pouvez vérifier votre liste de modèles et votre quota d’utilisation, puis commencer immédiatement une tâche réelle |
| Claude Fable 5.1 | 2026-09-01 | Disponible avec les offres payantes Claude et l’API Claude, mais des offres comme Pro peuvent nécessiter des crédits d’utilisation supplémentaires | Vérifiez d’abord les règles d’utilisation de Fable dans votre offre, puis décidez si vous devez passer à une offre supérieure ou payer en plus |
L’annonce de Gemini 4 Argon par Google indique qu’il s’agit actuellement d’une ouverture à petite échelle, avec l’intention d’élargir à l’avenir en commençant par les utilisateurs payants de l’API et les abonnés Google AI Ultra ; aucune date précise de disponibilité pour les utilisateurs ordinaires n’est annoncée. L’annonce d’Astra par OpenAI et les explications d’Anthropic sur Fable 5.1 précisent chacune la portée actuelle de l’ouverture. Ici, Astra est un modèle OpenAI, et non le projet de recherche Project Astra de Google.
Comparaison des paramètres : ne confondez pas « combien il peut lire » et « combien il peut écrire »
La fenêtre de contexte d’entrée correspond à la quantité d’informations que l’on peut confier au modèle en une fois ; la sortie maximale correspond à la quantité maximale de contenu qu’il peut générer en une fois. Ces deux chiffres ne sont pas interchangeables, et l’on ne peut pas juger la qualité des réponses sur les seuls chiffres. Les éléments ci-dessous sont des informations vérifiées le 30 septembre 2026 pour des modèles précis, et non des spécifications génériques pour toute la famille Gemini, GPT ou Claude.
| Paramètre | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Fenêtre de contexte d’entrée | Limite officielle non publiée | 1 050 000 token | 1 000 000 token |
| Sortie maximale unique | L’annonce Google indique 1 000 000 token ; les utilisateurs ordinaires ne peuvent pas encore le vérifier | 128 000 token | 128 000 token |
| Entrées pouvant être confiées au modèle | L’annonce présente la compréhension multimodale et de longues vidéos, mais la liste complète des types d’entrée API n’est pas publiée | Texte, images | Texte, images |
| Point d’accès officiel actuel | Testeurs de confiance Fairwind ; date d’ouverture large non publiée | Comptes payants ChatGPT selon le déploiement et l’offre, API OpenAI | Produits payants Claude et API Claude ; des offres comme Pro ont des conditions de crédits supplémentaires |
Sources : annonce de Gemini 4 Argon par Google, page du modèle GPT-6 Astra d’OpenAI, page du modèle Claude Fable 5.1 d’Anthropic et explications d’Anthropic sur les offres. Le « 1 million » de l’annonce Google désigne la limite de sortie, et ne doit pas être pris pour une « fenêtre de contexte d’entrée de 1 million » déjà annoncée pour Argon. La fiche modèle publique complète d’Argon et les tests par des utilisateurs ordinaires restent à publier ; dans le tableau, « non publié » ne signifie pas « cette capacité n’existe pas ».
Le tableau ci-dessus compare des spécifications publiques, pas une victoire de performance : pouvoir contenir plus de contenu ne garantit pas des réponses plus exactes. Le tableau ci-dessous présente les résultats des benchmarks de performance.
Comparaison des scores officiels : regardez des tâches précises, ne cherchez pas de « champion général »
Google DeepMind a publié un tableau de scores à quatre modèles sur la page officielle du modèle Gemini 4 Argon. Ici, nous ne retirons que les trois colonnes Argon, GPT-6 Astra et Claude Fable 5.1 dont parle cet article ; le tableau original inclut aussi Claude Opus 5.5. Les résultats ci-dessous proviennent de la page du site officiel de Google effectivement consultée le 30 septembre 2026 à 23:42 UTC, compilés par Google, et non issus d’un test PandaNpc dans des conditions identiques. Sauf pour les lignes indiquant F1, un taux de réussite ou un score partiel, les valeurs reprennent les pourcentages du tableau original ; pour chaque ligne, seule la valeur la plus haute parmi ces trois modèles est mise en gras. « — » signifie que le tableau original ne comportait pas de résultat comparable, et non un score de 0.
| Groupe de capacités | Benchmark (élément de test) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Travail de connaissance | Vals Index | 68,9 % | 63,1 % | 65,8 % |
| Travail de connaissance | AutomationBench | 51,3 % | 41,4 % | 31,4 % |
| Travail de connaissance | Vals Finance Agent v2 | 65,4 % | 53,5 % | 58,9 % |
| Travail de connaissance | Harvey's Legal Agent Benchmark | 19,6 % | 5,4 % | 6,7 % |
| Programmation automatique | DeepSWE v1.1 | 77,9 % | 74,1 % | 67,4 % |
| Programmation automatique | FrontierSWE v2 | 55,0 % | 65,5 % | 56,3 % |
| Programmation automatique | Vibe Code Bench | 91,9 % | 89,6 % | 90,3 % |
| Programmation automatique | Terminal-bench 4.0 | 57,4 % | 58,2 % | 57,9 % |
| Ingénierie du machine learning | PostTrainBench | 45,3 % | 44,3 % | 40,2 % |
| Science et mathématiques | Terminal-Bench Science 0.1 | 57,6 % | 68,1 % | 52,6 % |
| Science et mathématiques | LABBench 2 | 88,8 % | 85,4 % | 68,6 % |
| Science et mathématiques | RiemannBench | 76,0 % | 72,0 % | 65,6 % |
| Texte long | GraphWalks (≤128K, BFS F1) | 99,7 % | 98,7 % | 91,4 % |
| Texte long | GraphWalks (256K–1M, BFS F1) | 84,2 % | 71,8 % | 65,0 % |
| Opérations sur ordinateur | Agent's Last Exam (taux de réussite) | 39,5 % | 34,2 % | — |
| Opérations sur ordinateur | OSWorld-2.0 (sous-ensemble hors ligne, score partiel) | 69,2 % | 72,6 % | — |
| Compréhension d’images et de textes | Chartography | 71,6 % | 71,0 % | 46,2 % |
| Compréhension vidéo | LVBench | 91,7 % | 87,5 % | 79,7 % |
| Sécurité défensive | CWE-bench v1 | 68,0 % | 68,0 % | 58,0 % |
Comment utiliser ce tableau ? Si vous faites du travail de connaissance, regardez d’abord Vals Index et Finance Agent ; pour écrire du code, regardez à la fois DeepSWE, FrontierSWE et Terminal-bench, ne choisissez pas une seule ligne : Argon mène sur DeepSWE, mais Astra est plus haut sur FrontierSWE et Terminal-bench. Pour les opérations sur ordinateur, faites particulièrement attention : les deux lignes de Fable dans ce tableau Google sont absentes, ce qui ne permet pas de dire qu’il ne sait pas opérer un ordinateur. CWE-bench montre qu’Argon et Astra sont à égalité parmi les trois ; ce n’est pas non plus une garantie pour un travail de sécurité réel.
Méthodologie de test : Les explications de Google sur la méthode d’évaluation indiquent que les scores d’Argon correspondent généralement à une tentative unique et au niveau de réflexion le plus élevé ; les données des autres modèles proviennent souvent d’auto-déclarations de chaque fournisseur ou de classements publics, et peuvent aussi utiliser leur niveau de réflexion maximal ou disponible. Certains projets ont été exécutés par Google, d’autres proviennent de tiers, et l’environnement d’outils comme les méthodes d’échantillonnage ne sont pas partout identiques. Par exemple, les scores DeepSWE et Terminal-bench d’Argon sont des auto-tests de Google, tandis que les autres modèles utilisent des scores publics ; LVBench extrait un nombre d’images vidéo différent selon les modèles. La ligne GraphWalks utilise le BFS F1, et la ligne OSWorld ne représente qu’un « score partiel » du sous-ensemble hors ligne. On ne peut pas faire une moyenne entre les lignes ni affirmer sur cette base un premier global dans des conditions de test unifiées. La page de résultats de ce PDF de méthodologie indique par ailleurs « jusqu’en octobre 2026 », ce qui ne correspond pas à la date de consultation du tableau le 30 septembre dans cet article ; la date exacte d’achèvement des évaluations n’a pas pu être confirmée. Cet article ne fait que retranscrire les scores visibles sur le site officiel à ce moment-là, sans déduire quand l’évaluation a été réalisée, et sans les présenter comme des résultats que nous aurions reproduits.
Comment comparer les prix : il faut séparer les abonnements mensuels et les frais d’API
Si vous souhaitez seulement l’utiliser dans un produit de chat ou un outil de programmation, regardez d’abord l’abonnement et le quota d’utilisation. Parmi les prix publics aux États-Unis, ChatGPT Plus est à 20 $/mois, et Pro se décline en paliers de 100 $, 200 $, 500 $/mois, etc. ; l’usage précis d’Astra varie selon l’offre et la tâche. Les explications d’OpenAI sur les prix et l’usage de ChatGPT Work/Codex rappellent explicitement que le tarif API par million de tokens ne permet pas de calculer combien de tâches peuvent être réalisées dans un abonnement.
Le prix mensuel de Claude Pro aux États-Unis est de 20 $, et Max commence à 100 $/mois (grille tarifaire officielle de Claude). Mais « Pro peut choisir Fable 5.1 » ne signifie pas que Fable est inclus dans le quota normal de Pro : les règles d’Anthropic sur les offres Fable indiquent que l’utilisation de Fable 5.1 avec Pro et les sièges standard Team passe par des usage credits supplémentaires ; Max et les sièges avancés peuvent l’utiliser dans une partie du quota hebdomadaire. Google n’a pas encore donné de prix d’abonnement réel ni de date d’ouverture pour l’utilisation d’Argon par les utilisateurs ordinaires ; on ne peut pas prendre le prix mensuel actuel de Google AI Ultra comme une offre pour « acheter Argon aujourd’hui ».
Si vous payez à l’usage via l’API, ce qui suit constitue le tarif texte standard lisible dans la même unité. L’entrée désigne le contenu que vous confiez au modèle pour qu’il le lise, et la sortie désigne la réponse qu’il génère. L’unité est dans tous les cas le prix en dollars pour 1 million de tokens (le token est l’unité de découpage du texte et d’autres contenus pour la facturation) ; Argon dans le tableau est le prix de mise en service future annoncé par Google, et non une facture réelle que nous aurions déjà payée aujourd’hui.
| Modèle | Entrée normale | Sortie normale | Lecture du cache pour contenu répété | Statut |
|---|---|---|---|---|
| Gemini 4 Argon | Tarif initial provisoire 2 $ ; 4 $ après la période promotionnelle | Tarif initial provisoire 10 $ ; 20 $ après la période promotionnelle | Google annonce une remise de 95 % sur l’entrée mise en cache au prix d’entrée normal pour le lancement ; règles précises de mise en service à vérifier | Pas encore largement disponible |
| GPT-6 Astra | 10 $ | 50 $ | 1 $ | Prix API standard actuel |
| Claude Fable 5.1 | 10 $ | 50 $ | 0,25 $ | Prix API standard actuel |
Les données proviennent de l’annonce de lancement d’Argon par Google, de la page tarifaire du modèle Astra d’OpenAI et de la page du modèle Fable 5.1 d’Anthropic. Les prix n’incluent pas les outils supplémentaires, les régions, les paliers de vitesse ou les différences de plateforme ; pour Astra, lorsque l’entrée unique dépasse 272K tokens, l’entrée et le prix du cache de la requête entière sont facturés au double, et la sortie à 1,5 fois. Le prix du cache ne s’applique qu’au contenu ayant réellement atteint le cache ; on ne peut pas estimer toute une tâche au prix du cache. Même si le prix unitaire provisoire d’Argon est inférieur à celui des deux autres, sans données de taux de réussite et de consommation sur les mêmes tâches, on ne peut pas affirmer qu’il est le moins cher pour accomplir une tâche.
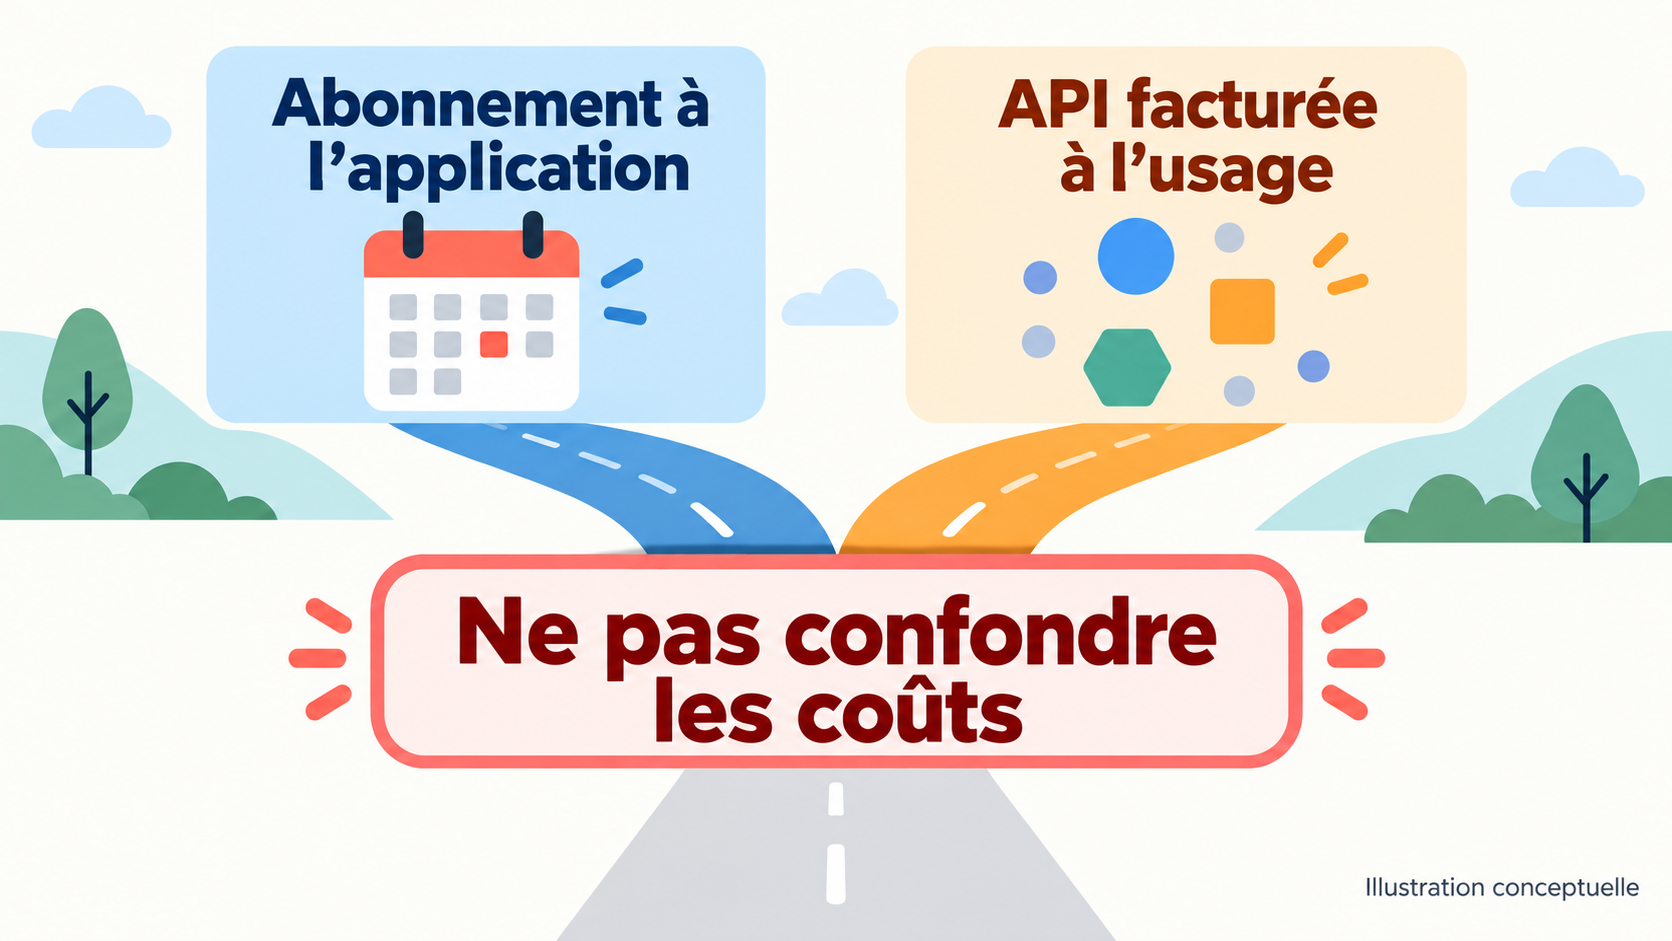
Figure : schéma de facturation généré par IA, et non une facture produit ; le prix mensuel de l’abonnement ne doit pas être mélangé avec le prix unitaire de l’API. Voir l’image en taille originale (1672×941).

Comment choisir selon la tâche ? Commencez par les modèles dont vous disposez
Si la tâche traverse plusieurs logiciels, ou nécessite de naviguer sur le Web, d’interagir avec une interface et de prendre des décisions complexes : essayez d’abord GPT-6 Astra. OpenAI classe les opérations sur ordinateur, la navigation, la programmation difficile et les documents professionnels parmi ses capacités clés. Si vous disposez déjà d’un compte payant ChatGPT approprié ou d’un accès API, vous pouvez dès aujourd’hui lui confier une tâche réelle et voir si le résultat répond aux exigences. Explications du modèle OpenAI.
Si la tâche est de la programmation, de la revue de code ou du travail sur de grands documents pendant plusieurs heures : essayez d’abord Claude Fable 5.1. Anthropic le positionne sur les tâches autonomes de longue durée, la programmation complexe et la recherche. Ceux qui ont déjà un flux de travail Claude Code peuvent d’abord réutiliser les outils familiers, mais doivent vérifier si l’offre déduit des crédits d’utilisation supplémentaires ; si vous devez lancer beaucoup de tâches de ce type chaque jour, comparez ensuite le coût réel de Max et de l’API. Explications du modèle Anthropic.
Si vous voulez essayer Gemini 4 Argon : vérifiez d’abord si vous avez obtenu un accès officiel. Les orientations annoncées par Google incluent la programmation complexe, le travail de connaissance en entreprise et les tâches de sécurité défensive, avec un prix provisoire ; cela mérite attention, mais ne remplace pas encore l’expérience de test d’un utilisateur ordinaire. Sans autorisation, il n’est pas conseillé de modifier un flux de travail en cours pour l’« avantage de prix attendu » d’Argon. Annonce officielle de Google.
Ces recommandations ne signifient pas qu’« un modèle doué pour un type de tâche ne peut faire que ce type de tâche ». Si les trois modèles deviennent disponibles à l’avenir, la méthode de choix la plus fiable consiste à prendre une même tâche réelle, à fournir les mêmes documents et les mêmes critères d’acceptation, puis à noter séparément si la tâche est accomplie, les reprises manuelles, le temps passé et le coût total. Une belle démonstration ou les scores respectifs de différents éditeurs ne prouvent pas directement que votre tâche donnera le même résultat.
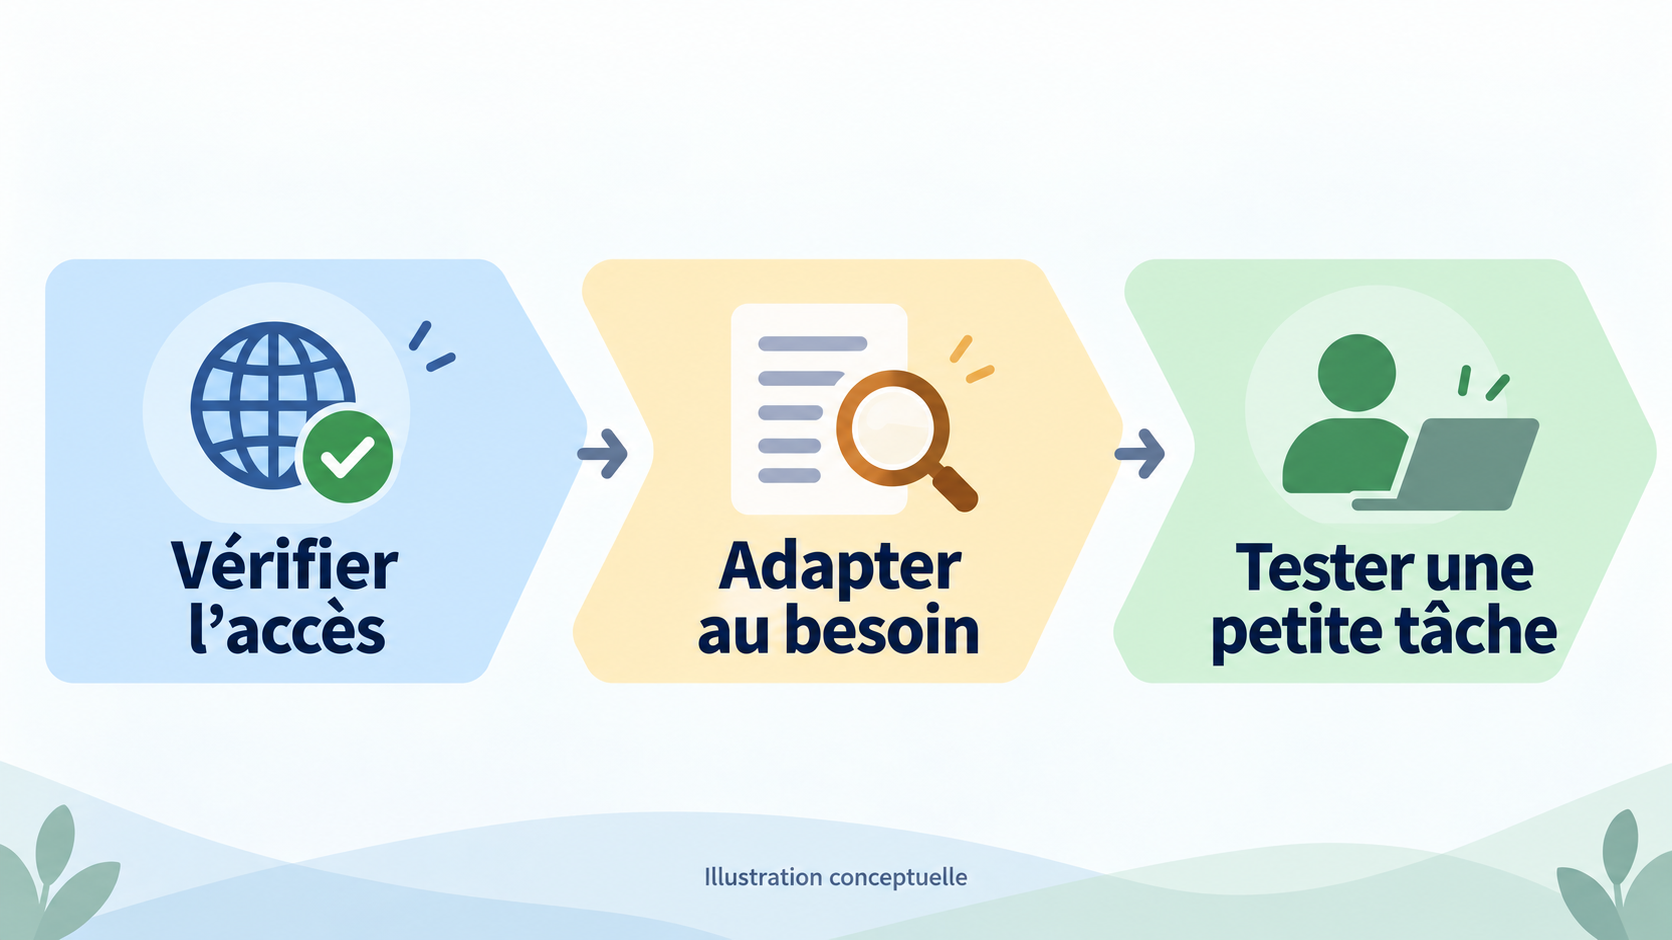
Figure : schéma de parcours de choix généré par IA : vérifiez d’abord la disponibilité du compte et de la région, puis les besoins de la tâche, et enfin validez avec votre propre petite tâche. Dans l’image, « cet article ne réalise aucun test comparatif » signifie que nous n’avons pas exécuté nous-mêmes de test dans des conditions identiques ; le tableau de scores ci-dessus retranscrit les données publiées par Google. Voir l’image en taille originale (1672×940).

Si votre tâche consiste à répartir le travail entre deux assistants de programmation, consultez le tutoriel de collaboration entre Claude Code et Codex ; si vous voulez confier une question précise à une page ChatGPT Pro déjà connectée, consultez le tutoriel pour demander de l’aide à ChatGPT Pro depuis Codex et Claude Code. Ces deux articles présentent des opérations de flux de travail et ne signifient pas que Gemini 4 Argon est intégré à PandaNpc.
FAQ
Gemini 4 Argon est déjà officiellement publié, pourquoi je ne le trouve pas ?
« Publié » signifie que Google a annoncé le modèle et l’a ouvert à un périmètre limité ; l’annonce officielle n’a pas encore donné de date d’ouverture uniforme pour tous les développeurs et consommateurs ordinaires. Vérifiez d’abord la liste officielle des modèles de votre produit et compte Gemini, et ne prenez pas le « Gemini 4 Pro » dont parlent les rumeurs pour une entrée disponible d’Argon.
Astra est-il le Project Astra de Google ?
Non. Dans cet article, GPT-6 Astra est un modèle OpenAI ; Google Project Astra est un autre projet de recherche, à ne pas mélanger dans le tableau de prix des trois modèles.
Avec un abonnement Claude Pro, puis-je utiliser Fable 5.1 dans le quota de l’offre ?
Pas nécessairement. Les explications actuelles d’Anthropic sur les offres indiquent que l’utilisation de Fable 5.1 avec Pro nécessite des usage credits, tandis que certaines offres comme Max permettent de l’utiliser dans un quota hebdomadaire limité. Avant de payer, consultez votre page « utilisation/crédits ».
Peut-on déterminer directement qui est le plus avantageux d’après les prix ci-dessus ?
Non. Le tableau API ne compare que les prix affichés ; l’accomplissement d’une tâche dépend aussi de la longueur de l’entrée, du fait que le contenu répété atteint ou non le cache, des frais d’outils, du nombre de tours d’exécution et des reprises. En particulier, Argon n’est pas encore largement disponible, et nous ne pouvons pas donner notre propre « coût par tâche réussie ».
Guides associés

GPT-6 Sol vs Claude Opus 5.5 : prix, benchmarks et tâches de programmation : comment choisir ?
Pour les tâches de programmation API courantes, commencez par essayer GPT-6 Sol ; pour les tâches complexes, comparez Claude Opus 5.5, puis considérez GPT-6 Astra et Claude Fable 5.1 comme options pour les cas très difficiles. Cet article vérifie les spécifications officielles des quatre modèles, les tarifs de mise en cache et de Batch, des benchmarks tiers à méthodologie identique, et propose cinq scénarios de coûts recalculables.
Lire l'article →
Claude Code vs Codex : fonctionnalités, contrôle à distance, permissions et cas d'usage — comment choisir (2026)
En bref : Claude Code pour le terminal avancé, les Hooks et l’écosystème Claude ; Codex pour ChatGPT, le cloud et le multi-Agent ; PandaNpc pour piloter les deux à distance sur Windows, macOS, Linux et mobile.
Lire l'article →
Utiliser ChatGPT Pro avec Codex et Claude Code dans PandaNpc
Dans une conversation Codex ou Claude Code de PandaNpc, vous pouvez confier une question précise à la page web ChatGPT Pro déjà connectée, et la réponse reviendra dans la conversation d'origine.
Lire l'article →