
Gemini 4 Argon、GPT-6 Astra、Claude Fable 5.1 怎么选?可用性、价格与适用场景对比
截至2026年9月30日,Gemini 4 Argon仅向可信测试者开放;GPT-6 Astra与Claude Fable 5.1已有付费入口。对照官方规格、订阅和API价格及不同口径的基准成绩,再按自己的任务与额度选择。
资料核查:2026 年 9 月 30 日(UTC)。 PandaNpc 提供 AI Agent 服务,与模型选型相关。本文整理三家公司公开的信息,并给出按任务选择的建议;我们尚未取得 Gemini 4 Argon 的试用权限,没有做三款模型的同条件实测。下文的“适合”指官方定位与当前可用性,不代表我们测出了谁更强。
先说结论:今天就要用,先在 GPT-6 Astra 和 Claude Fable 5.1 之间按任务与现有套餐选择;Gemini 4 Argon 目前只向少量可信测试者开放,普通用户还不能把它当作随时可选的第三项。 做跨软件操作、复杂资料整理或高难编程,可以先试 Astra;长期编程、反复阅读大型项目或复杂文档,可以先试 Fable 5.1。等 Argon 普遍开放后,再用相同任务比实际完成质量和总花费。
先看能不能用:三款模型并不在同一个起跑线
| 模型 | 官方发布日期 | 截至 9 月 30 日谁能用 | 对普通读者意味着什么 |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | 先向 Google Fairwind 项目的可信网络防御者与测试者开放;开发者、企业及消费者的广泛开放尚待后续阶段 | 今天看到“已发布”,不等于你的 Gemini 账号或 API 已能选择 Argon |
| GPT-6 Astra | 2026-09-03 | 已向 ChatGPT 付费用户及 API 用户分阶段推出,具体可用额度取决于套餐和账号 | 可以检查自己的模型列表与使用额度,立即开始实际任务 |
| Claude Fable 5.1 | 2026-09-01 | Claude 付费套餐及 Claude API 可用,但 Pro 等套餐可能需要额外使用积分 | 先查套餐的 Fable 使用规则,再决定是否升级或另付费 |
Google 的 Gemini 4 Argon 公告写明目前是小范围开放,未来计划从付费 API 用户和 Google AI Ultra 订阅者开始扩大;没有公布普通用户可使用的确定日期。OpenAI 的 Astra 公告和Anthropic 的 Fable 5.1 说明分别说明现有开放范围。这里的 Astra 是 OpenAI 模型,不是 Google 的 Project Astra 研究项目。
参数对照:别把“能读多少”与“能写多少”混为一谈
输入上下文窗口是一次能交给模型多少资料;最大输出是它一次最多能生成多少内容。这两个数字不能互换,也不能单凭数字判断答案质量。以下均为 2026 年 9 月 30 日核到的具体型号信息,而非 Gemini、GPT 或 Claude 全家族的通用规格。
| 参数 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| 输入上下文窗口 | 正式上限未公布 | 1,050,000 token | 1,000,000 token |
| 单次最大输出 | Google 公告称 1,000,000 token;普通用户尚无法验证 | 128,000 token | 128,000 token |
| 可交给模型的输入 | 公告展示多模态与长视频理解,但完整 API 输入类型清单未公布 | 文本、图片 | 文本、图片 |
| 当前正式入口 | Fairwind 可信测试者;广泛开放时间未公布 | ChatGPT 付费账号按推出进度与套餐、OpenAI API | Claude 付费产品与 Claude API;Pro 等套餐有额外积分条件 |
来源:Google 的 Gemini 4 Argon 公告、OpenAI 的 GPT-6 Astra 型号页、Anthropic 的 Claude Fable 5.1 型号页与Anthropic 的套餐说明。Google 公告的“100 万”说的是输出上限,不能当成 Argon 已公布“100 万输入上下文窗口”。Argon 的完整公开型号卡和普通用户实测仍待发布;表中“未公布”不是“没有这项能力”。
上表比较的是公开规格,不是性能胜负:可容纳的内容越多,未必回答越准确。下表才是性能基准成绩。
官方跑分对比:看具体任务,别算“总冠军”
Google DeepMind 在 Gemini 4 Argon 官方型号页公布了一张四模型跑分表。这里只摘出本文讨论的 Argon、GPT-6 Astra、Claude Fable 5.1 三列;原表还包括 Claude Opus 5.5。以下成绩来自 2026 年 9 月 30 日 23:42 UTC 实际读取到的 Google 官网页面,由 Google 汇编,并非 PandaNpc 的同条件实测。除注明 F1、通过率或部分得分的行外,数值沿用原表百分比;每行只在这三款模型中把较高值加粗。“—”表示原表没有可比成绩,不是 0 分。
| 能力分组 | Benchmark(测试项目) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| 知识工作 | Vals Index | 68.9% | 63.1% | 65.8% |
| 知识工作 | AutomationBench | 51.3% | 41.4% | 31.4% |
| 知识工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| 知识工作 | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| 自动编程 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| 自动编程 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| 自动编程 | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| 自动编程 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| 机器学习工程 | PostTrainBench | 45.3% | 44.3% | 40.2% |
| 科学与数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| 科学与数学 | LABBench 2 | 88.8% | 85.4% | 68.6% |
| 科学与数学 | RiemannBench | 76.0% | 72.0% | 65.6% |
| 长文本 | GraphWalks(≤128K,BFS F1) | 99.7% | 98.7% | 91.4% |
| 长文本 | GraphWalks(256K–1M,BFS F1) | 84.2% | 71.8% | 65.0% |
| 电脑操作 | Agent's Last Exam(通过率) | 39.5% | 34.2% | — |
| 电脑操作 | OSWorld-2.0(离线子集,部分得分) | 69.2% | 72.6% | — |
| 图文理解 | Chartography | 71.6% | 71.0% | 46.2% |
| 视频理解 | LVBench | 91.7% | 87.5% | 79.7% |
| 防御性安全 | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
这张表怎么用? 如果你做知识工作,可先看 Vals Index、Finance Agent;写代码可同时看 DeepSWE、FrontierSWE 与 Terminal-bench,别只挑一行:Argon 在 DeepSWE 领先,但 Astra 在 FrontierSWE 与 Terminal-bench 更高。做电脑操作要特别留意,Fable 在这张 Google 表中的两行是缺失,不能因此说它不会操作电脑。CWE-bench 显示 Argon 与 Astra 在三者中并列;这也不是对真实安全工作的保证。
测试口径: Google 的评测方法说明写明,Argon 的成绩通常为单次尝试、最高思考档位;其他模型的数据多来自各供应商自报或公开榜单,也可能采用各自最高或可获得的思考档位。部分项目由 Google 自行跑,部分来自第三方,工具环境和采样方法并非处处相同。例如 DeepSWE 与 Terminal-bench 的 Argon 成绩是 Google 自测,其他模型用公开成绩;LVBench 对不同模型抽取的视频帧数不同。GraphWalks 行用的是 BFS F1,OSWorld 行只代表离线子集的“部分得分”。不能跨行求平均、不能据此宣称统一测试条件下的综合第一。这份方法 PDF 的结果页另写“截至 2026 年 10 月”,与本文 9 月 30 日读取到表格的时间不一致;具体评测完成日未能确认。本文仅转录当时官网可见的成绩,不推断评测何时完成,也不把它说成我们复现的结果。
价格怎么比:月费与 API 费用要分开
如果只想在聊天产品或编程工具中使用,先看订阅与使用额度。美国公开价格中,ChatGPT Plus 为 $20/月,Pro 分为 $100、$200、$500/月等档位;具体 Astra 用量随套餐和任务而变。OpenAI 的 ChatGPT Work/Codex 价格与用量说明明确提醒:API 每百万 token 的报价不能拿来推算订阅内能完成多少任务。
Claude Pro 美国月付价为 $20,Max 从 $100/月起(Claude 官方价格表)。但“Pro 可以选 Fable 5.1”不表示 Fable 已包含在 Pro 常规额度内:Anthropic 的 Fable 套餐规则说明,Pro 与 Team 标准席位使用 Fable 5.1 要走额外 usage credits;Max 与高级席位可在每周额度的一部分内使用。Google 尚未给出普通用户使用 Argon 的实际订阅价格或开放日期,不能把 Google AI Ultra 的现有月费当作“今天买 Argon”的报价。
如果通过 API 按使用量付费,下面才是可以同单位阅读的标准文本报价。输入指你交给模型阅读的内容,输出指它生成的回答。单位都是每 100 万 token 的美元价格(token 是计费时拆分文字等内容的单位);表中的 Argon 是 Google 公布的未来上线价格,不是我们今天已经支付的实测账单。
| 模型 | 普通输入 | 普通输出 | 重复内容的缓存读取 | 状态 |
|---|---|---|---|---|
| Gemini 4 Argon | 首发拟定 $2;优惠期后 $4 | 首发拟定 $10;优惠期后 $20 | Google 称首发缓存输入按普通输入价优惠 95%;具体上线规则待核 | 尚未广泛开放 |
| GPT-6 Astra | $10 | $50 | $1 | 当前 API 标准价格 |
| Claude Fable 5.1 | $10 | $50 | $0.25 | 当前 API 标准价格 |
数据来自Google 的 Argon 发布公告、OpenAI 的 Astra 模型价格页及Anthropic 的 Fable 5.1 模型页。价格不含额外工具、地区、速度档位或平台差异;Astra 在单次输入超过 272K token时,对整个请求的输入与缓存价格按 2 倍、输出按 1.5 倍计价。缓存价只适用于实际命中缓存的内容,不能把整份任务都按缓存价估算。即使 Argon 的拟定单价低于另外两款,没有同任务成功率与用量数据,也不能断言它完成一个任务最便宜。
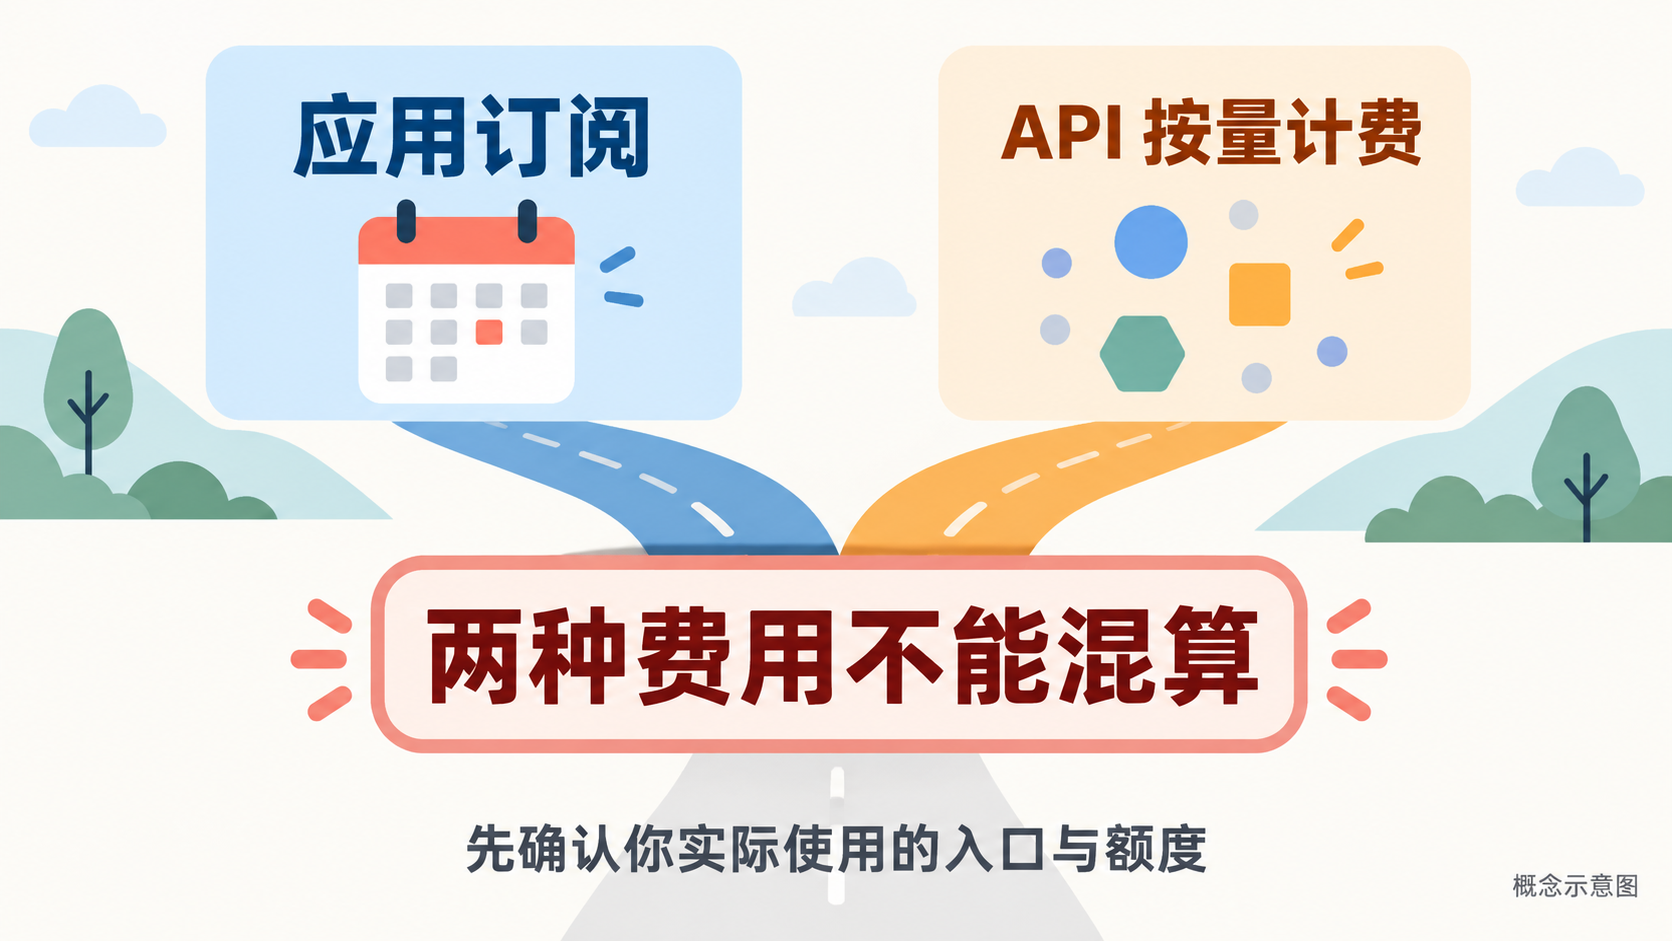
图:AI 生成的计费口径示意,不是产品账单;订阅月费不能与 API 单价混算。查看原尺寸图(1672×941)。

按任务怎么选?先用手头可用的模型
任务要跨多个软件,或需要浏览网页、操作界面并做复杂判断:先试 GPT-6 Astra。 OpenAI 把电脑操作、浏览、高难编程和专业文档列为它的重点能力。如果你已有合适的 ChatGPT 付费账号或 API 权限,今天就能把一个真实任务交给它,看结果是否达到要求。OpenAI 模型说明。
任务是持续数小时的编程、代码审查或大型文档工作:先试 Claude Fable 5.1。 Anthropic 将它定位于长时间自主任务、复杂编程与研究。已有 Claude Code 工作流的人可以先沿用熟悉的工具,但要先确认套餐是否另扣使用积分;若每天要跑很多此类任务,再比较 Max 与 API 的真实成本。Anthropic 模型说明。
想尝试 Gemini 4 Argon:先确认自己是否获得官方访问权限。 Google 公布的方向包括复杂编程、企业知识工作与防御性安全任务,并给出拟定价格;这些值得关注,但还不能替代普通用户的实测体验。没有权限时,不建议为了 Argon 的“预期更便宜”改变正在运行的工作流。Google 官方公告。
这些建议不是“模型擅长一类任务就只能做这一类”。如果三款将来都可用,最稳妥的选择方法是:拿同一份真实任务,给相同的资料和验收标准,分别记录是否完成、人工返工、耗时与总费用。一次漂亮的演示或不同厂商各自的跑分,不能直接证明你的任务也会得到同样结果。
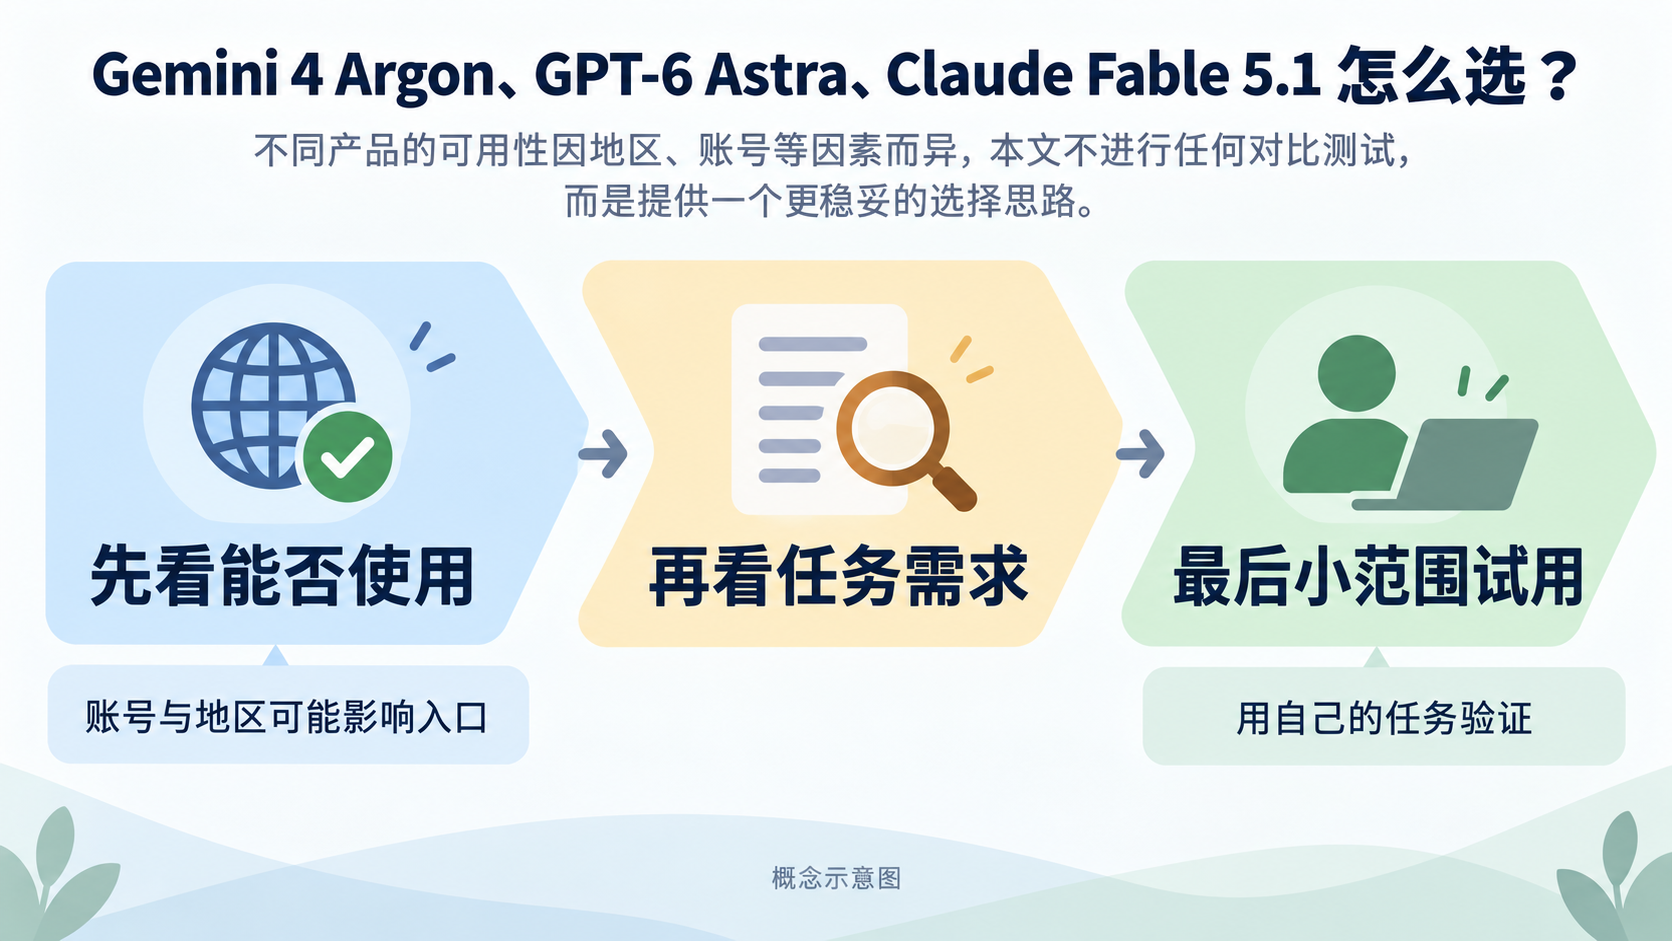
图:AI 生成的选择路径示意,先看账号与地区可用性,再看任务需求,最后用自己的小任务验证。图中的“本文不进行任何对比测试”是指我们未自行运行同条件测试;上文跑分表是转录 Google 公布的数据。查看原尺寸图(1672×941)。

如果你的任务是让两个编程助手分工,可看Claude Code 与 Codex 协作教程;如果要把具体问题交给已登录的 ChatGPT Pro 页面,可看Codex 和 Claude Code 向 ChatGPT Pro 求助教程。这两篇介绍工作流操作,不表示 Gemini 4 Argon 已接入 PandaNpc。
常见问题
Gemini 4 Argon 已经正式发布,为什么我找不到?
“发布”指 Google 公布了模型并向有限范围开放;官方公告尚未给出所有开发者和普通消费者的统一开放日期。先查看自己使用的 Gemini 产品与账号的正式模型列表,不要把传闻中的“Gemini 4 Pro”当作 Argon 的可用入口。
Astra 是 Google 的 Project Astra 吗?
不是。本文的 GPT-6 Astra 是 OpenAI 的模型;Google Project Astra是另一项研究项目,不能混在三模型价格表中。
订了 Claude Pro,就能在套餐额度内使用 Fable 5.1 吗?
不一定。Anthropic 的现行套餐说明表示,Pro 使用 Fable 5.1 需要 usage credits,而 Max 等部分套餐可在限定的每周额度内使用。付款前先看自己的“使用量/积分”页面。
能直接根据上面的价格判定谁最划算吗?
不能。API 表只比较标价;完成任务时还会受输入长度、重复内容是否命中缓存、工具费用、运行轮数和返工影响。尤其 Argon 尚未广泛开放,无法给出我们自己的“每个成功任务成本”。
相关文章

GPT-6 Sol vs Claude Opus 5.5:价格、跑分与编程任务怎么选?
一般 API 编程任务先试 GPT-6 Sol;复杂任务可对比 Claude Opus 5.5,再把 GPT-6 Astra 和 Claude Fable 5.1 作为高难度选项。本文核对四模型官方规格、缓存与 Batch 价格、同口径第三方跑分,并提供五组可复算费用场景。
阅读全文 →
Claude Code vs Codex:功能、远程控制、权限与使用场景怎么选(2026)
先给结论:深度终端、Hooks 和 Claude 生态选 Claude Code;ChatGPT 账号、云端任务和桌面多 Agent 选 Codex;要跨 Windows、macOS、Linux 与手机统一远程控制两者,选 PandaNpc。
阅读全文 →
怎么让 Codex 和 Claude Code 向 ChatGPT Pro 求助?PandaNpc 使用指南
在 PandaNpc 的 Codex 或 Claude Code 对话里,可以把一个具体问题交给已登录的 ChatGPT Pro 网页,回答会回到原对话。本文用英文界面截图讲清准备、开启、派工、查看结果与自动发送的选择,并标明演示数据的范围。
阅读全文 →