
Gemini 4 Argon, GPT-6 Astra vagy Claude Fable 5.1? Elérhetőség, ár és felhasználási esetek összehasonlítása
A Gemini 4 Argon korlátozottan elérhető; az elérhető GPT-6 Astra és Claude Fable 5.1 közül feladat és csomag szerint válassz, API-ár külön az előfizetéstől, hivatalos adat, nem azonos teszt.
Adatellenőrzés: 2026. szeptember 30. (UTC). A PandaNpc AI Agent szolgáltatásokat kínál, és ez kapcsolódik a modellválasztáshoz. Ez a cikk a három cég nyilvános információit rendszerezi, és feladatalapú választási javaslatokat ad; még nem kaptunk hozzáférést a Gemini 4 Argon próbájához, nem végeztünk azonos körülmények között végzett tesztet a három modellel. Az alábbi „alkalmas” a hivatalos pozicionálást és a jelenlegi elérhetőséget jelenti, nem azt, hogy megmértük, melyik erősebb.
Először a következtetés: ha ma kell használnia, először a GPT-6 Astra és a Claude Fable 5.1 között válasszon feladat és meglévő csomag alapján; a Gemini 4 Argon jelenleg csak kevés megbízható tesztelő számára elérhető, a hétköznapi felhasználók még nem tekinthetik a mindig elérhető harmadik opciónak. Több szoftveren átnyúló műveletekhez, összetett anyagok rendszerezéséhez vagy nehéz programozáshoz először próbálja ki az Astra-t; hosszú távú programozáshoz, nagy projektek vagy összetett dokumentumok ismételt elolvasásához először a Fable 5.1-et. Miután az Argon széles körben elérhetővé válik, ugyanazokkal a feladatokkal hasonlítsa össze a tényleges minőséget és teljes költséget.
Borító teljes méretű PNG megtekintése (1672×941)
Először nézze meg, használható-e: a három modell nem ugyanazon a rajtvonalon áll
| Modell | Hivatalos megjelenési dátum | Ki használhatja 2026. szeptember 30-án | Mit jelent ez a hétköznapi olvasónak |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Először a Google Fairwind projekt megbízható kibervédelmi szakemberei és tesztelői kapják meg; a fejlesztők, vállalatok és fogyasztók széles körű elérhetősége későbbi szakaszra vár | Az, hogy ma azt látja, „megjelent”, nem jelenti, hogy a Gemini-fiókjában vagy API-jában már választható az Argon |
| GPT-6 Astra | 2026-09-03 | Már szakaszosan bevezették a ChatGPT fizető felhasználói és API-felhasználói számára; a konkrét elérhető keret a csomagtól és a fióktól függ | Ellenőrizheti a saját modelllistáját és használati keretét, és azonnal elkezdhet valós feladatokat |
| Claude Fable 5.1 | 2026-09-01 | A Claude fizetős csomagjaiban és a Claude API-ban elérhető, de a Pro és hasonló csomagoknál további használati kreditek válhatnak szükségessé | Először nézze meg a csomag Fable használati szabályait, aztán döntsön a frissítésről vagy külön fizetésről |
A Google Gemini 4 Argon bejelentése szerint jelenleg szűk körben elérhető, és a jövőben a fizetős API-felhasználókkal és a Google AI Ultra előfizetőkkel kezdődően tervezik kiterjeszteni; nem hoztak nyilvánosságra biztos dátumot arra, mikor használhatják a hétköznapi felhasználók.Az OpenAI Astra bejelentése és az Anthropic Fable 5.1 leírása külön-külön ismerteti a jelenlegi elérhetőségi kört. Az itteni Astra OpenAI-modell, nem a Google Project Astra kutatási projektje.
Paraméter-összehasonlítás: ne keverje össze, „mennyit tud elolvasni” és „mennyit tud írni”
A bemeneti kontextusablak azt jelenti, mennyi anyagot lehet egyszerre a modellhez adni; a maximális kimenet pedig azt, hogy egyszerre legfeljebb mennyi tartalmat képes előállítani. Ez a két szám nem cserélhető fel, és önmagában a számokból nem lehet a válasz minőségére következtetni. Az alábbiak mind a 2026. szeptember 30-án ellenőrzött konkrét modelltípusok adatai, nem a teljes Gemini-, GPT- vagy Claude-család általános specifikációi.
| Paraméter | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Bemeneti kontextusablak | A hivatalos felső határ nem nyilvános | 1,050,000 token | 1,000,000 token |
| Egyszeri maximális kimenet | A Google bejelentése szerint 1,000,000 token; a hétköznapi felhasználók még nem tudják ellenőrizni | 128,000 token | 128,000 token |
| A modellnek átadható bemenet | A bejelentés multimodális és hosszú videós megértést mutat be, de a teljes API-bemenettípus-lista nem nyilvános | Szöveg, kép | Szöveg, kép |
| Jelenlegi hivatalos belépési pont | Fairwind megbízható tesztelői; a széles körű megnyitás időpontja nem nyilvános | ChatGPT fizetős fiókok a bevezetési ütem és a csomag szerint, OpenAI API | Claude fizetős termékek és Claude API; a Pro és hasonló csomagoknál további kreditek feltételei érvényesek |
Források: A Google Gemini 4 Argon bejelentése, az OpenAI GPT-6 Astra modelloldala, az Anthropic Claude Fable 5.1 modelloldala és az Anthropic csomagleírása. A Google bejelentésében az „1 millió” a kimeneti felső határra utal, nem értelmezhető úgy, hogy az Argon esetében már nyilvános az „1 millió tokenes bemeneti kontextusablak”. Az Argon teljes nyilvános adatlapja és a hétköznapi felhasználói tesztek még váratnak magukra; a táblázatban a „nem nyilvános” nem azt jelenti, hogy „nincs ilyen képesség”.
A fenti táblázat nyilvános specifikációkat hasonlít össze, nem a teljesítmény győztesét: minél több tartalom fér bele, az nem feltétlenül jelent pontosabb választ. Az alábbi táblázat mutatja a teljesítmény-benchmark eredményeket.
Hivatalos benchmark-összehasonlítás: nézze a konkrét feladatokat, ne a „végső bajnokot” számolja
A Google DeepMind a Gemini 4 Argon hivatalos modelloldalán közzétett egy négymodelles benchmark-táblázatot. Itt csak a cikkben tárgyalt Argon, GPT-6 Astra és Claude Fable 5.1 oszlopokat emeljük ki; az eredeti táblázat a Claude Opus 5.5-öt is tartalmazza. Az alábbi eredmények a 2026. szeptember 30-án 23:42 UTC-kor ténylegesen beolvasott Google weboldalról származnak, a Google állította össze őket, nem a PandaNpc azonos körülmények között végzett mérései. Az F1-et, áthaladási arányt vagy részeredményt jelölő sorok kivételével a számok az eredeti táblázat százalékai; minden sorban csak e három modell közül a magasabb értéket emeltük ki félkövéren. A „—” azt jelenti, hogy az eredeti táblázatban nincs összehasonlítható eredmény, nem 0 pontot.
| Képességcsoport | Benchmark (tesztprojekt) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Tudásmunka | Vals Index | 68.9% | 63.1% | 65.8% |
| Tudásmunka | AutomationBench | 51.3% | 41.4% | 31.4% |
| Tudásmunka | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| Tudásmunka | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| Automatikus programozás | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| Automatikus programozás | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| Automatikus programozás | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| Automatikus programozás | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| Gépi tanulási mérnöki munka | PostTrainBench | 45.3% | 44.3% | 40.2% |
| Tudomány és matematika | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| Tudomány és matematika | LABBench 2 | 88.8% | 85.4% | 68.6% |
| Tudomány és matematika | RiemannBench | 76.0% | 72.0% | 65.6% |
| Hosszú szöveg | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 91.4% |
| Hosszú szöveg | GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 65.0% |
| Számítógép-kezelés | Agent's Last Exam (áthaladási arány) | 39.5% | 34.2% | — |
| Számítógép-kezelés | OSWorld-2.0 (offline részhalmaz, részeredmény) | 69.2% | 72.6% | — |
| Kép-szöveg megértés | Chartography | 71.6% | 71.0% | 46.2% |
| Videómegértés | LVBench | 91.7% | 87.5% | 79.7% |
| Védelmi biztonság | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
Hogyan használja ezt a táblázatot? Ha tudásmunkát végez, először a Vals Indexet és a Finance Agentet nézze; kódíráshoz egyszerre nézze a DeepSWE-t, a FrontierSWE-t és a Terminal-bench-et, ne csak egy sort válasszon: az Argon vezet a DeepSWE-n, de az Astra magasabb a FrontierSWE-n és a Terminal-bench-en. A számítógép-kezelésnél különösen figyeljen oda: a Fable a Google e táblázatában két sorban hiányzik, ebből nem következik, hogy nem tud számítógépet kezelni. A CWE-bench azt mutatja, hogy az Argon és az Astra a három közül holtversenyben áll; ez sem garancia a valós biztonsági munkára.
Tesztmódszertan: A Google értékelési módszertani leírása szerint az Argon eredményei általában egyszeri próbálkozásból, a legmagasabb gondolkodási fokozaton származnak; a többi modell adatai többnyire a szállítók saját jelentéseiből vagy nyilvános ranglistákról származnak, és lehet, hogy azok is a saját legmagasabb vagy elérhető gondolkodási fokozatukat használják. Egyes projekteket a Google maga futtatott, mások harmadik féltől származnak, és az eszközkörnyezet meg a mintavételi módszerek nem mindenhol azonosak. Például a DeepSWE és a Terminal-bench Argon-eredményeit a Google mérte, míg a többi modell nyilvános eredményeket használ; az LVBenchnél a különböző modelleknél eltérő számú videókockát vettek ki. A GraphWalks sor BFS F1-et használ, az OSWorld sor pedig csak az offline részhalmaz „részeredményét” jelenti. Nem szabad sorokon átlagolni, és ebből nem lehet azt állítani, hogy egységes tesztkörülmények között ez az összesített első. A módszertani PDF eredményoldala külön azt írja: „2026. októberig”, ami nem egyezik azzal, hogy e cikk szeptember 30-án olvasta be a táblázatot; a konkrét értékelés befejezési napja nem volt megerősíthető. Ez a cikk csak az akkor a hivatalos oldalon látható eredményeket másolja, nem következtet arra, mikor fejeződött be az értékelés, és nem állítja, hogy ezek a mi reprodukált eredményeink.
Hogyan hasonlítsuk össze az árakat: a havi díjat és az API-költséget külön kell kezelni
Ha csak csevegőtermékben vagy programozási eszközben szeretné használni, először az előfizetést és a használati keretet nézze. Az amerikai nyilvános árak szerint a ChatGPT Plus $20/hó, a Pro pedig $100, $200, $500/hó és hasonló szintekre oszlik; a konkrét Astra-felhasználás a csomagtól és a feladattól függ. Az OpenAI ChatGPT Work/Codex ár- és használati leírása kifejezetten figyelmeztet: az API egymillió tokenre vonatkozó ajánlati árából nem lehet kiszámítani, mennyi feladat végezhető el az előfizetés keretein belül.
A Claude Pro amerikai havidíja $20, a Max $100/hó-tól indul (Claude hivatalos ártáblázata). De az, hogy „a Pro csomagban választható a Fable 5.1”, nem jelenti, hogy a Fable beletartozik a Pro szokásos keretébe: az Anthropic Fable-csomagszabályai szerint a Pro és a Team standard helyek Fable 5.1 használatához külön usage credits szükséges; a Max és a prémium helyek a heti keret egy részéig használhatják. A Google még nem adta meg az Argon hétköznapi felhasználói előfizetési árát vagy megnyitási dátumát, ezért a Google AI Ultra jelenlegi havidíja nem tekinthető „az Argon ma megvásárolható” árának.
Ha API-n keresztül, használat alapján fizet, az alábbi az egységesen olvasható szabványos szöveges árlista. A bemenet az, amit a modellnek elolvasásra átad, a kimenet pedig az általa generált válasz. Az egység minden esetben az 1 millió tokenenkénti dolláros ár (a token a szöveg stb. elszámoláskor történő felbontásának egysége); a táblázatban az Argon a Google által bejelentett jövőbeli bevezetési ár, nem a mai, már kifizetett tényleges számla.
| Modell | Normál bemenet | Normál kimenet | Ismétlődő tartalom gyorsítótár-olvasása | Állapot |
|---|---|---|---|---|
| Gemini 4 Argon | Az első bevezetés tervezett ára $2; a kedvezményes időszak után $4 | Az első bevezetés tervezett ára $10; a kedvezményes időszak után $20 | A Google szerint az első bevezetéskor a gyorsítótárazott bemenet a normál bemeneti ár 95%-os kedvezményével érhető el; a konkrét bevezetési szabályok ellenőrzésre várnak | Még nem széles körben elérhető |
| GPT-6 Astra | $10 | $50 | $1 | Jelenlegi API-szabványár |
| Claude Fable 5.1 | $10 | $50 | $0.25 | Jelenlegi API-szabványár |
Az adatok a Google Argon bejelentéséből, az OpenAI Astra modellár-oldaláról és az Anthropic Fable 5.1 modelloldaláról származnak. Az árak nem tartalmazzák a további eszközöket, régiókat, sebességi szinteket vagy platformkülönbségeket; az Astra esetében, ha egyetlen bemenet meghaladja a 272K tokent, a teljes kérés bemenetére és gyorsítótárára 2-szeres, a kimenetre 1,5-szeres árazás vonatkozik. A gyorsítótár ára csak a ténylegesen gyorsítótárból kiszolgált tartalomra érvényes, nem lehet a teljes feladatot gyorsítótár-árral becsülni. Még ha az Argon tervezett egységára alacsonyabb is a másik kettőnél, azonos feladat sikerességi és felhasználási adatai nélkül nem lehet azt állítani, hogy egy feladat elvégzése vele a legolcsóbb.
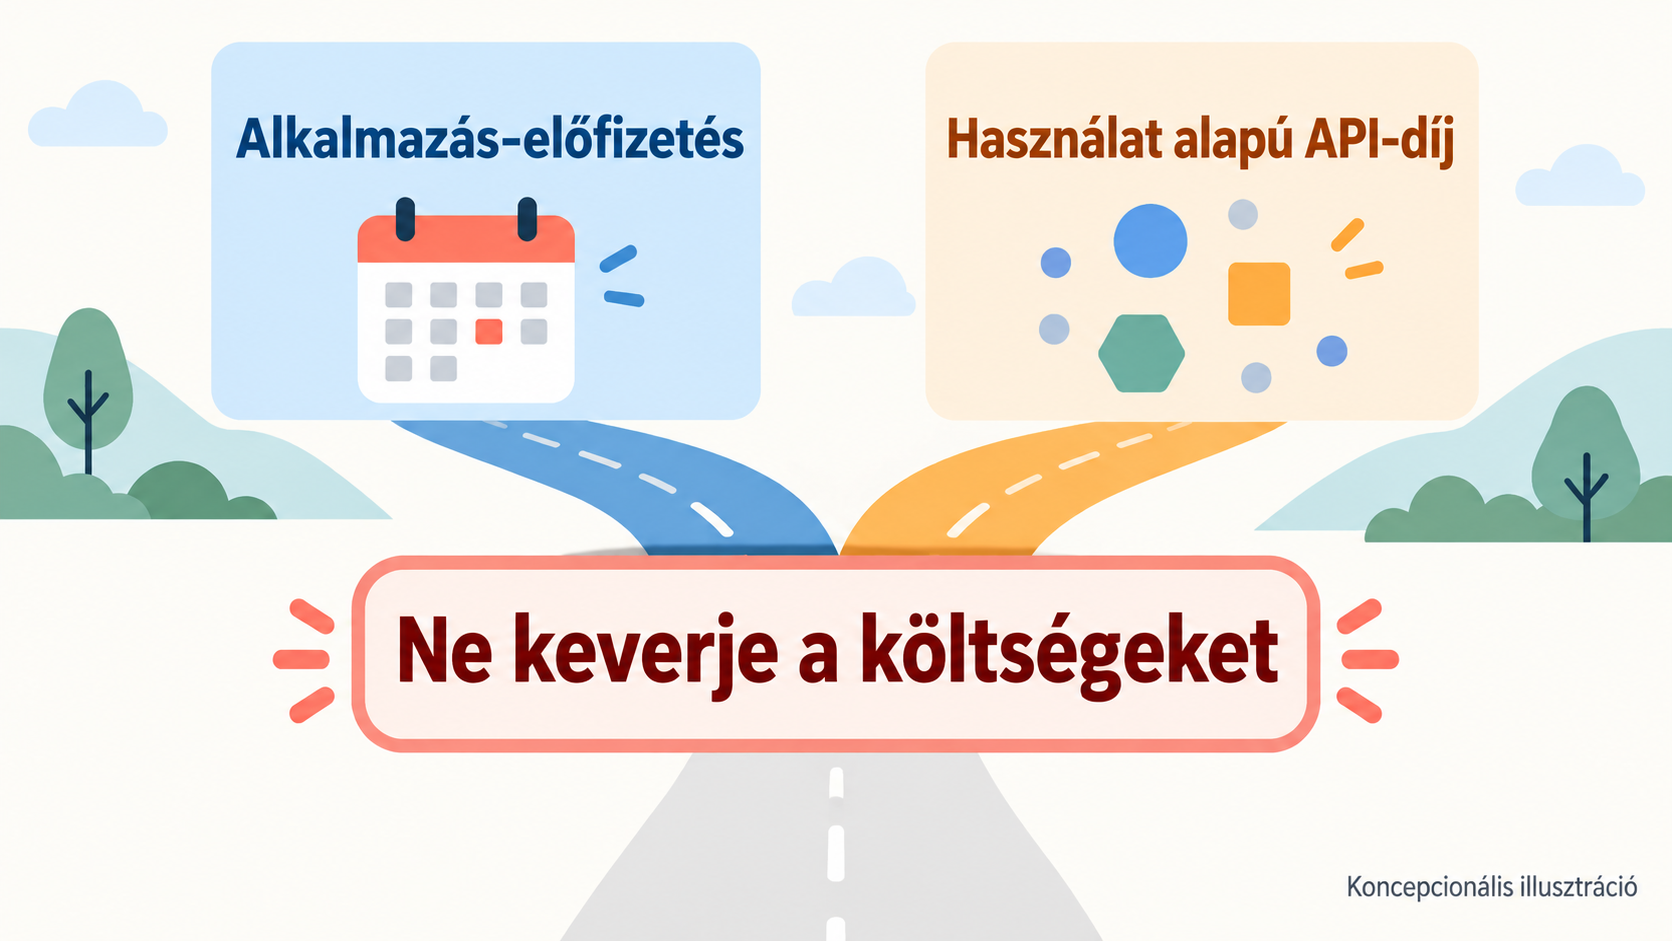
Ábra: AI által generált számlázási mérce szemléltetése, nem termékszámla; a havi előfizetési díj nem keverhető össze az API egységárával. Eredeti méretű kép megtekintése (1672×941).

Hogyan válasszunk feladat szerint? Először a kéznél lévő, elérhető modellt használja
Ha a feladat több szoftveren ível át, vagy webes böngészést, felületi műveleteket és összetett döntéseket igényel: először próbálja ki a GPT-6 Astrát. Az OpenAI a számítógép-kezelést, a böngészést, a nehéz programozást és a szakmai dokumentumokat sorolja a fő képességei közé. Ha már van megfelelő fizetős ChatGPT-fiókja vagy API-hozzáférése, ma odaadhat neki egy valós feladatot, és megnézheti, hogy az eredmény megfelel-e az elvárásoknak. Az OpenAI modellleírása.
Ha a feladat több órán át tartó programozás, kódellenőrzés vagy nagyméretű dokumentummunka: először a Claude Fable 5.1-et próbálja ki. Az Anthropic hosszú távú autonóm feladatokra, összetett programozásra és kutatásra pozicionálja. Akiknek már van Claude Code munkafolyamatuk, először használhatják a megszokott eszközöket, de előbb ellenőrizzék, hogy a csomag nem von-e le külön használati krediteket; ha naponta sok ilyen feladatot futtat, hasonlítsa össze a Max és az API valós költségét. Az Anthropic modellleírása.
Ha a Gemini 4 Argon-t szeretné kipróbálni: először győződjön meg róla, hogy megkapta-e a hivatalos hozzáférést. A Google által bejelentett irányok közé tartozik az összetett programozás, a vállalati tudásmunka és a védelmi biztonsági feladatok, valamint megadták a tervezett árat; ezek figyelmet érdemelnek, de még nem helyettesítik a hétköznapi felhasználói tapasztalatot. Hozzáférés nélkül nem javasolt az Argon „várhatóan olcsóbb” ígérete miatt megváltoztatni a jelenleg futó munkafolyamatot. A Google hivatalos bejelentése.
Ezek a javaslatok nem azt jelentik, hogy „ha egy modell egyfajta feladatban jó, csak azt tudja csinálni”. Ha a három modell a jövőben mind elérhető lesz, a legbiztonságosabb választási módszer: vegyen ugyanazt a valós feladatot, ugyanazokat az anyagokat és elfogadási kritériumokat adva, és jegyezze fel külön-külön, hogy teljesítette-e, mennyi volt a kézi újramunka, az időigény és a teljes költség. Egy szép bemutató vagy a különböző gyártók saját benchmarkja nem bizonyítja közvetlenül, hogy az Ön feladata is ugyanilyen eredményt hoz.
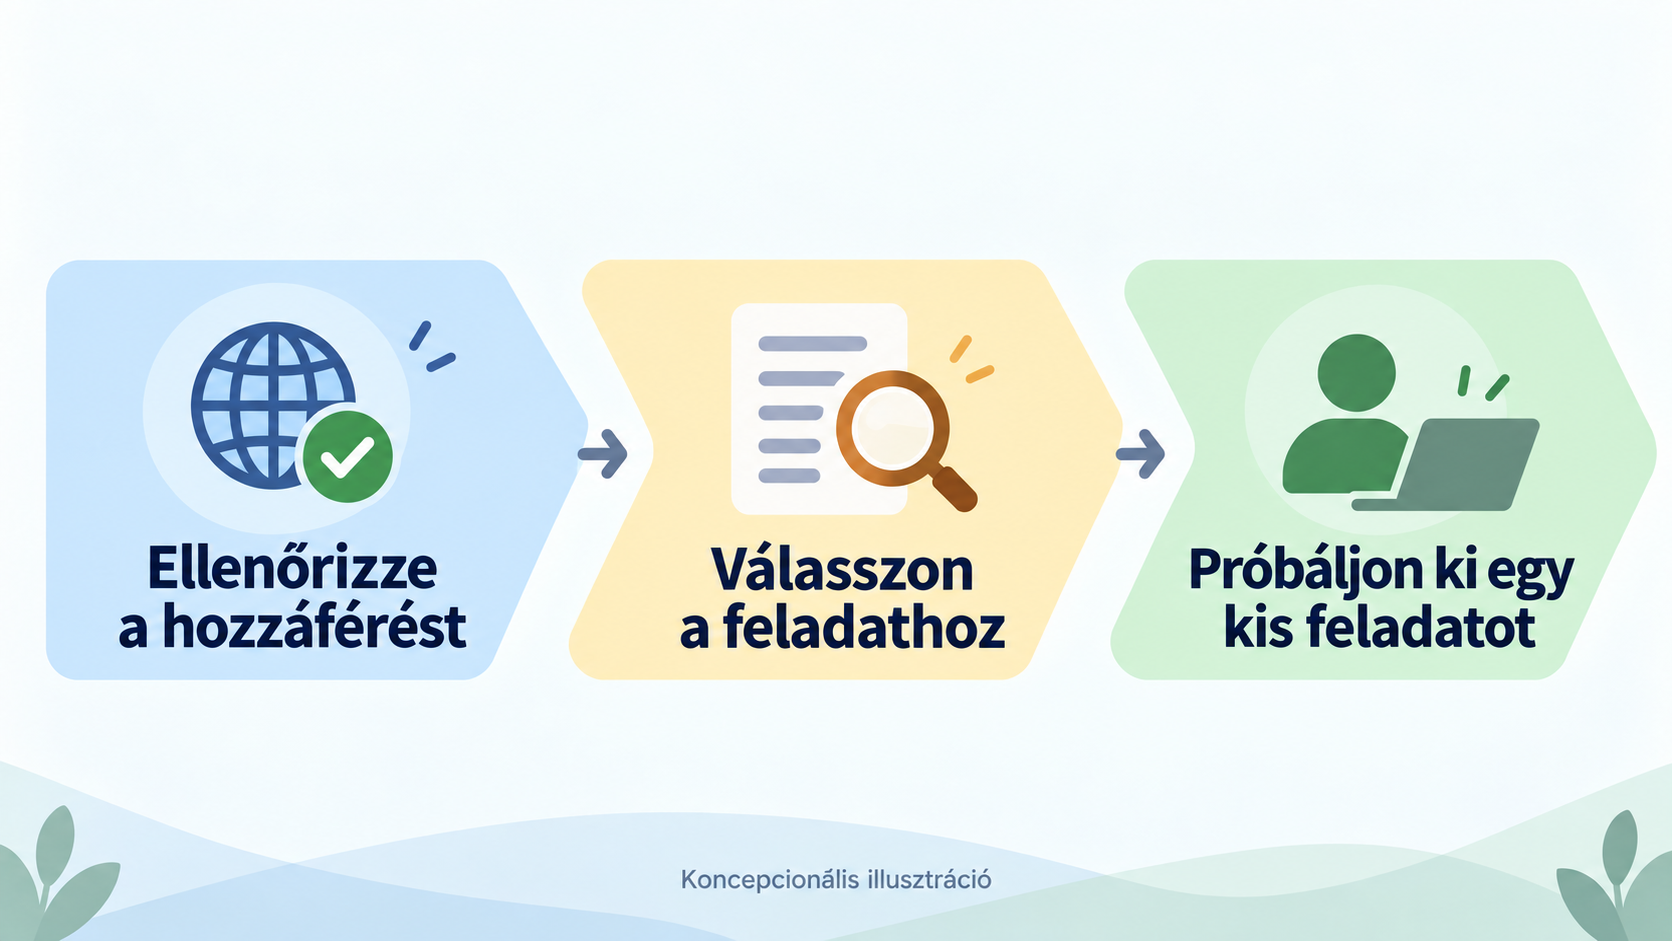
Ábra: AI által generált választási útvonal szemléltetése: először nézze a fiók és a régió elérhetőségét, aztán a feladat igényeit, végül saját kis feladattal ellenőrizze. A képen látható „ez a cikk nem végez semmilyen összehasonlító tesztet” azt jelenti, hogy nem futtattunk magunk azonos körülmények között végzett teszteket; a fenti benchmark-táblázat a Google által közzétett adatok átirata. Eredeti méretű kép megtekintése (1672×941).

Ha a feladata az, hogy két programozási asszisztenst osszon fel munkára, nézze meg a Claude Code és Codex együttműködési útmutatóját; ha konkrét kérdést szeretne átadni egy bejelentkezett ChatGPT Pro oldalnak, nézze meg a Codex és Claude Code útmutatóját, hogyan kérjen segítséget a ChatGPT Pro-tól. Ez a két cikk munkafolyamat-műveleteket mutat be, és nem jelenti azt, hogy a Gemini 4 Argon már integrálva van a PandaNpc-be.
FAQ
A Gemini 4 Argon már hivatalosan megjelent, miért nem találom?
A „megjelenés” azt jelenti, hogy a Google bejelentette a modellt, és korlátozott körben elérhetővé tette; a hivatalos bejelentés még nem adott egységes megnyitási dátumot minden fejlesztő és hétköznapi fogyasztó számára. Először nézze meg az általa használt Gemini-termék és -fiók hivatalos modelllistáját, és ne tekintse a pletykákban szereplő „Gemini 4 Pro”-t az Argon elérhető belépési pontjának.
Az Astra a Google Project Astra?
Nem. A cikkben szereplő GPT-6 Astra OpenAI modellje; a Google Project Astra egy másik kutatási projekt, nem keverhető a hárommodelles ártáblázatba.
Ha előfizettem a Claude Pro-ra, a csomag keretén belül használhatom a Fable 5.1-et?
Nem feltétlenül. Az Anthropic hatályos csomagleírása szerint a Pro csomagban a Fable 5.1 használatához usage credits kell, míg a Max és néhány más csomag a meghatározott heti keret részeként használhatja. Fizetés előtt nézze meg a saját „használat/kreditek” oldalát.
A fenti árak alapján egyenesen meg lehet állapítani, melyik a legkedvezőbb?
Nem. Az API-táblázat csak a listaárat hasonlítja össze; egy feladat elvégzését a bemenet hossza, az ismétlődő tartalom gyorsítótár-találata, az eszközköltségek, a futási fordulók száma és az újramunka is befolyásolja. Főleg, hogy az Argon még nem széles körben elérhető, nem adhatjuk meg a saját „sikeres feladatonkénti költségünket”.
Kapcsolódó útmutatók

GPT-6 Sol vs Claude Opus 5.5: ár, benchmarkpontszámok és programozási feladatok – melyiket válasszuk?
Általános API-programozási feladatokhoz először a GPT-6 Sol-t érdemes kipróbálni; összetett feladatoknál érdemes összevetni a Claude Opus 5.5-tel, majd a GPT-6 Astra és a Claude Fable 5.1 jöhet szóba nagy nehézségű opcióként. Ez a cikk ellenőrzi a négy modell hivatalos specifikációit, a cache- és Batch-árakat, az azonos módszertanú, harmadik féltől származó benchmarkokat, valamint öt újraszámolható költségforgatókönyvet mutat be.
Cikk elolvasása →
Claude Code vs Codex: funkciók, távoli vezérlés, jogosultságok és használati esetek – hogyan válassz (2026)
Röviden: Claude Code a mély terminálmunkához, Hooks funkciókhoz és a Claude ökoszisztémához; Codex a ChatGPT-hez, felhőfeladatokhoz és több Agent használatához; PandaNpc mindkettő távoli vezérléséhez Windows, macOS, Linux és mobil eszközökön.
Cikk elolvasása →
A ChatGPT Pro használata Codexszel és Claude Code-dal a PandaNpc-ben
A PandaNpc Codex vagy Claude Code beszélgetéseiben egy konkrét kérdést átadhat a bejelentkezett ChatGPT Pro weboldalnak, és a válasz vissakerül az eredeti beszélgetésbe.
Cikk elolvasása →