
เลือก Gemini 4 Argon, GPT-6 Astra หรือ Claude Fable 5.1 อย่างไร? เปรียบเทียบความพร้อมใช้งาน ราคา และกรณีการใช้งานที่เหมาะสม
Gemini 4 Argon เปิดเฉพาะบางกลุ่ม ส่วน GPT-6 Astra และ Claude Fable 5.1 ที่ใช้ได้แล้วควรเลือกตามงานและแผน โดยแยกราคา API กับค่าสมัครสมาชิก และอ้างอิงข้อมูลทางการ ไม่ใช่การทดสอบเงื่อนไขเดียวกัน
ตรวจสอบข้อมูล ณ วันที่ 30 กันยายน 2026 (UTC) PandaNpc ให้บริการ AI Agent ซึ่งเกี่ยวข้องกับการเลือกโมเดล บทความนี้รวบรวมข้อมูลสาธารณะจากสามบริษัท และให้คำแนะนำในการเลือกตามงาน เรายังไม่ได้รับสิทธิ์ทดลองใช้ Gemini 4 Argon และไม่ได้ทดสอบสามโมเดลภายใต้เงื่อนไขเดียวกัน คำว่า “เหมาะ” ด้านล่างหมายถึงจุดยืนทางการและความพร้อมใช้งานปัจจุบัน ไม่ได้หมายความว่าเราทดสอบแล้วว่าใครเก่งกว่า
สรุปก่อน: หากต้องใช้วันนี้ ให้เลือกจาก GPT-6 Astra และ Claude Fable 5.1 ตามงานและแพ็กเกจที่มีอยู่ก่อน; ปัจจุบัน Gemini 4 Argon เปิดให้ผู้ทดสอบที่เชื่อถือได้จำนวนน้อยเท่านั้น ผู้ใช้ทั่วไปยังไม่สามารถถือเป็นตัวเลือกที่สามที่พร้อมใช้ได้ทุกเมื่อ งานที่ต้องข้ามซอฟต์แวร์ จัดระเบียบข้อมูลซับซ้อน หรือเขียนโปรแกรมยาก ๆ ลอง Astra ก่อน; งานเขียนโปรแกรมระยะยาว อ่านโปรเจกต์ขนาดใหญ่หรือเอกสารซับซ้อนซ้ำ ๆ ลอง Fable 5.1 ก่อน เมื่อ Argon เปิดกว้างทั่วไปแล้ว ค่อยใช้โจทย์เดียวกันเปรียบเทียบคุณภาพงานจริงและค่าใช้จ่ายรวม
ดูภาพปกขนาดต้นฉบับ PNG (1672×941)
เริ่มจากดูว่าใช้ได้หรือไม่: สามโมเดลไม่ได้ออกสตาร์ตจากจุดเดียวกัน
| โมเดล | วันที่เปิดตัวทางการ | ณ วันที่ 30 กันยายน ใครใช้ได้ | สิ่งที่หมายถึงสำหรับผู้อ่านทั่วไป |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | เปิดให้ผู้ป้องกันไซเบอร์และผู้ทดสอบที่เชื่อถือได้ของโครงการ Google Fairwind ก่อน; การเปิดกว้างสำหรับนักพัฒนา องค์กร และผู้บริโภคยังรอขั้นตอนถัดไป | การเห็น “เปิดตัวแล้ว” วันนี้ ไม่ได้แปลว่าบัญชี Gemini หรือ API ของคุณเลือก Argon ได้แล้ว |
| GPT-6 Astra | 2026-09-03 | เปิดตัวเป็นระยะให้ผู้ใช้ ChatGPT แบบชำระเงินและผู้ใช้ API แล้ว ปริมาณการใช้งานที่ใช้ได้จริงขึ้นอยู่กับแพ็กเกจและบัญชี | คุณสามารถตรวจสอบรายการโมเดลและโควตาการใช้งานของตนเอง แล้วเริ่มงานจริงได้ทันที |
| Claude Fable 5.1 | 2026-09-01 | ใช้ได้กับแพ็กเกจแบบชำระเงินของ Claude และ Claude API แต่แพ็กเกจอย่าง Pro อาจต้องใช้เครดิตการใช้งานเพิ่มเติม | ตรวจกฎการใช้ Fable ของแพ็กเกจก่อน แล้วค่อยตัดสินใจว่าจะอัปเกรดหรือจ่ายเพิ่ม |
ประกาศ Gemini 4 Argon ของ Google ระบุว่าปัจจุบันเปิดในวงจำกัด และมีแผนขยายในอนาคตโดยเริ่มจากผู้ใช้ API แบบชำระเงินและสมาชิก Google AI Ultra; ยังไม่ประกาศวันแน่นอนที่ผู้ใช้ทั่วไปจะใช้ได้ ประกาศ Astra ของ OpenAI และคำอธิบาย Fable 5.1 ของ Anthropic ระบุขอบเขตการเปิดใช้งานที่มีอยู่ตามลำดับ Astra ที่นี่คือโมเดลของ OpenAI ไม่ใช่ โครงการวิจัย Project Astra ของ Google
เปรียบเทียบพารามิเตอร์: อย่าเอา “อ่านได้แค่ไหน” กับ “เขียนได้แค่ไหน” มาปนกัน
หน้าต่างบริบทอินพุต คือปริมาณข้อมูลที่มอบให้โมเดลได้ในครั้งเดียว; เอาต์พุตสูงสุด คือเนื้อหาสูงสุดที่มันสร้างได้ในครั้งเดียว ตัวเลขสองตัวนี้ใช้แทนกันไม่ได้ และใช้ตัวเลขเพียงอย่างเดียวตัดสินคุณภาพคำตอบไม่ได้ ข้อมูลด้านล่างเป็นข้อมูลของรุ่นเฉพาะที่ตรวจสอบ ณ วันที่ 30 กันยายน 2026 ไม่ใช่สเปกทั่วไปของตระกูล Gemini, GPT หรือ Claude ทั้งหมด
| พารามิเตอร์ | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| หน้าต่างบริบทอินพุต | ยังไม่ประกาศขีดจำกัดสูงสุดอย่างเป็นทางการ | 1,050,000 token | 1,000,000 token |
| เอาต์พุตสูงสุดต่อครั้ง | ประกาศของ Google ระบุ 1,000,000 token; ผู้ใช้ทั่วไปยังตรวจสอบไม่ได้ | 128,000 token | 128,000 token |
| อินพุตที่มอบให้โมเดลได้ | ประกาศแสดงความเข้าใจมัลติโมดัลและวิดีโอยาว แต่ยังไม่ประกาศรายการประเภทอินพุต API ที่สมบูรณ์ | ข้อความ, รูปภาพ | ข้อความ, รูปภาพ |
| ช่องทางทางการปัจจุบัน | ผู้ทดสอบที่เชื่อถือได้ของ Fairwind; ยังไม่ประกาศเวลาที่เปิดกว้าง | บัญชี ChatGPT แบบชำระเงินตามความคืบหน้าการเปิดตัวและแพ็กเกจ, OpenAI API | ผลิตภัณฑ์แบบชำระเงินของ Claude และ Claude API; แพ็กเกจอย่าง Pro มีเงื่อนไขเครดิตเพิ่มเติม |
ที่มา: ประกาศ Gemini 4 Argon ของ Google, หน้ารุ่น GPT-6 Astra ของ OpenAI, หน้ารุ่น Claude Fable 5.1 ของ Anthropic และคำอธิบายแพ็กเกจของ Anthropic “1 ล้าน” ในประกาศของ Google หมายถึงขีดจำกัดเอาต์พุต ไม่สามารถถือว่า Argon ประกาศ “หน้าต่างบริบทอินพุต 1 ล้าน” แล้ว การ์ดข้อมูลรุ่นสาธารณะแบบเต็มของ Argon และการทดสอบจริงโดยผู้ใช้ทั่วไปยังรอการเปิดตัว; คำว่า “ยังไม่ประกาศ” ในตารางไม่ได้แปลว่า “ไม่มีความสามารถนี้”
ตารางด้านบนเปรียบเทียบสเปกสาธารณะ ไม่ใช่การแพ้ชนะด้านประสิทธิภาพ: ยิ่งรองรับเนื้อหาได้มาก ไม่ได้แปลว่าจะตอบแม่นขึ้นเสมอไป ตารางด้านล่างต่างหากคือผลคะแนนมาตรฐานประสิทธิภาพ
เปรียบเทียบคะแนนทางการ: ดูงานเฉพาะ อย่าหา “แชมป์รวม”
Google DeepMind เผยแพร่ตารางคะแนนสี่โมเดลบน หน้ารุ่นทางการของ Gemini 4 Argon ที่นี่คัดมาเฉพาะสามคอลัมน์ที่บทความนี้พูดถึง ได้แก่ Argon, GPT-6 Astra และ Claude Fable 5.1; ตารางต้นฉบับยังมี Claude Opus 5.5 ผลคะแนนด้านล่างมาจาก หน้าเว็บ Google ทางการที่อ่านจริงเมื่อวันที่ 30 กันยายน 2026 เวลา 23:42 UTC รวบรวมโดย Google ไม่ใช่การทดสอบภายใต้เงื่อนไขเดียวกันโดย PandaNpc ยกเว้นแถวที่ระบุ F1 อัตราผ่าน หรือคะแนนบางส่วน ตัวเลขใช้เปอร์เซ็นต์ตามตารางต้นฉบับ; ในแต่ละแถวจะทำให้ค่าที่สูงกว่าในสามโมเดลนี้เป็นตัวหนา “—” หมายถึงตารางต้นฉบับไม่มีผลคะแนนที่เทียบกันได้ ไม่ใช่ 0 คะแนน
| กลุ่มความสามารถ | Benchmark (รายการทดสอบ) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| งานความรู้ | Vals Index | 68.9% | 63.1% | 65.8% |
| งานความรู้ | AutomationBench | 51.3% | 41.4% | 31.4% |
| งานความรู้ | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| งานความรู้ | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| เขียนโปรแกรมอัตโนมัติ | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| เขียนโปรแกรมอัตโนมัติ | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| เขียนโปรแกรมอัตโนมัติ | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| เขียนโปรแกรมอัตโนมัติ | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| วิศวกรรมแมชชีนเลิร์นนิง | PostTrainBench | 45.3% | 44.3% | 40.2% |
| วิทยาศาสตร์และคณิตศาสตร์ | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| วิทยาศาสตร์และคณิตศาสตร์ | LABBench 2 | 88.8% | 85.4% | 68.6% |
| วิทยาศาสตร์และคณิตศาสตร์ | RiemannBench | 76.0% | 72.0% | 65.6% |
| ข้อความยาว | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 91.4% |
| ข้อความยาว | GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 65.0% |
| การใช้งานคอมพิวเตอร์ | Agent's Last Exam (อัตราผ่าน) | 39.5% | 34.2% | — |
| การใช้งานคอมพิวเตอร์ | OSWorld-2.0 (ชุดย่อยออฟไลน์, คะแนนบางส่วน) | 69.2% | 72.6% | — |
| ความเข้าใจภาพและข้อความ | Chartography | 71.6% | 71.0% | 46.2% |
| ความเข้าใจวิดีโอ | LVBench | 91.7% | 87.5% | 79.7% |
| ความปลอดภัยเชิงป้องกัน | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
ใช้ตารางนี้อย่างไร? หากคุณทำงานความรู้ ให้ดู Vals Index, Finance Agent ก่อน; ถ้าเขียนโค้ด ให้ดู DeepSWE, FrontierSWE และ Terminal-bench ควบกัน อย่าเลือกดูแถวเดียว: Argon นำใน DeepSWE แต่ Astra สูงกว่าใน FrontierSWE และ Terminal-bench งานใช้งานคอมพิวเตอร์ต้องสังเกตเป็นพิเศษ สองแถวของ Fable ในตาราง Google นี้เป็นข้อมูลที่ขาดหาย จึงบอกไม่ได้ว่ามันใช้งานคอมพิวเตอร์ไม่เป็น CWE-bench แสดงว่า Argon กับ Astra เสมอกัน ในสามตัว; นี่ก็ไม่ใช่การรับประกันงานความปลอดภัยจริง
เกณฑ์การทดสอบ: คำอธิบายวิธีการประเมิน ของ Google ระบุว่าคะแนนของ Argon โดยทั่วไปมาจากการลองครั้งเดียวและระดับการคิดสูงสุด; ข้อมูลของโมเดลอื่นส่วนใหญ่มาจากที่ผู้ให้บริการแต่ละรายรายงานเองหรือกระดานอันดับสาธารณะ และอาจใช้ระดับการคิดสูงสุดหรือระดับที่มีของแต่ละรุ่น บางโปรเจกต์ Google รันเอง บางโปรเจกต์มาจากบุคคลที่สาม สภาพแวดล้อมเครื่องมือและวิธีการสุ่มตัวอย่างไม่ได้เหมือนกันทุกจุด ตัวอย่างเช่น คะแนน Argon ใน DeepSWE และ Terminal-bench เป็นการทดสอบเองของ Google ส่วนโมเดลอื่นใช้คะแนนสาธารณะ; LVBench ดึงจำนวนเฟรมวิดีโอต่างกันสำหรับต่างโมเดล แถว GraphWalks ใช้ BFS F1 แถว OSWorld เป็นเพียง “คะแนนบางส่วน” ของชุดย่อยออฟไลน์ ห้ามนำข้ามแถวมาเฉลี่ย ห้ามอ้างว่าที่นี่คือที่หนึ่งรวมภายใต้เงื่อนไขทดสอบเดียวกัน หน้าผลลัพธ์ของ PDF วิธีการนี้เขียนอีกว่า “ณ ตุลาคม 2026” ซึ่งไม่ตรงกับเวลาที่บทความนี้อ่านตารางเมื่อ 30 กันยายน; ยังยืนยันวันเสร็จสิ้นการประเมินที่แน่ชัดไม่ได้ บทความนี้เพียงถอดความคะแนนที่มองเห็นบนเว็บทางการในตอนนั้น ไม่ได้อนุมานว่าการประเมินเสร็จเมื่อไร และไม่ได้บอกว่าเป็นผลที่เราทำซ้ำได้
เปรียบเทียบราคาอย่างไร: ค่าบริการรายเดือนกับค่าใช้จ่าย API ต้องแยกกัน
หากต้องการใช้เพียงในผลิตภัณฑ์แชตหรือเครื่องมือเขียนโปรแกรม ให้ดูการสมัครสมาชิกและโควตาการใช้งานก่อน ในราคาสาธารณะของสหรัฐฯ ChatGPT Plus อยู่ที่ $20/เดือน ส่วน Pro แบ่งเป็นระดับ $100, $200, $500/เดือน เป็นต้น; ปริมาณการใช้ Astra จริงแปรตามแพ็กเกจและงาน คำอธิบายราคาและการใช้งาน ChatGPT Work/Codex ของ OpenAI เตือนชัดเจนว่า: ราคา API ต่อล้าน token ไม่สามารถนำมาคำนวณว่าภายในสมาชิกทำภารกิจได้กี่งาน
Claude Pro ราคารายเดือนในสหรัฐฯ อยู่ที่ $20, Max เริ่มที่ $100/เดือน (ตารางราคาทางการของ Claude) แต่ “Pro เลือก Fable 5.1 ได้” ไม่ได้หมายความว่า Fable รวมอยู่ในโควตาปกติของ Pro แล้ว: กฎแพ็กเกจ Fable ของ Anthropic ระบุว่า Pro และที่นั่งมาตรฐานของ Team ต้องใช้ usage credits เพิ่มเติมเมื่อใช้ Fable 5.1; Max และที่นั่งระดับสูงสามารถใช้ได้ภายในส่วนหนึ่งของโควตารายสัปดาห์ Google ยังไม่ให้ราคาสมัครสมาชิกจริงหรือวันเปิดให้ผู้ใช้ทั่วไปใช้ Argon จึงนำค่าบริการรายเดือนปัจจุบันของ Google AI Ultra มาเป็นข้อเสนอ “ซื้อ Argon วันนี้” ไม่ได้
หากจ่ายตามการใช้งานผ่าน API ด้านล่างนี้คือราคามาตรฐานสำหรับข้อความที่อ่านเทียบหน่วยเดียวกันได้ อินพุตหมายถึงเนื้อหาที่คุณมอบให้โมเดลอ่าน เอาต์พุตหมายถึงคำตอบที่มันสร้าง หน่วยเป็น ราคาดอลลาร์สหรัฐต่อ 1 ล้าน token (token คือหน่วยที่ใช้แบ่งข้อความ等内容ในการคิดค่าใช้จ่าย); Argon ในตารางเป็นราคาที่จะเปิดตัวในอนาคตที่ Google ประกาศ ไม่ใช่บิลจริงที่เราจ่ายวันนี้
| โมเดล | อินพุตปกติ | เอาต์พุตปกติ | การอ่านแคชของเนื้อหาซ้ำ | สถานะ |
|---|---|---|---|---|
| Gemini 4 Argon | เปิดตัวครั้งแรกกำหนดไว้ $2; หลังช่วงโปรโมชัน $4 | เปิดตัวครั้งแรกกำหนดไว้ $10; หลังช่วงโปรโมชัน $20 | Google กล่าวว่าอินพุตแคชช่วงเปิดตัวได้ส่วนลด 95% จากราคาอินพุตปกติ; กฎการเปิดตัวจริงรอตรวจสอบ | ยังไม่เปิดกว้าง |
| GPT-6 Astra | $10 | $50 | $1 | ราคา API มาตรฐานปัจจุบัน |
| Claude Fable 5.1 | $10 | $50 | $0.25 | ราคา API มาตรฐานปัจจุบัน |
ข้อมูลจากประกาศเปิดตัว Argon ของ Google, หน้าราคาโมเดล Astra ของ OpenAI และหน้ารุ่น Fable 5.1 ของ Anthropic ราคาไม่รวมเครื่องมือเพิ่มเติม ภูมิภาค ระดับความเร็ว หรือความต่างของแพลตฟอร์ม; Astra เมื่ออินพุตครั้งเดียวเกิน 272K token จะคิดราคาอินพุตและแคชของทั้งคำขอเป็น 2 เท่า และเอาต์พุตเป็น 1.5 เท่า ราคาแคชใช้ได้เฉพาะเนื้อหาที่เข้าแคชจริงเท่านั้น ไม่สามารถประเมินทั้งงานด้วยราคาแคชได้ แม้ราคาต่อหน่วยที่กำหนดไว้ของ Argon จะต่ำกว่าอีกสองรุ่น แต่เมื่อไม่มีข้อมูลอัตราความสำเร็จและปริมาณการใช้ในงานเดียวกัน ก็ยืนยันไม่ได้ว่ามันทำงานหนึ่งงานถูกที่สุด
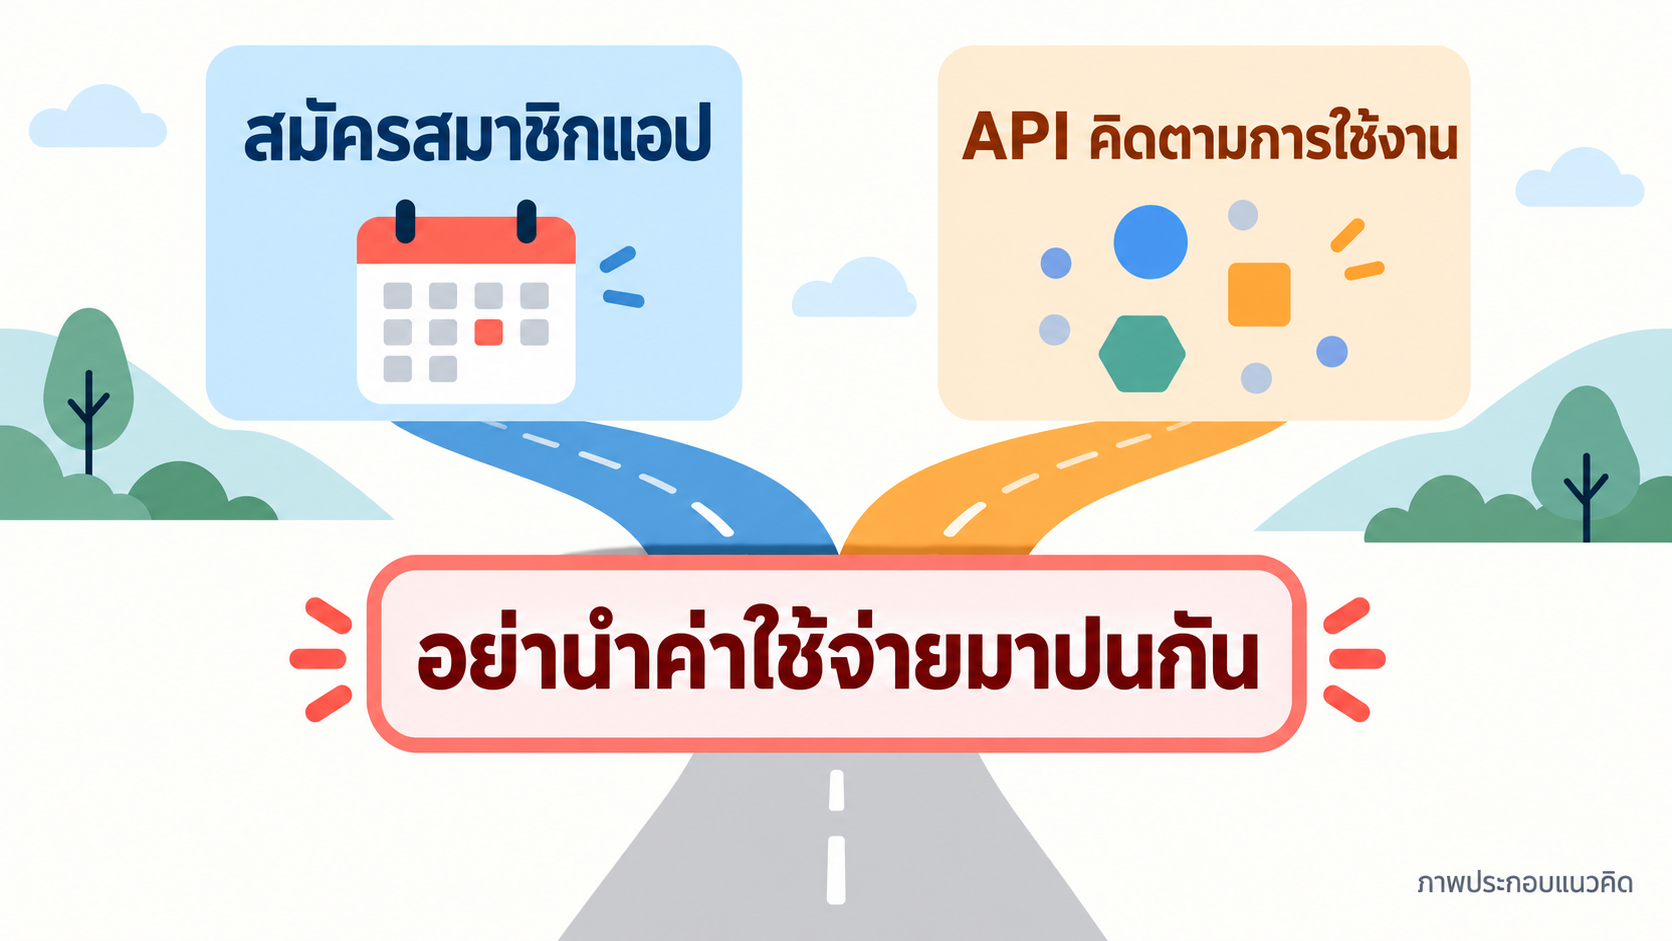
ภาพ: ภาพแนวคิดเกณฑ์การคิดค่าบริการที่สร้างโดย AI ไม่ใช่บิลผลิตภัณฑ์; ค่ารายเดือนแบบสมัครสมาชิกนำมาคำนวณรวมกับราคาต่อหน่วย API ไม่ได้ ดูภาพขนาดต้นฉบับ (1672×941)

เลือกตามงานอย่างไร? ใช้โมเดลที่มือมีก่อน
งานที่ต้องข้ามหลายซอฟต์แวร์ หรือต้องท่องเว็บ ใช้งานอินเทอร์เฟซ และตัดสินใจซับซ้อน: ลอง GPT-6 Astra ก่อน OpenAI ระบุการใช้งานคอมพิวเตอร์ การท่องเว็บ การเขียนโปรแกรมยาก และเอกสารวิชาชีพเป็นความสามารถจุดเน้นของมัน หากคุณมีบัญชี ChatGPT แบบชำระเงินหรือสิทธิ์ API ที่เหมาะสมอยู่แล้ว วันนี้ก็มอบงานจริงให้มันได้ และดูว่าผลลัพธ์ได้ตามต้องการหรือไม่ คำอธิบายโมเดลของ OpenAI
งานเขียนโปรแกรม ตรวจโค้ด หรือเอกสารขนาดใหญ่ที่ใช้เวลาหลายชั่วโมง: ลอง Claude Fable 5.1 ก่อน Anthropic วางตำแหน่งมันสำหรับงานอัตโนมัติระยะยาว การเขียนโปรแกรมซับซ้อน และการวิจัย ผู้ที่มีเวิร์กโฟลว์ Claude Code อยู่แล้วสามารถใช้เครื่องมือที่คุ้นเคยต่อไปก่อน แต่ต้องยืนยันว่าแพ็กเกจหักเครดิตการใช้งานเพิ่มหรือไม่; หากต้องรันงานประเภทนี้มาก ๆ ทุกวัน ค่อยเปรียบเทียบต้นทุนจริงของ Max กับ API คำอธิบายโมเดลของ Anthropic
หากอยากลอง Gemini 4 Argon: ยืนยันก่อนว่าตนได้รับสิทธิ์เข้าถึงทางการหรือไม่ ทิศทางที่ Google ประกาศรวมถึงการเขียนโปรแกรมซับซ้อน งานความรู้ระดับองค์กร และงานความปลอดภัยเชิงป้องกัน พร้อมราคาที่กำหนดไว้; สิ่งเหล่านี้น่าจับตา แต่ยังแทนประสบการณ์ทดสอบจริงของผู้ใช้ทั่วไปไม่ได้ เมื่อยังไม่มีสิทธิ์ ไม่แนะนำให้เปลี่ยนเวิร์กโฟลว์ที่กำลังใช้อยู่เพียงเพราะ “คาดว่าจะถูกกว่า” ของ Argon ประกาศทางการของ Google
คำแนะนำเหล่านี้ไม่ได้หมายความว่า “โมเดลถนัดงานประเภทหนึ่งแล้วทำได้แค่ประเภทนั้น” หากในอนาคตทั้งสามรุ่นใช้ได้ วิธีเลือกที่มั่นคงที่สุดคือ: เอางานจริงชิ้นเดียวกัน ให้ข้อมูลและเกณฑ์ตรวจรับเดียวกัน แล้วบันทึกแยกกันว่าทำสำเร็จหรือไม่ ต้องแก้ซ้ำด้วยคนแค่ไหน ใช้เวลาเท่าไร และค่าใช้จ่ายรวมเท่าไร เดโมสวย ๆ ครั้งเดียวหรือคะแนนของแต่ละผู้ให้บริการไม่ได้พิสูจน์โดยตรงว่างานของคุณจะได้ผลเหมือนกัน
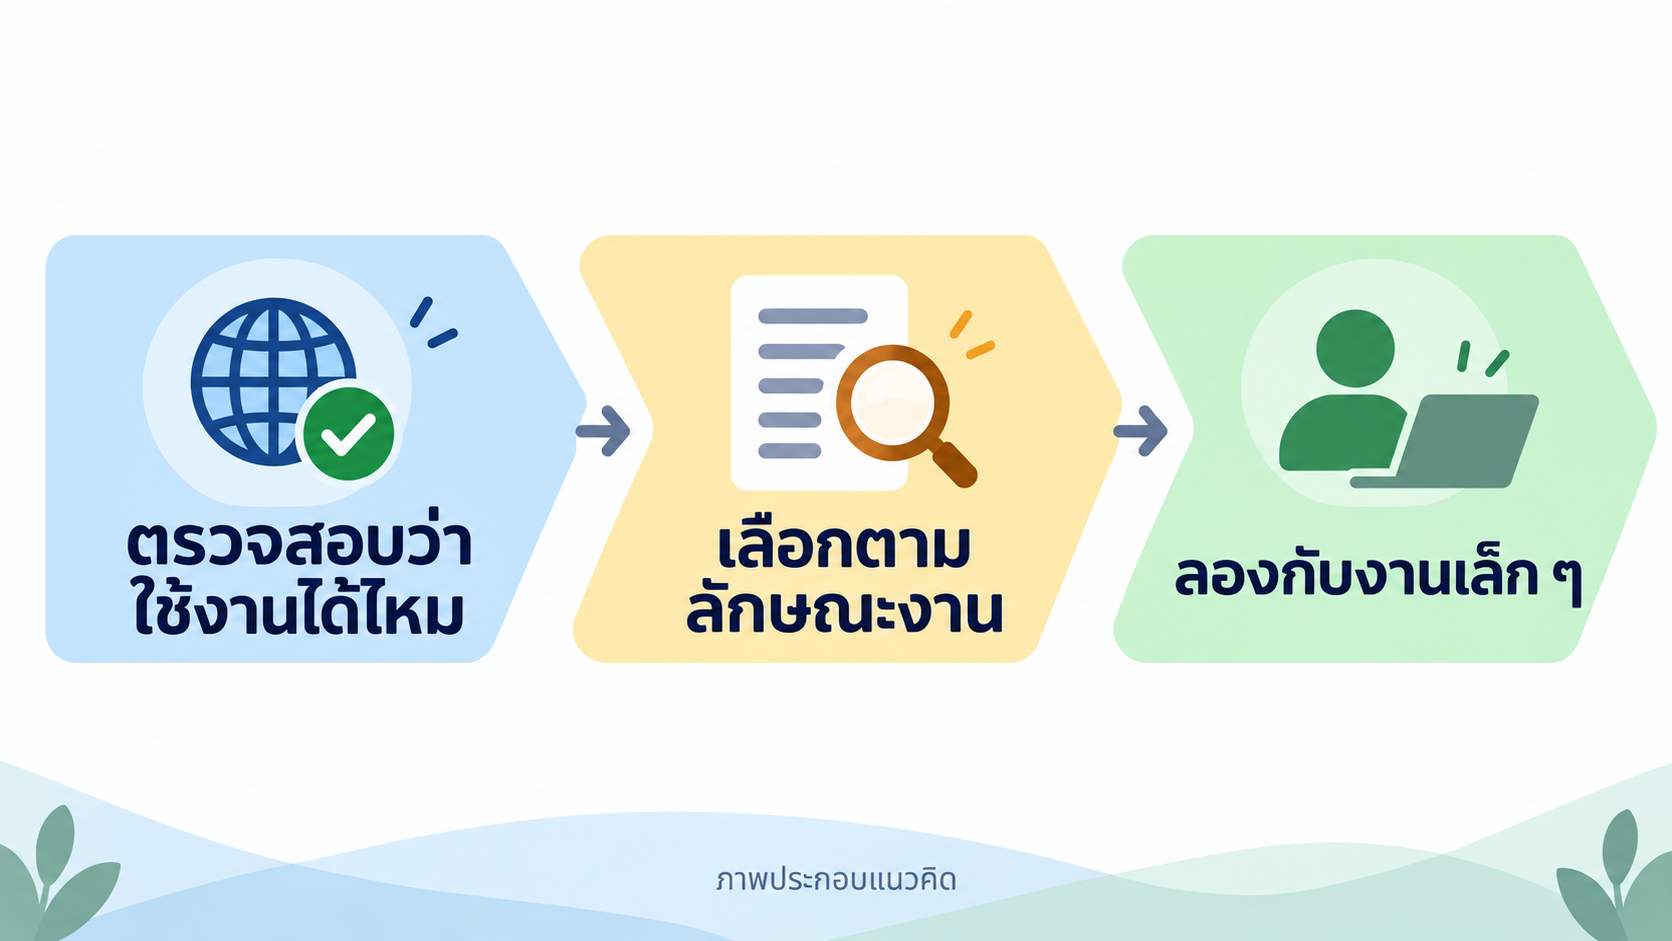
ภาพ: ภาพแนวคิดเส้นทางการเลือกที่สร้างโดย AI เริ่มจากดูความพร้อมใช้ของบัญชีและภูมิภาค ต่อด้วยดูความต้องการของงาน สุดท้ายตรวจสอบด้วยงานเล็ก ๆ ของตัวเอง “บทความนี้ไม่ทำการทดสอบเปรียบเทียบใด ๆ” ในภาพหมายถึงเราไม่ได้รันการทดสอบภายใต้เงื่อนไขเดียวกันเอง; ตารางคะแนนด้านบนเป็นการถอดข้อมูลที่ Google ประกาศ ดูภาพขนาดต้นฉบับ (1672×941)

หากงานของคุณคือให้ผู้ช่วยเขียนโปรแกรมสองตัวแบ่งงานกัน ดูบทเรียนการทำงานร่วมกันของ Claude Code กับ Codex; หากต้องการส่งคำถามเฉพาะให้หน้า ChatGPT Pro ที่ล็อกอินอยู่ ดูบทเรียนการขอความช่วยเหลือจาก ChatGPT Pro ของ Codex และ Claude Code สองบทความนี้แนะนำการทำงานของเวิร์กโฟลว์ ไม่ได้หมายความว่า Gemini 4 Argon เชื่อมต่อกับ PandaNpc แล้ว
คำถามที่พบบ่อย FAQ
Gemini 4 Argon เปิดตัวทางการแล้ว ทำไมฉันหาไม่เจอ?
“เปิดตัว” หมายถึง Google ประกาศโมเดลและเปิดให้ในวงจำกัด; ประกาศทางการ ยังไม่ได้ให้วันเปิด统一的สำหรับนักพัฒนาทั้งหมดและผู้บริโภคทั่วไป ตรวจรายการโมเดลทางการของผลิตภัณฑ์ Gemini และบัญชีที่คุณใช้ก่อน อย่าเอา “Gemini 4 Pro” ที่เป็นข่าวลือมาเป็นช่องทางใช้ Argon
Astra คือ Project Astra ของ Google หรือไม่?
ไม่ใช่ GPT-6 Astra ในบทความนี้คือ โมเดลของ OpenAI; Google Project Astra เป็นอีกหนึ่งโครงการวิจัย นำมาปนในตารางราคาสามโมเดลไม่ได้
สมัคร Claude Pro แล้วใช้ Fable 5.1 ภายในโควตาแพ็กเกจได้ไหม?
ไม่แน่ คำอธิบายแพ็กเกจปัจจุบัน ของ Anthropic ระบุว่า Pro ใช้ Fable 5.1 ต้องมี usage credits ส่วนบางแพ็กเกจอย่าง Max ใช้ได้ภายในโควตารายสัปดาห์ที่จำกัด ก่อนจ่ายเงินให้ดูหน้า “การใช้งาน/เครดิต” ของตัวเอง
ใช้ราคาด้านบนตัดสินได้เลยไหมว่าใครคุ้มที่สุด?
ไม่ได้ ตาราง API เปรียบเทียบเพียงราคาที่ตั้งไว้; การทำงานให้สำเร็จยังได้รับผลจากความยาวอินพุต เนื้อหาซ้ำเข้าแคชหรือไม่ ค่าเครื่องมือ จำนวนรอบที่รัน และการแก้ซ้ำ โดยเฉพาะ Argon ยังไม่เปิดกว้าง จึงให้ “ต้นทุนต่อหนึ่งงานที่สำเร็จ” ของเราเองไม่ได้
คู่มือที่เกี่ยวข้อง

GPT-6 Sol vs Claude Opus 5.5: ราคา คะแนน และงานเขียนโค้ดควรเลือกอย่างไร?
งานเขียนโปรแกรมผ่าน API ทั่วไป แนะนำให้ลอง GPT-6 Sol ก่อน; งานที่ซับซ้อนอาจเปรียบเทียบกับ Claude Opus 5.5 แล้วจึงนำ GPT-6 Astra และ Claude Fable 5.1 มาเป็นตัวเลือกสำหรับงานยาก บทความนี้ตรวจสอบสเปกอย่างเป็นทางการของทั้งสี่โมเดล ราคาแคชและ Batch คะแนนทดสอบจากบุคคลที่สามแบบเกณฑ์เดียวกัน และให้สถานการณ์ค่าใช้จ่ายที่คำนวณซ้ำได้ 5 ชุด
อ่านบทความ →
Claude Code vs Codex: เลือกอย่างไรระหว่างฟีเจอร์ การควบคุมระยะไกล สิทธิ์ และกรณีการใช้งาน (2026)
สรุป: Claude Code สำหรับงานเทอร์มินัลเชิงลึก Hooks และระบบนิเวศ Claude; Codex สำหรับ ChatGPT งานคลาวด์และหลาย Agent; PandaNpc เพื่อควบคุมทั้งคู่จากระยะไกลบน Windows, macOS, Linux และมือถือ
อ่านบทความ →
วิธีใช้ ChatGPT Pro ร่วมกับ Codex และ Claude Code ใน PandaNpc
ในบทสนทนา Codex หรือ Claude Code ของ PandaNpc คุณสามารถมอบคำถามเฉพาะเจาะจงให้กับหน้าเว็บ ChatGPT Pro ที่ลงชื่อเข้าใช้แล้วได้ และคำตอบจะกลับไปยังบทสนทนาเดิม
อ่านบทความ →