
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 — איך בוחרים? השוואת זמינות, מחירים ומקרי שימוש
נכון ל-30.9.2026, Gemini 4 Argon זמין לבודקים בלבד, בעוד שעבור GPT-6 Astra ו-Claude Fable 5.1 כבר בתשלום יש לבחור לפי משימה ותוכנית; API בנפרד ממנויים, לפי מידע רשמי ולא מבחן באותם תנאים.
בדיקת מקורות: 30 בספטמבר 2026 (UTC). PandaNpc מספקת שירותי AI Agent, וזה קשור לבחירת מודלים. מאמר זה מרכז מידע פומבי משלוש החברות, ומציע המלצות לבחירה לפי משימה; עדיין לא קיבלנו הרשאת ניסיון ל-Gemini 4 Argon, ולא ביצענו בדיקה בפועל של שלושת המודלים באותם תנאים. "מתאים" בהמשך מתייחס למיצוב הרשמי ולזמינות הנוכחית, ואינו אומר שמדדנו מי חזק יותר.
המסקנה תחילה: אם צריך להשתמש בזה היום, בחרו תחילה בין GPT-6 Astra ל-Claude Fable 5.1 לפי המשימה והחבילה הקיימת; Gemini 4 Argon פתוח כרגע רק למספר קטן של בודקים מהימנים, ומשתמש רגיל עדיין לא יכול להתייחס אליו כאפשרות שלישית זמינה תמיד. לעבודה חוצת תוכנות, ארגון מידע מורכב או תכנות קשה, אפשר לנסות קודם את Astra; לתכנות ממושך, קריאה חוזרת של פרויקטים גדולים או מסמכים מורכבים, אפשר לנסות קודם את Fable 5.1. לאחר ש-Argon ייפתח באופן רחב, השוו עם אותה משימה את איכות ההשלמה בפועל ואת העלות הכוללת.
צפייה בתמונת השער בגודל המקורי PNG (1672×941)
קודם כל, האם אפשר להשתמש: שלושת המודלים לא באותו קו התחלה
| מודל | תאריך פרסום רשמי | מי יכול להשתמש נכון ל-30 בספטמבר | מה זה אומר לקורא הרגיל |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | נפתח תחילה למגני סייבר ובודקים מהימנים בפרויקט Google Fairwind; פתיחה רחבה למפתחים, לארגונים ולצרכנים ממתינה לשלבים הבאים | לראות היום "פורסם" לא אומר שחשבון ה-Gemini או ה-API שלך כבר יכולים לבחור ב-Argon |
| GPT-6 Astra | 2026-09-03 | מושק בשלבים למשתמשי ChatGPT בתשלום ולמשתמשי API; המכסה הזמינה בפועל תלויה בחבילה ובחשבון | אפשר לבדוק את רשימת המודלים והמכסה שלך, ולהתחיל מיד במשימה אמיתית |
| Claude Fable 5.1 | 2026-09-01 | זמין בחבילות Claude בתשלום וב-Claude API, אך חבילות כמו Pro עשויות לדרוש קרדיטי שימוש נוספים | בדקו תחילה את כללי השימוש ב-Fable בחבילה, ורק אחר כך החליטו אם לשדרג או לשלם בנפרד |
ההודעה של Google על Gemini 4 Argon מציינת שכרגע מדובר בפתיחה בהיקף מצומצם, ובעתיד מתוכנן להתרחב החל ממשתמשי API בתשלום ומנויי Google AI Ultra; לא פורסם תאריך ודאי לשימוש על ידי משתמשים רגילים. ההודעה של OpenAI על Astra וההסבר של Anthropic על Fable 5.1 מפרטים כל אחד את היקף הזמינות הנוכחי. Astra כאן הוא מודל של OpenAI, ולא פרויקט המחקר Project Astra של Google.
השוואת מפרטים: אל תערבבו בין "כמה אפשר לקרוא" ל"כמה אפשר לכתוב"
חלון הקשר קלט הוא כמה חומר אפשר למסור למודל בבת אחת; הפלט המרבי הוא כמה תוכן הוא יכול ליצור לכל היותר בפעם אחת. שני המספרים האלה אינם ניתנים להחלפה, ואין להסיק מהם לבדם על איכות התשובה. להלן מידע על דגמים ספציפיים שנבדק ב-30 בספטמבר 2026, ולא מפרט כללי של כל משפחות Gemini, GPT או Claude.
| פרמטר | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| חלון הקשר קלט | התקרה הרשמית לא פורסמה | 1,050,000 טוקן | 1,000,000 טוקן |
| פלט מרבי בפעם אחת | בהודעת Google נכתב 1,000,000 טוקן; משתמשים רגילים עדיין לא יכולים לאמת זאת | 128,000 טוקן | 128,000 טוקן |
| קלט שאפשר למסור למודל | ההודעה מציגה הבנה מולטימודלית ווידאו ארוך, אך רשימת סוגי הקלט המלאה של API לא פורסמה | טקסט, תמונות | טקסט, תמונות |
| שער רשמי נוכחי | בודקים מהימנים של Fairwind; מועד הפתיחה הרחבה לא פורסם | חשבונות ChatGPT בתשלום לפי קצב ההשקה והחבילה, OpenAI API | מוצרי Claude בתשלום ו-Claude API; חבילות כמו Pro כוללות תנאי קרדיטים נוספים |
מקורות: ההודעה של Google על Gemini 4 Argon, עמוד הדגם GPT-6 Astra של OpenAI, עמוד הדגם Claude Fable 5.1 של Anthropic והסבר החבילות של Anthropic. ה-"מיליון" בהודעת Google מתייחס לתקרת הפלט, ואין להתייחס אליו כאל כך ש-Argon כבר פרסם "חלון הקשר קלט של מיליון". כרטיס הדגם הפומבי המלא של Argon ובדיקות משתמשים רגילים עדיין ממתינים לפרסום; "לא פורסם" בטבלה אינו "אין את היכולת הזו".
הטבלה למעלה משווה מפרטים פומביים, לא ניצחון בביצועים: ככל שאפשר להכיל יותר תוכן, התשובה לא בהכרח מדויקת יותר. הטבלה הבאה היא הציונים של מדדי הביצועים.
השוואת ציונים רשמיים: הסתכלו על משימות ספציפיות, אל תחשבו "אלוף כולל"
Google DeepMind פרסמה בטבלת ציונים של ארבעה מודלים בעמוד הדגם הרשמי של Gemini 4 Argon. כאן מוצגות רק שלוש העמודות של Argon, GPT-6 Astra ו-Claude Fable 5.1 הנדונות במאמר; הטבלה המקורית כוללת גם את Claude Opus 5.5. הציונים הבאים מגיעים מעמוד אתר Google שנקרא בפועל ב-30 בספטמבר 2026, 23:42 UTC, נאספו על ידי Google, ואינם בדיקה של PandaNpc באותם תנאים. למעט שורות שמצוין בהן F1, שיעור מעבר או ציון חלקי, הערכים הם באחוזים לפי הטבלה המקורית; בכל שורה, רק בקרב שלושת המודלים האלה הערך הגבוה יותר הודגש. "—" אומר שאין בטבלה המקורית ציון בר-השוואה, ולא 0.
| קבוצת יכולת | Benchmark (פריט בדיקה) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| עבודת ידע | Vals Index | 68.9% | 63.1% | 65.8% |
| עבודת ידע | AutomationBench | 51.3% | 41.4% | 31.4% |
| עבודת ידע | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| עבודת ידע | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| תכנות אוטומטי | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| תכנות אוטומטי | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| תכנות אוטומטי | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| תכנות אוטומטי | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| הנדסת למידת מכונה | PostTrainBench | 45.3% | 44.3% | 40.2% |
| מדע ומתמטיקה | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| מדע ומתמטיקה | LABBench 2 | 88.8% | 85.4% | 68.6% |
| מדע ומתמטיקה | RiemannBench | 76.0% | 72.0% | 65.6% |
| טקסט ארוך | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 91.4% |
| טקסט ארוך | GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 65.0% |
| תפעול מחשב | Agent's Last Exam (שיעור מעבר) | 39.5% | 34.2% | — |
| תפעול מחשב | OSWorld-2.0 (תת-קבוצה לא מקוונת, ציון חלקי) | 69.2% | 72.6% | — |
| הבנת תמונות וטקסט | Chartography | 71.6% | 71.0% | 46.2% |
| הבנת וידאו | LVBench | 91.7% | 87.5% | 79.7% |
| אבטחה הגנתית | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
איך להשתמש בטבלה הזו? אם אתה עוסק בעבודת ידע, אפשר להסתכל קודם על Vals Index, Finance Agent; בכתיבת קוד אפשר להסתכל גם על DeepSWE, FrontierSWE ו-Terminal-bench, ולא לבחור רק שורה אחת: Argon מוביל ב-DeepSWE, אבל Astra גבוה יותר ב-FrontierSWE וב-Terminal-bench. בתפעול מחשב שימו לב במיוחד: שתי השורות של Fable בטבלה הזו של Google חסרות, ואין להסיק מכך שהוא לא יודע לתפעל מחשב. CWE-bench מראה ש-Argon ו-Astra בתיקו מבין השלושה; גם זה אינו ערובה לעבודת אבטחה אמיתית.
מתודולוגיית הבדיקה: ההסבר של Google על מתודולוגיית ההערכה מציין שהציונים של Argon הם בדרך כלל ניסיון בודד וברמת החשיבה הגבוהה ביותר; הנתונים של מודלים אחרים מגיעים ברובם מדיווח עצמי של הספקים או מטבלאות פומביות, וייתכן שהם משתמשים ברמת החשיבה הגבוהה או הזמינה שלהם. חלק מהפרויקטים הורצו על ידי Google עצמה, וחלקם הגיעו מצד שלישי; סביבות הכלים ושיטות הדגימה אינן זהות בכל מקום. לדוגמה, ציוני Argon ב-DeepSWE וב-Terminal-bench הם בדיקה עצמית של Google, בעוד למודלים אחרים משתמשים בציונים פומביים; LVBench שואב מספר שונה של פריימים מווידאו עבור מודלים שונים. שורת GraphWalks משתמשת ב-BFS F1, ושורת OSWorld מייצגת רק "ציון חלקי" של תת-קבוצה לא מקוונת. אין לחשב ממוצע בין שורות, ואין להכריז על סמך זה על מקום ראשון כולל בתנאי בדיקה אחידים. עמוד התוצאות של PDF המתודולוגיה הזה מציין "נכון לאוקטובר 2026", וזה לא תואם לזמן שבו קראנו את הטבלה במאמר זה, 30 בספטמבר; לא ניתן לאשר את תאריך השלמת ההערכה המדויק. מאמר זה רק מתעתק את הציונים שהיו גלויים באתר הרשמי באותו זמן, אינו מסיק מתי הושלמה ההערכה, ואינו מציג אותם כתוצאה שאנחנו שחזרנו.
איך להשוות מחירים: יש להפריד בין דמי מנוי חודשיים לעלויות API
אם רוצים להשתמש רק במוצר צ'אט או בכלי תכנות, הסתכלו קודם על המנוי והמכסה. במחירים הפומביים בארה"ב, ChatGPT Plus הוא $20 לחודש, ו-Pro מתחלק למדרגות של $100, $200, $500 לחודש וכדומה; השימוש בפועל ב-Astra משתנה לפי החבילה והמשימה. ההסבר של OpenAI על מחירי ושימוש ב-ChatGPT Work/Codex מזהיר במפורש: מחיר API לכל מיליון טוקן אינו יכול לשמש לחישוב כמה משימות אפשר להשלים בתוך המנוי.
Claude Pro בארה"ב עולה $20 בחודש, ו-Max מתחיל מ-$100 לחודש (טבלת המחירים הרשמית של Claude). אבל "אפשר לבחור Fable 5.1 ב-Pro" לא אומר ש-Fable נכלל במכסה הרגילה של Pro: כללי חבילות Fable של Anthropic מסבירים שב-Pro ובמושבים סטנדרטיים של Team, שימוש ב-Fable 5.1 מחייב usage credits נוספים; ב-Max ובמושבים מתקדמים אפשר להשתמש בתוך חלק מהמכסה השבועית. Google עדיין לא פרסמה מחיר מנוי בפועל או תאריך פתיחה לשימוש של משתמשים רגילים ב-Argon, ואין להתייחס למחיר החודשי הנוכחי של Google AI Ultra כהצעה "לקניית Argon היום".
אם משלמים דרך API לפי שימוש, להלן מחירי טקסט סטנדרטיים שאפשר לקרוא באותה יחידה. קלט הוא התוכן שאתה מוסר למודל לקריאה, ופלט הוא התשובה שהוא יוצר. היחידה היא מחיר בדולרים לכל מיליון טוקן (טוקן הוא יחידה שבה מפרקים טקסט ותוכן לצורך חיוב); Argon בטבלה הוא מחיר השקה עתידי ש-Google פרסמה, ולא חשבון בדיקה שכבר שילמנו היום.
| מודל | קלט רגיל | פלט רגיל | קריאת מטמון של תוכן חוזר | סטטוס |
|---|---|---|---|---|
| Gemini 4 Argon | מחיר השקה מתוכנן $2; אחרי תקופת ההטבה $4 | מחיר השקה מתוכנן $10; אחרי תקופת ההטבה $20 | Google אומרת שקלט מטמון בהשקה יהיה בהנחה של 95% ממחיר הקלט הרגיל; כללי ההשקה המדויקים ממתינים לאימות | עדיין לא פתוח באופן רחב |
| GPT-6 Astra | $10 | $50 | $1 | מחיר API סטנדרטי נוכחי |
| Claude Fable 5.1 | $10 | $50 | $0.25 | מחיר API סטנדרטי נוכחי |
הנתונים מגיעים מהודעת ההשקה של Argon של Google, עמוד המחירים של מודל Astra של OpenAI ועמוד המודל Fable 5.1 של Anthropic. המחירים אינם כוללים כלים נוספים, אזורים, מדרגות מהירות או הבדלי פלטפורמה; כאשר קלט בודד עולה על 272K טוקן, Astra מתמחרת את הקלט והמטמון של כל הבקשה פי 2, ואת הפלט פי 1.5. מחיר המטמון חל רק על תוכן שבאמת נמצא במטמון, ואין להעריך את כל המשימה לפי מחיר המטמון. גם אם מחיר היחידה המתוכנן של Argon נמוך משני האחרים, בלי נתוני שיעור הצלחה וצריכה באותה משימה, אין לקבוע שהוא הזול ביותר להשלמת משימה.
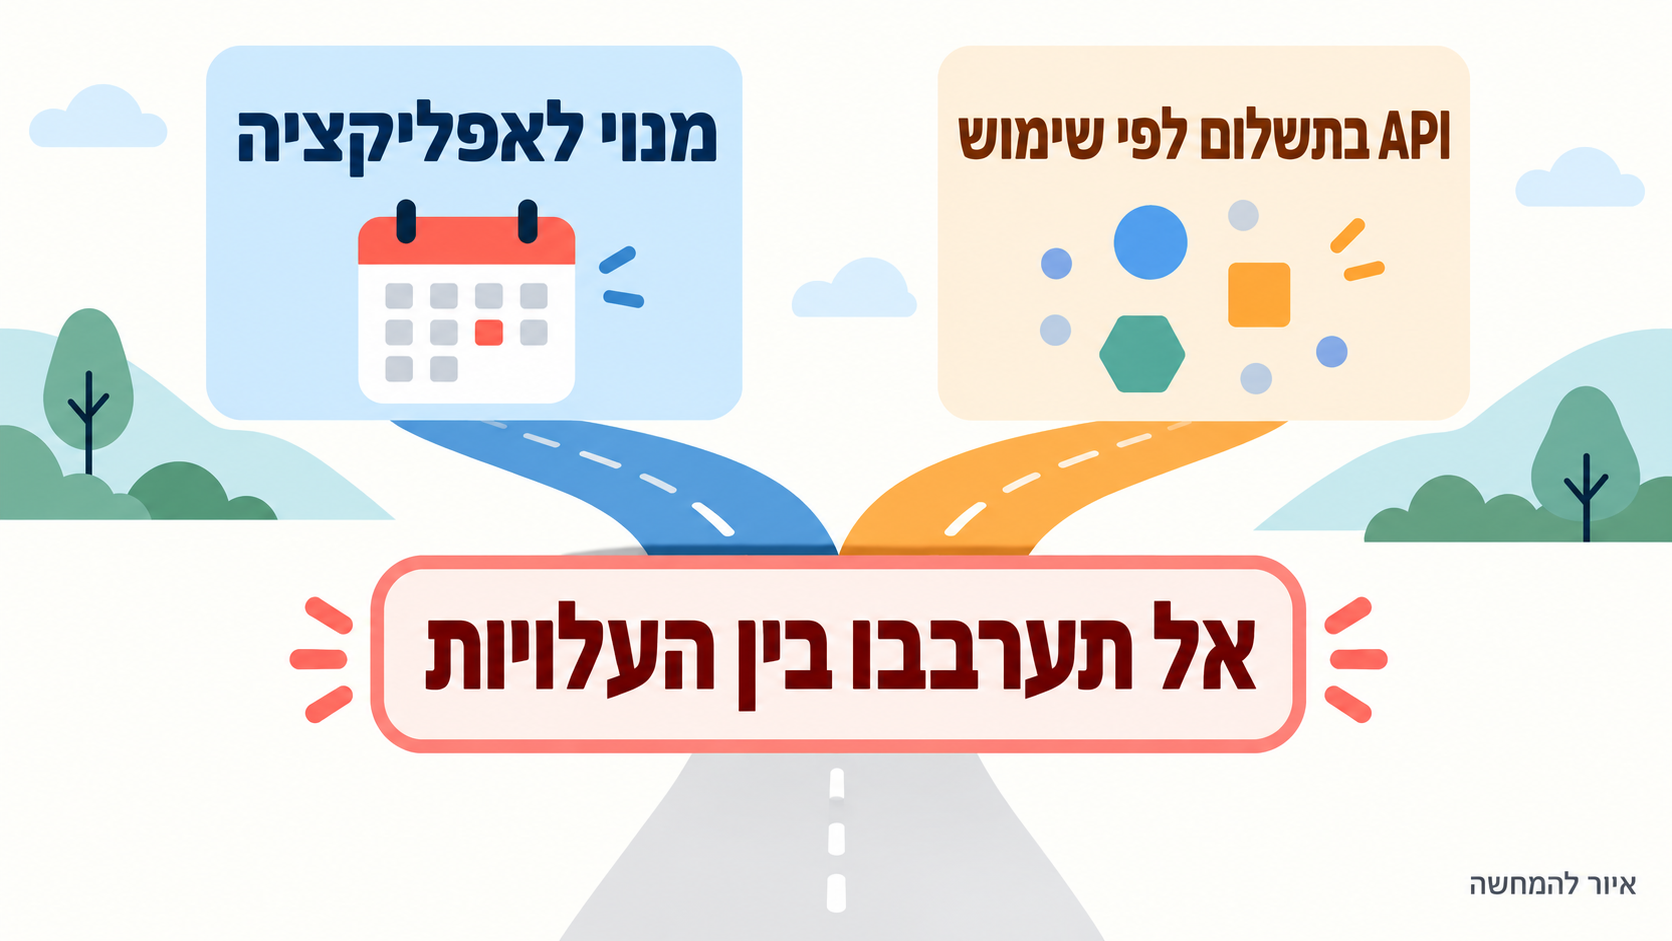
תמונה: המחשת מודל חיוב שנוצרה ב-AI, לא חשבון מוצר; אין לערבב דמי מנוי חודשיים עם מחיר יחידה של API. צפייה בתמונה בגודל המקורי (1672×941).

איך לבחור לפי משימה? השתמשו קודם במודלים הזמינים לכם
משימה שחוצה כמה תוכנות, או דורשת גלישה באינטרנט, תפעול ממשקים וקבלת החלטות מורכבות: נסו קודם את GPT-6 Astra. OpenAI מציינת תפעול מחשב, גלישה, תכנות קשה ומסמכים מקצועיים כיכולות המרכזיות שלו. אם יש לך חשבון ChatGPT מתאים בתשלום או הרשאת API, אפשר היום למסור לו משימה אמיתית ולראות אם התוצאה עומדת בדרישות. הסבר המודל של OpenAI.
משימה של תכנות, סקירת קוד או עבודה על מסמכים גדולים שנמשכת שעות: נסו קודם את Claude Fable 5.1. Anthropic ממקמת אותו למשימות אוטונומיות ארוכות, תכנות מורכב ומחקר. מי שכבר יש לו זרימת עבודה עם Claude Code יכול להמשיך להשתמש בכלים המוכרים, אבל צריך לבדוק תחילה אם החבילה מחייבת קרדיטי שימוש בנפרד; אם בכל יום מריצים הרבה משימות כאלה, השוו את העלות האמיתית של Max מול API. הסבר המודל של Anthropic.
רוצים לנסות את Gemini 4 Argon: בדקו קודם אם קיבלתם הרשאת גישה רשמית. הכיוונים ש-Google פרסמה כוללים תכנות מורכב, עבודת ידע ארגונית ומשימות אבטחה הגנתית, והיא גם פרסמה מחירים מתוכננים; אלה ראויים לתשומת לב, אבל עדיין לא מחליפים חוויית בדיקה של משתמש רגיל. בלי הרשאה, לא מומלץ לשנות זרימת עבודה פעילה בגלל ה"צפי להיות זול יותר" של Argon. ההודעה הרשמית של Google.
ההמלצות האלה אינן אומרות ש"מודל שטוב בסוג אחד של משימות יכול לעשות רק אותו". אם בעתיד כל השלושה יהיו זמינים, הדרך הבטוחה ביותר לבחור היא: קחו אותה משימה אמיתית, תנו את אותם חומרים ואותם קריטריוני קבלה, ותעדו בנפרד האם הושלמה, כמה עבודה ידנית נדרשה לתיקון, כמה זמן זה לקח ומה העלות הכוללת. הדגמה מרשימה אחת או ציוני benchmark של כל ספק בנפרד לא יכולים להוכיח ישירות שגם המשימה שלך תקבל את אותה תוצאה.
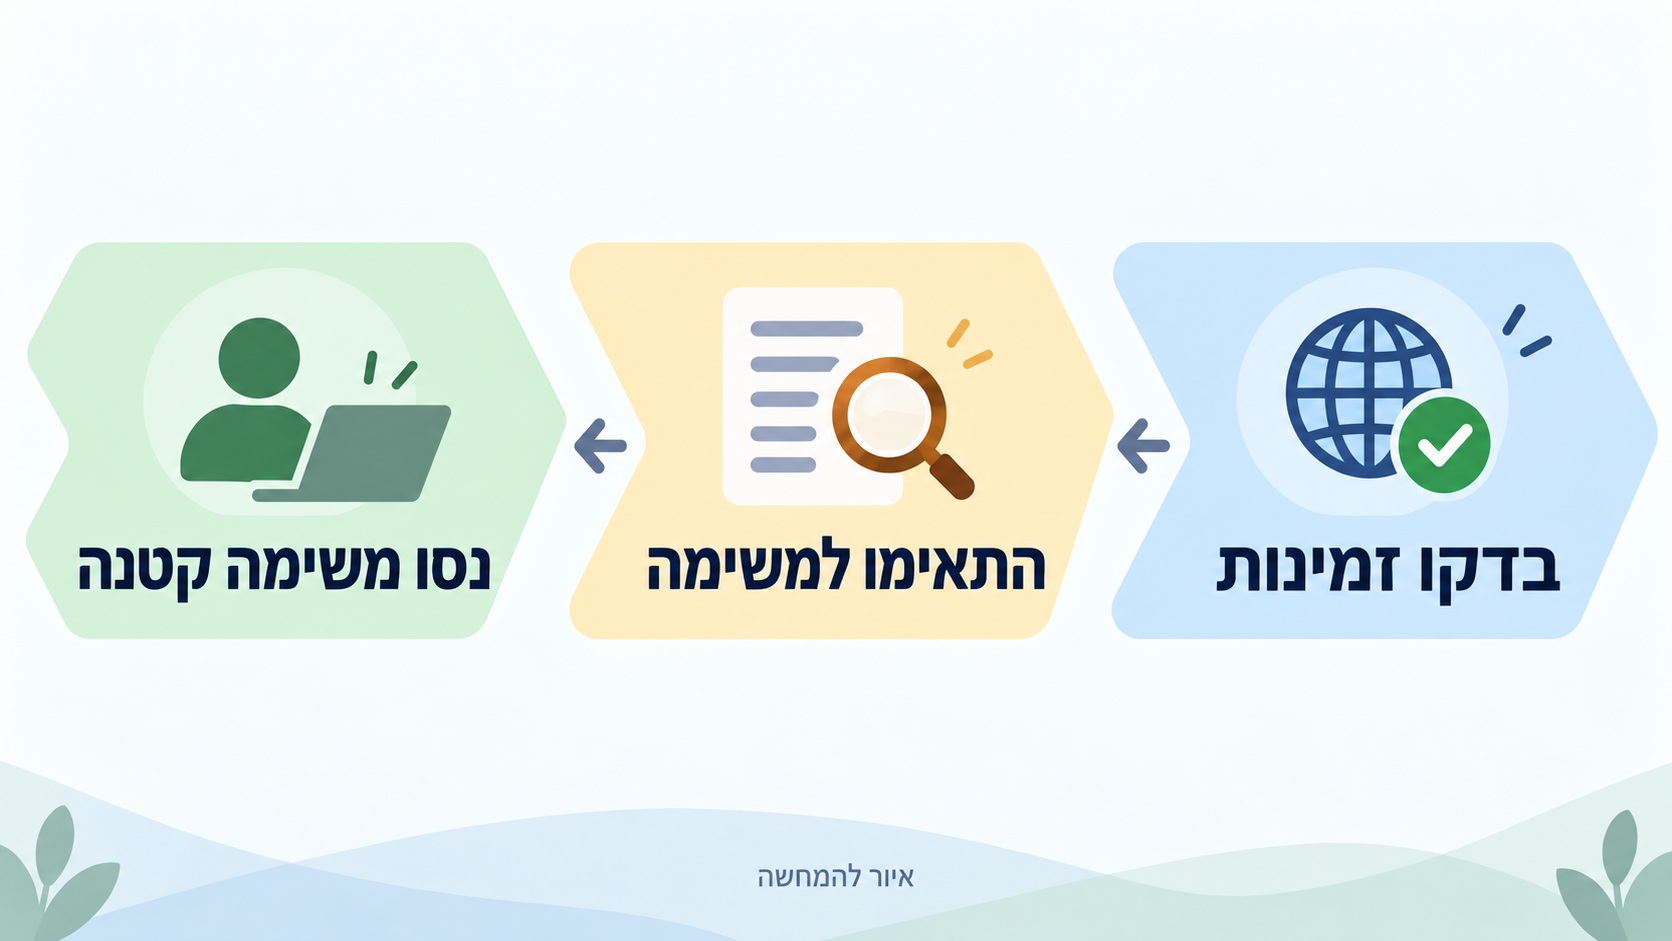
תמונה: המחשת מסלול בחירה שנוצרה ב-AI, קודם בודקים זמינות חשבון ואזור, אחר כך צורכי המשימה, ולבסוף מאמתים עם משימה קטנה משלך. "מאמר זה אינו מבצע בדיקת השוואה" בתמונה מתייחס לכך שלא הרצנו בעצמנו בדיקה באותם תנאים; טבלת הציונים למעלה היא תעתיק של נתונים ש-Google פרסמה. צפייה בתמונה בגודל המקורי (1672×941).

אם המשימה שלך היא לחלק עבודה בין שני עוזרי תכנות, ראו מדריך שיתוף הפעולה בין Claude Code ל-Codex; אם רוצים למסור שאלה ספציפית לעמוד ChatGPT Pro שמחובר, ראו מדריך פנייה ל-ChatGPT Pro מ-Codex ומ-Claude Code. שני אלה מציגים תפעול של זרימות עבודה, ולא אומרים ש-Gemini 4 Argon כבר מחובר ל-PandaNpc.
שאלות נפוצות (FAQ)
Gemini 4 Argon כבר פורסם רשמית, אז למה אני לא מוצא אותו?
"פרסום" פירושו ש-Google הציגה את המודל ופתחה אותו להיקף מוגבל; ההודעה הרשמית עדיין לא נתנה תאריך פתיחה אחיד לכל המפתחים והצרכנים הרגילים. בדקו קודם את רשימת המודלים הרשמית של מוצר ה-Gemini והחשבון שבשימוש�ם, ואל תתייחסו ל"Gemini 4 Pro" משמועות כשער זמין ל-Argon.
האם Astra הוא Project Astra של Google?
לא. GPT-6 Astra במאמר זה הוא מודל של OpenAI; Google Project Astra הוא פרויקט מחקר אחר, ואין לערבב ביניהם בטבלת המחירים של שלושת המודלים.
אם נרשמתי ל-Claude Pro, אפשר להשתמש ב-Fable 5.1 בתוך מכסת החבילה?
לא בהכרח. ההסבר הנוכחי על החבילות של Anthropic אומר שבשימוש ב-Fable 5.1 עם Pro נדרשים usage credits, בעוד שבחלק מהחבילות כמו Max אפשר להשתמש בתוך מכסה שבועית מוגבלת. לפני תשלום, בדקו את עמוד "שימוש/קרדיטים" שלכם.
אפשר לקבוע ישירות לפי המחירים למעלה מי הכי משתלם?
לא. טבלת ה-API משווה רק מחירי מחירון; השלמת משימה מושפעת גם מאורך הקלט, משאלה אם תוכן חוזר נמצא במטמון, מעלויות כלים, ממספר סבבי הרצה ומתיקוני עבודה. במיוחד Argon עדיין לא פתוח באופן רחב, ולכן אי אפשר לתת "עלות לכל משימה מוצלחת" משלנו.
מדריכים קשורים

GPT-6 Sol מול Claude Opus 5.5: מחיר, ציוני ביצועים ואיך לבחור למשימות תכנות?
עבור משימות תכנות API כלליות, נסו קודם את GPT-6 Sol; במשימות מורכבות אפשר להשוות מול Claude Opus 5.5, ואז לקחת את GPT-6 Astra ואת Claude Fable 5.1 כאפשרויות לקושי גבוה. מאמר זה בודק את המפרטים הרשמיים של ארבעת המודלים, מחירי מטמון ו-Batch, ציוני בנצ'מרק של צד שלישי באותה שיטה, ומציג חמש קבוצות של תרחישי עלות הניתנים לחישוב מחדש.
קרא מאמר →
Claude Code לעומת Codex: כיצד לבחור בין תכונות, שליטה מרחוק, הרשאות ותרחישי שימוש (2026)
בשורה התחתונה: Claude Code לעבודה עמוקה במסוף, Hooks ואקוסיסטם Claude; Codex ל-ChatGPT, משימות ענן וריבוי Agent; PandaNpc לשליטה מרחוק בשניהם דרך Windows, macOS, Linux והנייד.
קרא מאמר →
איך להשתמש ב-ChatGPT Pro עם Codex ו-Claude Code ב-PandaNpc
בשיחה ב-Codex או ב-Claude Code של PandaNpc, אפשר להעביר שאלה ספציפית לדף האינטרנט של ChatGPT Pro שבו אתם מחוברים, והתשובה תחזור לשיחה המקורית.
קרא מאמר →