
Bagaimana memilih Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1? Perbandingan ketersediaan, harga, dan skenario penggunaan
Gemini 4 Argon terbatas; pilih GPT-6 Astra atau Claude Fable 5.1 yang tersedia sesuai tugas dan paket, dengan harga API terpisah dari langganan menurut data resmi, bukan uji kondisi sama.
Verifikasi data: 30 September 2026 (UTC). PandaNpc menyediakan layanan AI Agent, yang berkaitan dengan pemilihan model. Artikel ini merangkum informasi publik dari tiga perusahaan dan memberikan saran pemilihan berdasarkan tugas; kami belum memperoleh akses uji coba Gemini 4 Argon, dan belum melakukan pengujian langsung dengan kondisi yang sama untuk ketiga model. "Cocok" di bawah ini merujuk pada positioning resmi dan ketersediaan saat ini, bukan berarti kami menguji siapa yang lebih unggul.
Kesimpulan di awal: jika harus digunakan hari ini, pilih dulu di antara GPT-6 Astra dan Claude Fable 5.1 sesuai tugas dan paket yang ada; Gemini 4 Argon saat ini hanya dibuka untuk sedikit penguji tepercaya, pengguna umum belum bisa menganggapnya sebagai opsi ketiga yang tersedia kapan saja. Untuk operasi lintas perangkat lunak, penyusunan materi yang kompleks, atau pemrograman tingkat sulit, coba dulu Astra; untuk pemrograman jangka panjang, membaca proyek besar atau dokumen kompleks berulang kali, coba dulu Fable 5.1. Setelah Argon tersedia secara luas, baru bandingkan kualitas penyelesaian aktual dan total biaya dengan tugas yang sama.
Lihat PNG sampul ukuran asli (1672×941)
Pertama lihat apakah bisa digunakan: ketiga model tidak berada di garis start yang sama
| Model | Tanggal rilis resmi | Siapa yang bisa menggunakannya per 30 September | Apa artinya bagi pembaca umum |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Dibuka lebih dulu untuk pembela keamanan siber tepercaya dan penguji proyek Google Fairwind; pembukaan luas untuk developer, perusahaan, dan konsumen masih menunggu tahap berikutnya | Melihat "sudah dirilis" hari ini tidak berarti akun Gemini atau API Anda sudah bisa memilih Argon |
| GPT-6 Astra | 2026-09-03 | Telah diluncurkan bertahap untuk pengguna berbayar ChatGPT dan pengguna API, kuota spesifik tergantung paket dan akun | Anda dapat memeriksa daftar model dan kuota penggunaan Anda, lalu segera memulai tugas nyata |
| Claude Fable 5.1 | 2026-09-01 | Tersedia di paket berbayar Claude dan Claude API, tetapi paket seperti Pro mungkin memerlukan kredit penggunaan tambahan | Periksa dulu aturan penggunaan Fable di paket Anda, baru putuskan apakah akan upgrade atau membayar terpisah |
Pengumuman Gemini 4 Argon dari Google menyatakan bahwa saat ini pembukaannya berskala kecil, dan ke depan rencananya diperluas mulai dari pengguna API berbayar dan pelanggan Google AI Ultra; belum ada tanggal pasti yang diumumkan untuk penggunaan oleh pengguna umum. Pengumuman Astra dari OpenAI dan penjelasan Fable 5.1 dari Anthropic masing-masing menjelaskan cakupan pembukaan saat ini. Astra di sini adalah model OpenAI, bukan proyek riset Project Astra milik Google.
Perbandingan parameter: jangan mencampuradukkan "berapa banyak yang bisa dibaca" dengan "berapa banyak yang bisa ditulis"
Jendela konteks input adalah berapa banyak materi yang bisa diberikan kepada model dalam satu waktu; output maksimum adalah berapa banyak konten yang paling banyak dapat dihasilkannya dalam sekali jalan. Kedua angka ini tidak bisa saling ditukar, dan kualitas jawaban tidak bisa dinilai hanya dari angka. Berikut semuanya adalah informasi model spesifik yang diverifikasi pada 30 September 2026, bukan spesifikasi umum seluruh keluarga Gemini, GPT, atau Claude.
| Parameter | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Jendela konteks input | Batas atas resmi belum diumumkan | 1.050.000 token | 1.000.000 token |
| Output maksimum sekali jalan | Pengumuman Google menyebut 1.000.000 token; pengguna umum belum dapat memverifikasi | 128.000 token | 128.000 token |
| Input yang dapat diberikan ke model | Pengumuman menunjukkan pemahaman multimodal dan video panjang, tetapi daftar lengkap jenis input API belum diumumkan | Teks, gambar | Teks, gambar |
| Pintu masuk resmi saat ini | Penguji tepercaya Fairwind; waktu pembukaan luas belum diumumkan | Akun berbayar ChatGPT sesuai progres peluncuran dan paket, OpenAI API | Produk berbayar Claude dan Claude API; paket seperti Pro memiliki syarat kredit tambahan |
Sumber: Pengumuman Gemini 4 Argon dari Google, halaman model GPT-6 Astra dari OpenAI, halaman model Claude Fable 5.1 dari Anthropic dan penjelasan paket dari Anthropic. "1 juta" dalam pengumuman Google merujuk pada batas output, tidak bisa dianggap Argon telah mengumumkan "jendela konteks input 1 juta". Kartu model publik lengkap untuk Argon dan pengujian oleh pengguna umum masih menunggu rilis; "belum diumumkan" dalam tabel bukan berarti "tidak memiliki kemampuan ini".
Tabel di atas membandingkan spesifikasi publik, bukan menentukan menang-kalah performa: semakin banyak konten yang dapat ditampung, belum tentu jawabannya semakin akurat. Tabel di bawah barulah skor tolok ukur performa.
Perbandingan skor resmi: lihat tugas spesifik, jangan hitung "juara umum"
Google DeepMind di halaman model resmi Gemini 4 Argon mempublikasikan tabel skor empat model. Di sini hanya diambil tiga kolom yang dibahas dalam artikel ini, yaitu Argon, GPT-6 Astra, dan Claude Fable 5.1; tabel asli juga mencakup Claude Opus 5.5. Skor berikut berasal dari halaman situs resmi Google yang benar-benar dibaca pada 30 September 2026 pukul 23:42 UTC, dikompilasi oleh Google, bukan pengujian langsung PandaNpc dengan kondisi yang sama. Kecuali baris yang mencantumkan F1, tingkat kelulusan, atau skor sebagian, nilai mengikuti persentase tabel asli; setiap baris hanya menebalkan nilai yang lebih tinggi di antara ketiga model ini. "—" berarti tabel asli tidak memiliki skor yang sebanding, bukan nilai 0.
| Kelompok kemampuan | Benchmark (item pengujian) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Pekerjaan pengetahuan | Vals Index | 68.9% | 63.1% | 65.8% |
| Pekerjaan pengetahuan | AutomationBench | 51.3% | 41.4% | 31.4% |
| Pekerjaan pengetahuan | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| Pekerjaan pengetahuan | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| Pemrograman otomatis | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| Pemrograman otomatis | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| Pemrograman otomatis | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| Pemrograman otomatis | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| Rekayasa machine learning | PostTrainBench | 45.3% | 44.3% | 40.2% |
| Sains dan matematika | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| Sains dan matematika | LABBench 2 | 88.8% | 85.4% | 68.6% |
| Sains dan matematika | RiemannBench | 76.0% | 72.0% | 65.6% |
| Teks panjang | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 91.4% |
| Teks panjang | GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 65.0% |
| Operasi komputer | Agent's Last Exam (tingkat kelulusan) | 39.5% | 34.2% | — |
| Operasi komputer | OSWorld-2.0 (subset offline, skor sebagian) | 69.2% | 72.6% | — |
| Pemahaman gambar dan teks | Chartography | 71.6% | 71.0% | 46.2% |
| Pemahaman video | LVBench | 91.7% | 87.5% | 79.7% |
| Keamanan defensif | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
Bagaimana menggunakan tabel ini? Jika Anda mengerjakan pekerjaan pengetahuan, lihat dulu Vals Index, Finance Agent; untuk menulis kode, lihat sekaligus DeepSWE, FrontierSWE, dan Terminal-bench, jangan hanya memilih satu baris: Argon unggul di DeepSWE, tetapi Astra lebih tinggi di FrontierSWE dan Terminal-bench. Untuk operasi komputer, perhatikan khusus, dua baris Fable dalam tabel Google ini hilang, dan karena itu tidak bisa dikatakan ia tidak bisa mengoperasikan komputer. CWE-bench menunjukkan Argon dan Astra setara di antara ketiganya; ini juga bukan jaminan untuk pekerjaan keamanan nyata.
Metodologi pengujian: Penjelasan metodologi evaluasi dari Google menyatakan bahwa skor Argon biasanya berasal dari satu kali percobaan, pada tingkat pemikiran tertinggi; data model lain sebagian besar berasal dari laporan masing-masing vendor atau papan peringkat publik, dan mungkin menggunakan tingkat pemikiran tertinggi atau yang tersedia masing-masing. Sebagian proyek dijalankan Google sendiri, sebagian berasal dari pihak ketiga, lingkungan alat dan metode pengambilan sampel tidak sama di semua tempat. Misalnya, skor Argon untuk DeepSWE dan Terminal-bench adalah pengujian sendiri Google, sementara model lain memakai skor publik; LVBench mengambil jumlah frame video yang berbeda untuk model yang berbeda. Baris GraphWalks menggunakan BFS F1, baris OSWorld hanya mewakili "skor sebagian" dari subset offline. Tidak boleh dirata-ratakan lintas baris, dan tidak boleh diklaim sebagai peringkat pertama gabungan dalam kondisi pengujian yang seragam berdasarkan ini. Halaman hasil PDF metodologi ini juga menulis "per Oktober 2026", tidak konsisten dengan waktu pembacaan tabel dalam artikel ini pada 30 September; tanggal penyelesaian evaluasi spesifik tidak dapat dikonfirmasi. Artikel ini hanya mentranskripsikan skor yang terlihat di situs resmi saat itu, tidak menyimpulkan kapan evaluasi selesai, dan tidak menyebutnya sebagai hasil yang kami reproduksi.
Bagaimana membandingkan harga: biaya bulanan dan biaya API harus dipisahkan
Jika hanya ingin menggunakan di produk chat atau alat pemrograman, lihat dulu langganan dan kuota penggunaan. Dalam harga publik Amerika Serikat, ChatGPT Plus adalah $20/bulan, Pro dibagi ke tingkat $100, $200, $500/bulan, dan seterusnya; penggunaan Astra spesifik bervariasi menurut paket dan tugas. Penjelasan harga dan penggunaan ChatGPT Work/Codex dari OpenAI dengan jelas mengingatkan: harga API per juta token tidak dapat dipakai untuk memperkirakan berapa banyak tugas yang bisa diselesaikan dalam langganan.
Harga bulanan Claude Pro di Amerika Serikat adalah $20, Max mulai dari $100/bulan (tabel harga resmi Claude). Namun "Pro dapat memilih Fable 5.1" tidak berarti Fable sudah termasuk dalam kuota reguler Pro: aturan paket Fable dari Anthropic menjelaskan, Pro dan kursi standar Team yang menggunakan Fable 5.1 harus melalui usage credits tambahan; Max dan kursi lanjutan dapat menggunakannya dalam sebagian kuota mingguan. Google belum memberikan harga langganan aktual atau tanggal pembukaan bagi pengguna umum untuk menggunakan Argon, dan biaya bulanan Google AI Ultra saat ini tidak bisa dianggap sebagai penawaran "membeli Argon hari ini".
Jika membayar berdasarkan penggunaan melalui API, berikut ini baru tarif teks standar yang dapat dibaca dalam satuan yang sama. Input merujuk pada konten yang Anda berikan untuk dibaca model, output merujuk pada jawaban yang dihasilkannya. Satuannya semuanya harga dolar AS per 1 juta token (token adalah unit pemecahan teks dan konten lain saat penagihan); Argon dalam tabel adalah harga peluncuran mendatang yang diumumkan Google, bukan tagihan nyata yang sudah kami bayarkan hari ini.
| Model | Input biasa | Output biasa | Pembacaan cache untuk konten berulang | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Rencana awal $2; setelah periode promo $4 | Rencana awal $10; setelah periode promo $20 | Google menyebut input cache awal 95% lebih murah dari harga input biasa; aturan peluncuran spesifik masih perlu diverifikasi | Belum dibuka secara luas |
| GPT-6 Astra | $10 | $50 | $1 | Harga API standar saat ini |
| Claude Fable 5.1 | $10 | $50 | $0.25 | Harga API standar saat ini |
Data berasal dari pengumuman peluncuran Argon dari Google, halaman harga model Astra dari OpenAI, dan halaman model Fable 5.1 dari Anthropic. Harga tidak termasuk alat tambahan, wilayah, tingkat kecepatan, atau perbedaan platform; untuk Astra, ketika input sekali jalan melebihi 272K token, harga input dan cache untuk seluruh permintaan dihitung 2 kali, dan output 1,5 kali. Harga cache hanya berlaku untuk konten yang benar-benar terkena cache, tidak bisa mengestimasi seluruh tugas dengan harga cache. Meskipun harga satuan yang direncanakan Argon lebih rendah dari dua model lainnya, tanpa data tingkat keberhasilan dan penggunaan pada tugas yang sama, tidak bisa dikatakan bahwa ia paling murah untuk menyelesaikan satu tugas.
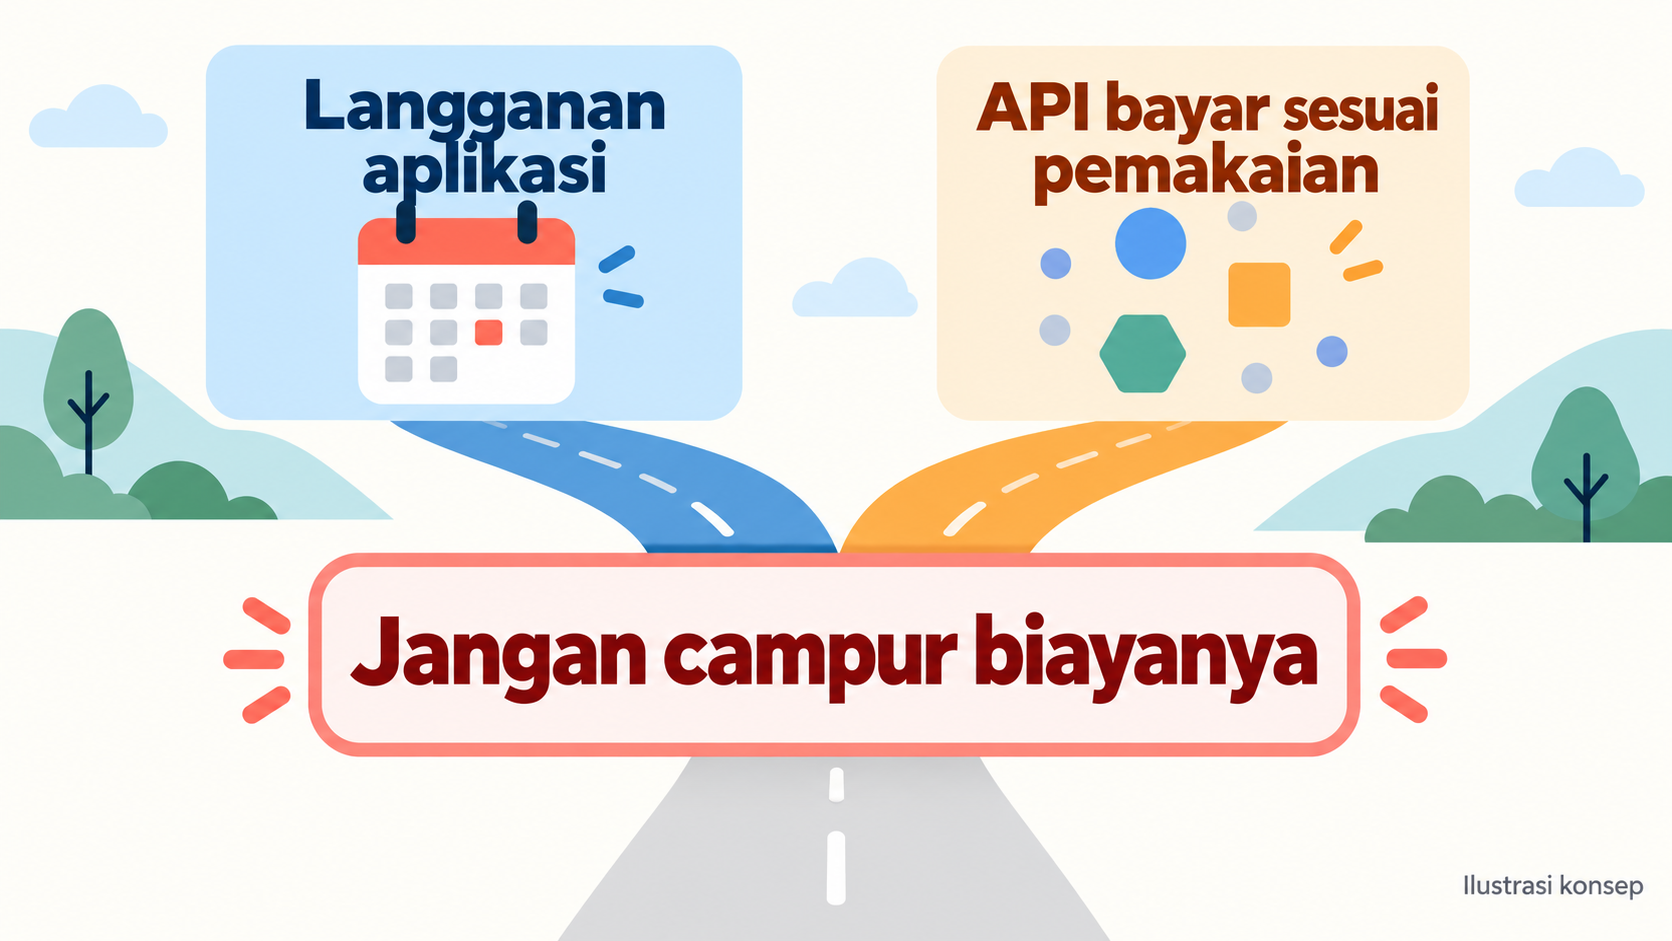
Gambar: Diagram yang dihasilkan AI tentang dasar penghitungan biaya, bukan tagihan produk; biaya bulanan langganan tidak bisa dicampur dengan harga satuan API. Lihat gambar ukuran asli (1672×941).

Bagaimana memilih berdasarkan tugas? Gunakan dulu model yang tersedia di tangan
Jika tugas melibatkan banyak perangkat lunak, atau perlu menjelajahi web, mengoperasikan antarmuka, dan membuat penilaian kompleks: coba dulu GPT-6 Astra. OpenAI mencantumkan operasi komputer, penjelajahan, pemrograman tingkat sulit, dan dokumen profesional sebagai kemampuan utamanya. Jika Anda sudah memiliki akun berbayar ChatGPT yang sesuai atau akses API, hari ini Anda bisa memberikan tugas nyata kepadanya dan melihat apakah hasilnya memenuhi kebutuhan. Penjelasan model OpenAI.
Jika tugasnya adalah pemrograman, tinjauan kode, atau pekerjaan dokumen besar yang berlangsung beberapa jam: coba dulu Claude Fable 5.1. Anthropic memposisikannya untuk tugas otonom berdurasi panjang, pemrograman kompleks, dan riset. Orang yang sudah memiliki alur kerja Claude Code dapat memakai alat yang sudah dikenal terlebih dahulu, tetapi pastikan dulu apakah paket akan memotong kredit penggunaan tambahan; jika setiap hari harus menjalankan banyak tugas seperti ini, bandingkan lagi biaya nyata Max dan API. Penjelasan model Anthropic.
Ingin mencoba Gemini 4 Argon: pastikan dulu apakah Anda mendapatkan akses resmi. Arah yang diumumkan Google mencakup pemrograman kompleks, pekerjaan pengetahuan perusahaan, dan tugas keamanan defensif, serta mencantumkan rencana harga; hal-hal ini layak diperhatikan, tetapi belum bisa menggantikan pengalaman pengujian langsung pengguna umum. Jika tidak memiliki akses, tidak disarankan mengubah alur kerja yang sedang berjalan hanya demi "perkiraan lebih murah" Argon. Pengumuman resmi Google.
Saran-saran ini bukan berarti "model yang unggul dalam satu jenis tugas hanya bisa melakukan jenis itu". Jika ketiganya tersedia di masa depan, cara memilih yang paling aman adalah: ambil satu tugas nyata yang sama, berikan materi dan standar penerimaan yang sama, lalu catat secara terpisah apakah selesai, berapa banyak pengerjaan ulang manual, waktu yang dihabiskan, dan total biaya. Satu demonstrasi yang bagus atau skor masing-masing vendor tidak dapat langsung membuktikan bahwa tugas Anda juga akan mendapatkan hasil yang sama.
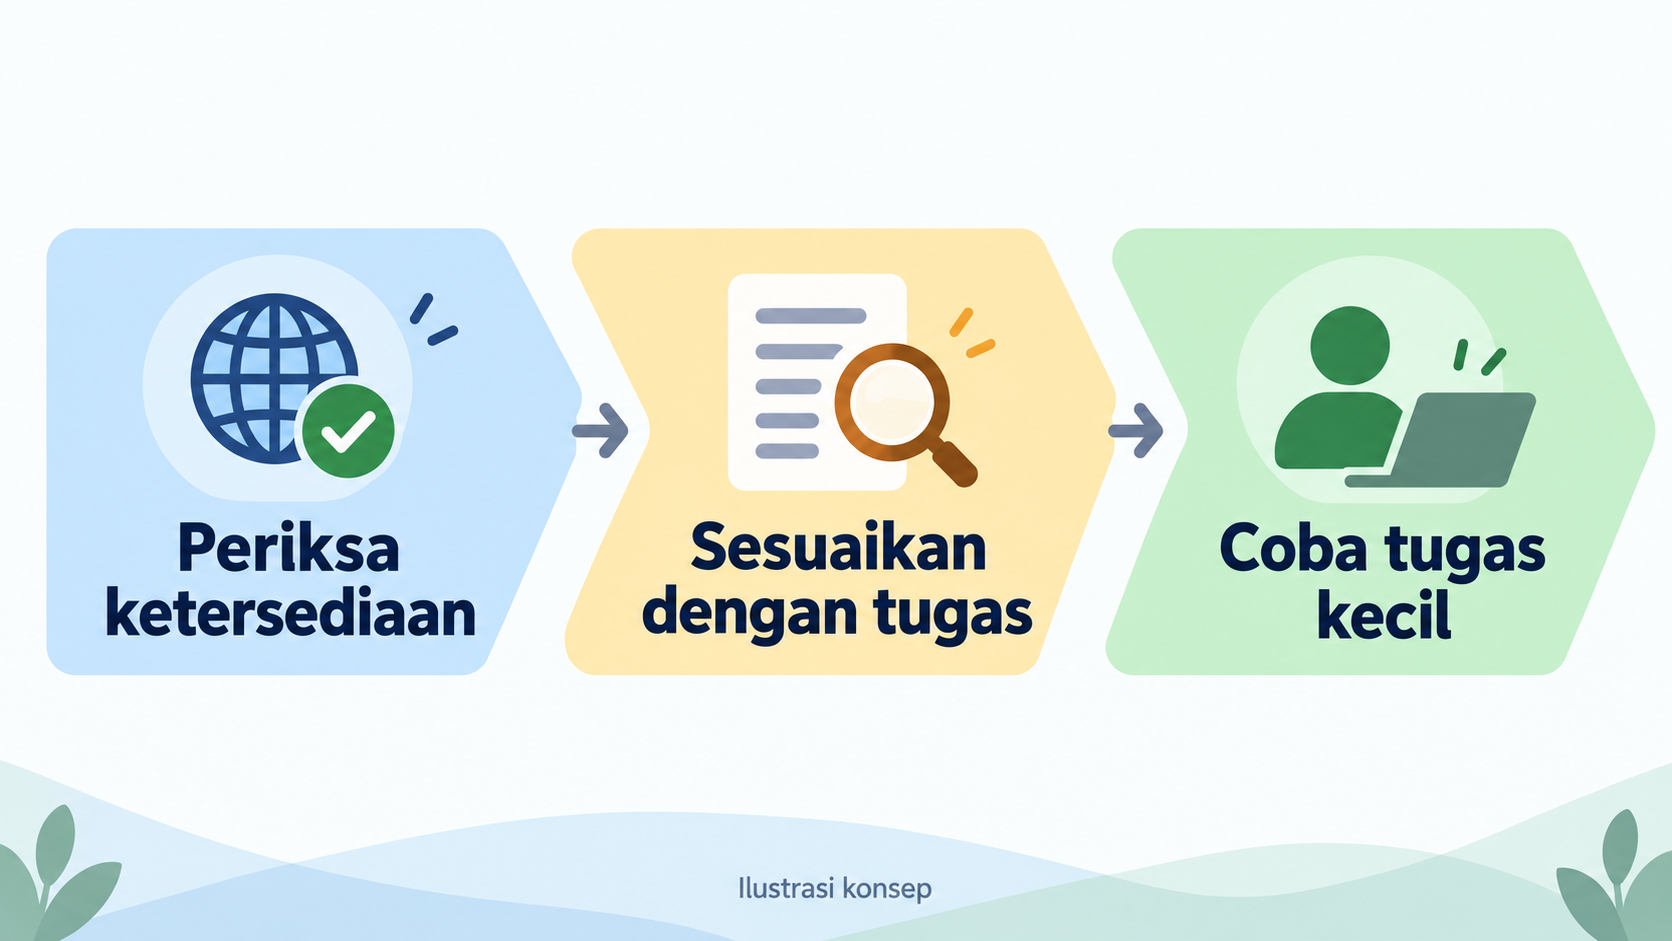
Gambar: Diagram jalur pemilihan yang dihasilkan AI, pertama lihat ketersediaan akun dan wilayah, lalu lihat kebutuhan tugas, terakhir verifikasi dengan tugas kecil Anda sendiri. "Artikel ini tidak melakukan pengujian perbandingan apa pun" dalam gambar berarti kami tidak menjalankan sendiri pengujian dengan kondisi yang sama; tabel skor di atas adalah transkripsi data yang diumumkan Google. Lihat gambar ukuran asli (1672×941).

Jika tugas Anda adalah membagi peran antara dua asisten pemrograman, lihat tutorial kolaborasi Claude Code dan Codex; jika ingin memberikan pertanyaan spesifik ke halaman ChatGPT Pro yang sudah login, lihat tutorial Codex dan Claude Code meminta bantuan ke ChatGPT Pro. Kedua artikel ini membahas operasi alur kerja, bukan berarti Gemini 4 Argon sudah terhubung ke PandaNpc.
FAQ
Gemini 4 Argon sudah dirilis resmi, kenapa saya tidak menemukannya?
"Rilis" berarti Google mengumumkan model dan membukanya untuk cakupan terbatas; pengumuman resmi belum memberikan tanggal pembukaan seragam untuk semua developer dan konsumen umum. Periksa dulu daftar model resmi pada produk dan akun Gemini yang Anda gunakan, jangan menganggap "Gemini 4 Pro" yang beredar sebagai pintu masuk yang tersedia untuk Argon.
Apakah Astra adalah Project Astra milik Google?
Bukan. GPT-6 Astra dalam artikel ini adalah model OpenAI; Google Project Astra adalah proyek riset lain, tidak bisa dicampur ke dalam tabel harga tiga model.
Jika sudah berlangganan Claude Pro, apakah bisa menggunakan Fable 5.1 dalam kuota paket?
Tidak selalu. Penjelasan paket yang berlaku dari Anthropic menyatakan, Pro yang menggunakan Fable 5.1 memerlukan usage credits, sedangkan sebagian paket seperti Max dapat menggunakannya dalam kuota mingguan yang ditentukan. Sebelum membayar, lihat dulu halaman "penggunaan/kredit" Anda.
Bisakah langsung menentukan siapa yang paling hemat berdasarkan harga di atas?
Tidak bisa. Tabel API hanya membandingkan harga tertera; saat menyelesaikan tugas, hasil juga dipengaruhi panjang input, apakah konten berulang terkena cache, biaya alat, jumlah putaran eksekusi, dan pengerjaan ulang. Terutama Argon belum dibuka secara luas, sehingga kami tidak bisa memberikan "biaya per tugas sukses" versi kami sendiri.
Panduan terkait

GPT-6 Sol vs Claude Opus 5.5: Harga, Skor Benchmark, dan Tugas Coding—Bagaimana Memilih?
Untuk tugas pemrograman API umum, coba GPT-6 Sol terlebih dahulu; untuk tugas kompleks, bandingkan dengan Claude Opus 5.5, lalu jadikan GPT-6 Astra dan Claude Fable 5.1 sebagai opsi tingkat kesulitan tinggi. Artikel ini memverifikasi spesifikasi resmi keempat model, harga cache dan Batch, skor benchmark pihak ketiga dengan metode yang sama, serta menyediakan lima skenario biaya yang dapat dihitung ulang.
Baca artikel →
Claude Code vs Codex: Fitur, Kontrol Jarak Jauh, Izin, dan Cara Memilih Skenario Penggunaan (2026)
Kesimpulan: Claude Code untuk terminal mendalam, Hooks, dan ekosistem Claude; Codex untuk ChatGPT, tugas cloud, dan multi-Agent; PandaNpc untuk mengontrol keduanya dari Windows, macOS, Linux, dan ponsel.
Baca artikel →
Cara memakai ChatGPT Pro bersama Codex dan Claude Code di PandaNpc
Dalam percakapan Codex atau Claude Code di PandaNpc, sebuah pertanyaan spesifik dapat diserahkan ke halaman web ChatGPT Pro yang sudah login, dan jawabannya akan kembali ke percakapan asal.
Baca artikel →