
Gemini 4 Argon, GPT-6 Astra of Claude Fable 5.1: welke kiezen? Vergelijking van beschikbaarheid, prijs en toepassingsscenario's
Gemini 4 Argon is beperkt beschikbaar; kies nu GPT-6 Astra of Claude Fable 5.1 per taak en plan; API-prijzen los van abonnementen volgens officiële data, geen test onder gelijke condities.
Broncontrole: 30 september 2026 (UTC). PandaNpc biedt AI Agent-diensten aan, wat relevant is voor modelselectie. Dit artikel bundelt openbaar beschikbare informatie van drie bedrijven en geeft advies over keuzes per taak; we hebben nog geen proeftoegang tot Gemini 4 Argon verkregen en hebben geen test onder gelijke omstandigheden van de drie modellen uitgevoerd. "Geschikt" hieronder verwijst naar officiële positionering en huidige beschikbaarheid, niet naar dat wij hebben gemeten wie sterker is.
Eerst de conclusie: als je het vandaag wilt gebruiken, kies dan eerst tussen GPT-6 Astra en Claude Fable 5.1 op basis van taak en bestaand abonnement; Gemini 4 Argon is momenteel alleen toegankelijk voor een kleine groep vertrouwde testers, en gewone gebruikers kunnen het nog niet beschouwen als een altijd beschikbare derde optie. Voor taken die meerdere softwareprogramma's bestrijken, complexe materiaalorganisatie of moeilijk programmeren kun je Astra eerst proberen; voor langdurig programmeren, herhaaldelijk lezen van grote projecten of complexe documenten kun je Fable 5.1 eerst proberen. Zodra Argon breed beschikbaar is, vergelijk dan met dezelfde taken de werkelijke voltooiingskwaliteit en totale kosten.
Bekijk de oorspronkelijke PNG-omslag (1671×941)
Kijk eerst of je ze kunt gebruiken: de drie modellen starten niet vanaf dezelfde lijn
| Model | Officiële releasedatum | Wie kan het per 30 september gebruiken | Wat betekent dit voor gewone lezers |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Eerst toegankelijk voor vertrouwde cyberverdedigers en testers van Google's Fairwind-project; brede beschikbaarheid voor ontwikkelaars, bedrijven en consumenten volgt in latere fasen | Als je vandaag "uitgebracht" ziet, betekent dat niet dat jouw Gemini-account of API Argon al kan kiezen |
| GPT-6 Astra | 2026-09-03 | Gefaseerd uitgerold naar ChatGPT-betaalgebruikers en API-gebruikers; de exacte beschikbare limiet hangt af van abonnement en account | Je kunt je modellenlijst en gebruikslimiet controleren en meteen met echte taken beginnen |
| Claude Fable 5.1 | 2026-09-01 | Beschikbaar in betaalde Claude-abonnementen en via de Claude API, maar abonnementen zoals Pro kunnen extra usage credits vereisen | Controleer eerst de Fable-gebruiksregels van je abonnement en beslis dan of je upgrade of apart betaalt |
Google's aankondiging van Gemini 4 Argon vermeldt dat het momenteel om een beperkte uitrol gaat, met plannen om in de toekomst uit te breiden vanaf betalende API-gebruikers en Google AI Ultra-abonnees; er is geen definitieve datum bekendgemaakt waarop gewone gebruikers het kunnen gebruiken. OpenAI's Astra-aankondiging en Anthropic's uitleg over Fable 5.1 beschrijven respectievelijk de huidige beschikbaarheid. Astra hier is een OpenAI-model, niet Google's Project Astra-onderzoeksproject.
Parametervergelijking: haal "hoeveel het kan lezen" en "hoeveel het kan schrijven" niet door elkaar
Invoercontextvenster is hoeveel materiaal je in één keer aan het model kunt geven; maximale uitvoer is hoeveel inhoud het in één keer maximaal kan genereren. Deze twee getallen zijn niet uitwisselbaar, en je kunt de antwoordkwaliteit niet alleen op basis van getallen beoordelen. Hieronder staat informatie die op 30 september 2026 is gecontroleerd voor specifieke modelversies, niet de algemene specificaties van de hele Gemini-, GPT- of Claude-familie.
| Parameter | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Invoercontextvenster | Officiële bovengrens niet bekendgemaakt | 1.050.000 token | 1.000.000 token |
| Maximale uitvoer per keer | Google's aankondiging noemt 1.000.000 token; gewone gebruikers kunnen dit nog niet verifiëren | 128.000 token | 128.000 token |
| Invoer die aan het model kan worden gegeven | De aankondiging toont multimodale en lange-videobegrip, maar de volledige lijst met API-invoertypen is niet bekendgemaakt | Tekst, afbeeldingen | Tekst, afbeeldingen |
| Huidige officiële toegang | Fairwind-vertrouwde testers; tijdstip van brede beschikbaarheid niet bekendgemaakt | ChatGPT-betaalaccounts volgens uitrolsnelheid en abonnement, OpenAI API | Betaalde Claude-producten en Claude API; abonnementen zoals Pro hebben extra creditvoorwaarden |
Bronnen: Google's aankondiging van Gemini 4 Argon, OpenAI's modelpagina voor GPT-6 Astra, Anthropic's modelpagina voor Claude Fable 5.1 en Anthropic's abonnementsuitleg. De "1 miljoen" in Google's aankondiging verwijst naar de uitvoerbovengrens en mag niet worden gezien als dat Argon een "1 miljoen invoercontextvenster" heeft aangekondigd. De volledige openbare modelkaart van Argon en tests door gewone gebruikers moeten nog verschijnen; "niet bekendgemaakt" in de tabel betekent niet "deze capaciteit bestaat niet".
De bovenstaande tabel vergelijkt openbare specificaties, niet wie prestaties wint: meer inhoud kunnen bevatten betekent niet noodzakelijk nauwkeuriger antwoorden. De onderstaande tabel bevat de benchmarkprestaties.
Vergelijking van officiële benchmarks: kijk naar specifieke taken, niet naar een "algemene kampioen"
Google DeepMind heeft op de officiële modelpagina van Gemini 4 Argon een benchmarktabel met vier modellen gepubliceerd. Hier nemen we alleen de drie kolommen op die in dit artikel worden besproken: Argon, GPT-6 Astra en Claude Fable 5.1; de originele tabel bevat ook Claude Opus 5.5. De onderstaande scores komen van de Google-website zoals die daadwerkelijk is gelezen op 30 september 2026 om 23:42 UTC, verzameld door Google, niet een test onder gelijke omstandigheden door PandaNpc. Behalve bij regels die F1, slagingspercentage of deelscores vermelden, gebruiken de waarden de percentages uit de originele tabel; per regel wordt alleen onder deze drie modellen de hoogste waarde vetgedrukt. "—" betekent dat de originele tabel geen vergelijkbare score heeft, niet 0 punten.
| Capaciteitsgroep | Benchmark (testitem) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Kenniswerk | Vals Index | 68,9% | 63,1% | 65,8% |
| Kenniswerk | AutomationBench | 51,3% | 41,4% | 31,4% |
| Kenniswerk | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% |
| Kenniswerk | Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 6,7% |
| Automatisch programmeren | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% |
| Automatisch programmeren | FrontierSWE v2 | 55,0% | 65,5% | 56,3% |
| Automatisch programmeren | Vibe Code Bench | 91,9% | 89,6% | 90,3% |
| Automatisch programmeren | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% |
| Machine learning-engineering | PostTrainBench | 45,3% | 44,3% | 40,2% |
| Wetenschap en wiskunde | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% |
| Wetenschap en wiskunde | LABBench 2 | 88,8% | 85,4% | 68,6% |
| Wetenschap en wiskunde | RiemannBench | 76,0% | 72,0% | 65,6% |
| Lange tekst | GraphWalks (≤128K, BFS F1) | 99,7% | 98,7% | 91,4% |
| Lange tekst | GraphWalks (256K–1M, BFS F1) | 84,2% | 71,8% | 65,0% |
| Computerbediening | Agent's Last Exam (slagingspercentage) | 39,5% | 34,2% | — |
| Computerbediening | OSWorld-2.0 (offline subset, deelscore) | 69,2% | 72,6% | — |
| Beeld- en tekstbegrip | Chartography | 71,6% | 71,0% | 46,2% |
| Videobegrip | LVBench | 91,7% | 87,5% | 79,7% |
| Defensieve beveiliging | CWE-bench v1 | 68,0% | 68,0% | 58,0% |
Hoe gebruik je deze tabel? Doe je kenniswerk, kijk dan eerst naar Vals Index en Finance Agent; voor code schrijven kun je tegelijk naar DeepSWE, FrontierSWE en Terminal-bench kijken, kies niet slechts één regel: Argon leidt bij DeepSWE, maar Astra scoort hoger bij FrontierSWE en Terminal-bench. Let extra op bij computerbediening: Fable's twee regels in deze Google-tabel zijn afwezig, en daarom kun je niet zeggen dat het geen computer kan bedienen. CWE-bench laat zien dat Argon en Astra onder de drie gelijk staan; dit is ook geen garantie voor echt beveiligingswerk.
Testopzet: Google's uitleg van de evaluatiemethode vermeldt dat Argon-scores doorgaans afkomstig zijn van één poging op het hoogste denkniveau; gegevens van andere modellen komen vaak van leveranciers zelf of openbare ranglijsten, en kunnen ook hun eigen hoogste of beschikbare denkniveau gebruiken. Sommige projecten zijn door Google zelf uitgevoerd, andere komen van derden, en de toolomgeving en samplingmethoden zijn niet overal hetzelfde. De Argon-scores voor DeepSWE en Terminal-bench zijn bijvoorbeeld door Google zelf getest, terwijl voor andere modellen openbare scores zijn gebruikt; bij LVBench is het aantal geëxtraheerde videoframes per model verschillend. De GraphWalks-regel gebruikt BFS F1, en de OSWorld-regel vertegenwoordigt alleen de "deelscore" van de offline subset. Je kunt niet over regels heen middelen en op basis daarvan niet beweren dat iets onder uniforme testomstandigheden algeheel eerste is. De resultatenpagina van deze methode-PDF vermeldt elders "per oktober 2026", wat niet overeenkomt met het moment waarop wij de tabel in dit artikel op 30 september hebben gelezen; de exacte afrondingsdatum van de evaluatie kon niet worden bevestigd. Dit artikel neemt alleen de scores over die toen op de officiële website zichtbaar waren, concludeert niet wanneer de evaluatie is afgerond en beweert niet dat dit door ons gereproduceerde resultaten zijn.
Hoe vergelijk je prijzen: maandkosten en API-kosten apart houden
Als je het alleen in een chatproduct of programmeertool wilt gebruiken, kijk dan eerst naar abonnement en gebruikslimieten. In de openbare Amerikaanse prijzen kost ChatGPT Plus $20/maand, en Pro is er in niveaus van $100, $200, $500/maand enz.; het exacte Astra-verbruik varieert per abonnement en taak. OpenAI's uitleg over ChatGPT Work/Codex-prijzen en -verbruik waarschuwt duidelijk: de prijsopgave per miljoen token voor de API kan niet worden gebruikt om te berekenen hoeveel taken binnen een abonnement kunnen worden voltooid.
Claude Pro kost in de VS $20 per maand, en Max begint bij $100/maand (Claude's officiële prijstabel). Maar dat "Pro Fable 5.1 kan selecteren" betekent niet dat Fable binnen de normale Pro-limiet valt: Anthropic's Fable-abonnementsregels leggen uit dat Pro en standaard Team-seats extra usage credits nodig hebben om Fable 5.1 te gebruiken; Max en hogere seats kunnen het binnen een deel van de wekelijkse limiet gebruiken. Google heeft nog geen werkelijke abonnementsprijs of releasedatum gegeven voor gewoon gebruik van Argon, en de huidige maandprijs van Google AI Ultra mag niet worden gezien als een prijsopgave om "vandaag Argon te kopen".
Als je via API naar verbruik betaalt, is het volgende de standaard tekstprijsopgave die in dezelfde eenheid kan worden gelezen. Invoer verwijst naar de inhoud die je het model laat lezen, uitvoer naar het antwoord dat het genereert. De eenheid is overal de dollarpijs per 1 miljoen token (token is de eenheid waarin tekst en dergelijke bij facturering wordt opgesplitst); Argon in de tabel is de door Google aangekondigde toekomstige lanceringsprijs, niet een werkelijke factuur die wij vandaag al hebben betaald.
| Model | Normale invoer | Normale uitvoer | Cache-lezing van herhaalde inhoud | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Gepland bij lancering $2; na de actieperiode $4 | Gepland bij lancering $10; na de actieperiode $20 | Google zegt dat cache-invoer bij de lancering 95% korting krijgt ten opzichte van de normale invoerprijs; exacte lanceringsregels moeten nog worden gecontroleerd | Nog niet breed beschikbaar |
| GPT-6 Astra | $10 | $50 | $1 | Huidige standaard API-prijs |
| Claude Fable 5.1 | $10 | $50 | $0,25 | Huidige standaard API-prijs |
Gegevens komen van Google's Argon-lanceringsaankondiging, OpenAI's prijspagina voor het Astra-model en Anthropic's modelpagina voor Fable 5.1. Prijzen zijn exclusief extra tools, regio, snelheidsniveaus of platformverschillen; bij Astra worden bij een enkele invoer van meer dan 272K token de invoer- en cacheprijs voor het hele verzoek met factor 2 gerekend, en de uitvoer met factor 1,5. De cacheprijs geldt alleen voor inhoud die daadwerkelijk in de cache zit; je kunt niet een hele taak tegen de cacheprijs ramen. Zelfs als Argon's geplande stukprijs lager is dan die van de andere twee, kun je zonder gegevens over succespercentage en verbruik bij dezelfde taak niet beweren dat het een taak het goedkoopst voltooit.
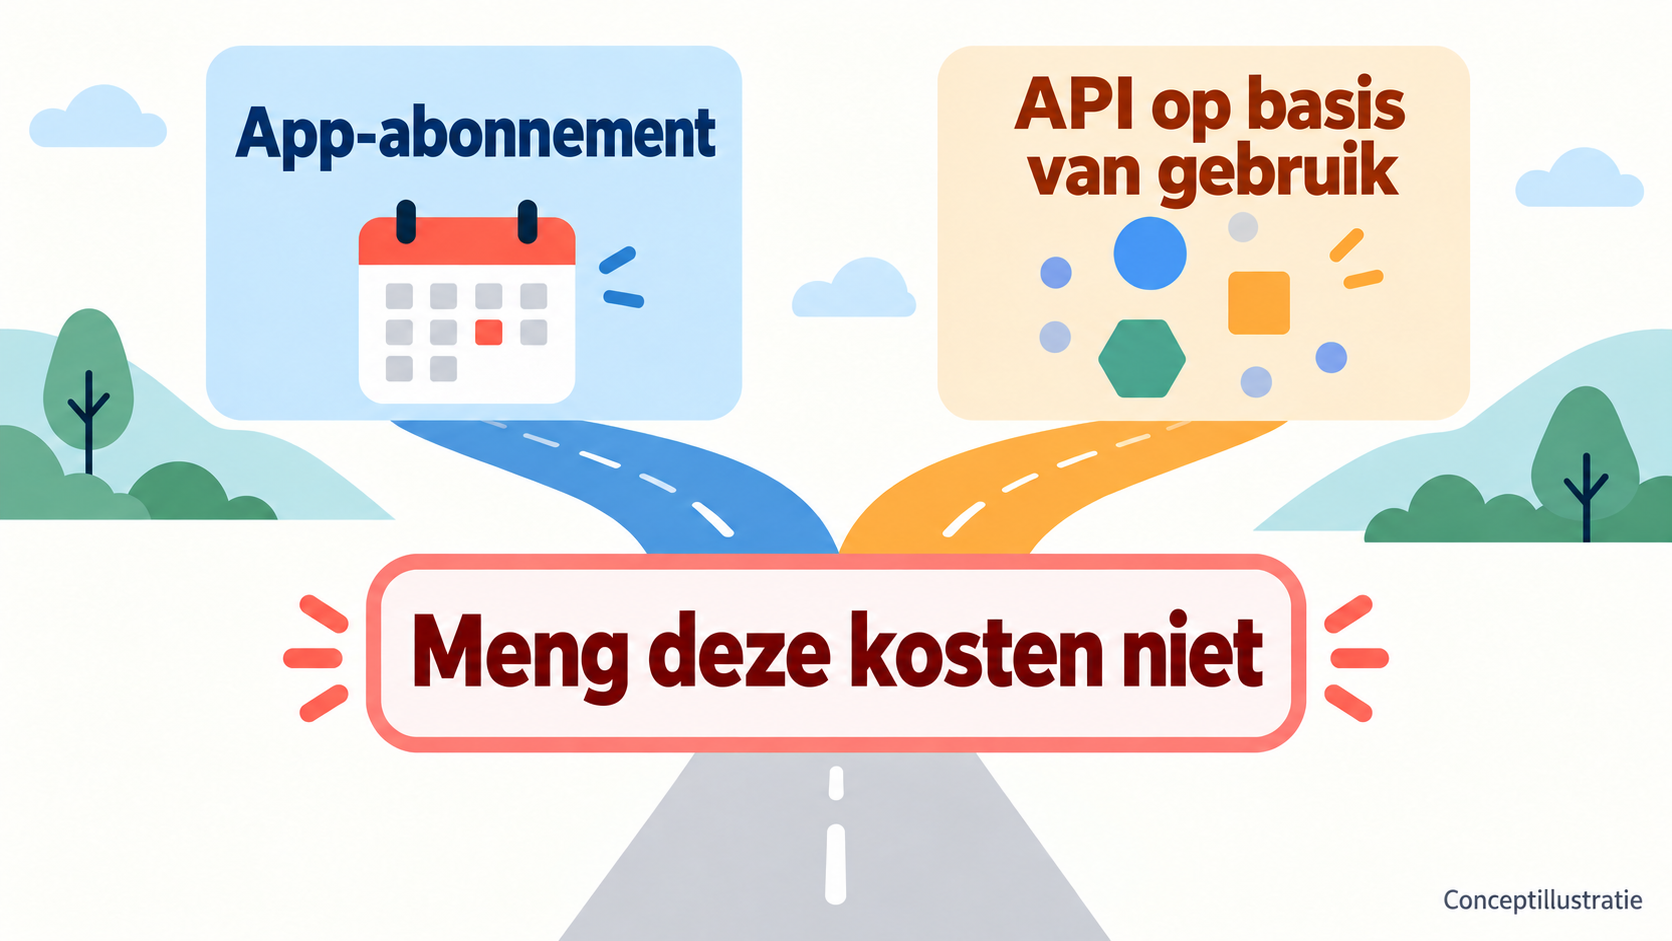
Afbeelding: door AI gegenereerde illustratie van factureringswijzen, geen productfactuur; maandabonnementskosten mogen niet met API-stukprijzen worden vermengd. Bekijk de afbeelding op volledige grootte (1672×941).

Hoe kies je per taak? Gebruik eerst de modellen die je al beschikbaar hebt
Als een taak meerdere softwareprogramma's bestrijkt, of als je moet browsen, interfaces moet bedienen en complexe beoordelingen moet maken: probeer eerst GPT-6 Astra. OpenAI noemt computerbediening, browsen, moeilijk programmeren en professionele documenten als kerncompetenties. Als je al een geschikt betaald ChatGPT-account of API-toegang hebt, kun je vandaag een echte taak aan het model geven en kijken of het resultaat aan de eisen voldoet. OpenAI's modeluitleg.
Als de taak urenlang programmeren, code review of groot documentwerk is: probeer eerst Claude Fable 5.1. Anthropic positioneert het voor langdurige autonome taken, complex programmeren en onderzoek. Wie al een Claude Code-workflow heeft, kan eerst de vertrouwde tools blijven gebruiken, maar moet eerst controleren of het abonnement apart usage credits aftrekt; vergelijk daarna, als je dagelijks veel van dit soort taken uitvoert, de werkelijke kosten van Max en API. Anthropic's modeluitleg.
Wil je Gemini 4 Argon proberen: controleer eerst of je officiële toegang hebt. De door Google aangekondigde richtingen omvatten complex programmeren, enterprise-kenniswerk en defensieve beveiligingstaken, en er zijn geplande prijzen genoemd; deze zijn het volgen waard, maar kunnen de praktijkervaring van gewone gebruikers nog niet vervangen. Zonder toegang is het niet aan te raden om een lopende workflow te veranderen vanwege Argon's "verwacht lagere prijs". Google's officiële aankondiging.
Deze adviezen betekenen niet dat "een model dat goed is in één soort taak alleen dat soort taken kan doen". Als alle drie in de toekomst beschikbaar zijn, is de veiligste manier om te kiezen: neem dezelfde echte taak, geef dezelfde materialen en acceptatiecriteria, en noteer afzonderlijk of het is voltooid, handmatig herwerk, tijdsduur en totale kosten. Een mooie eenmalige demo of de aparte benchmarks van verschillende leveranciers bewijzen niet direct dat jouw taak ook hetzelfde resultaat zal opleveren.
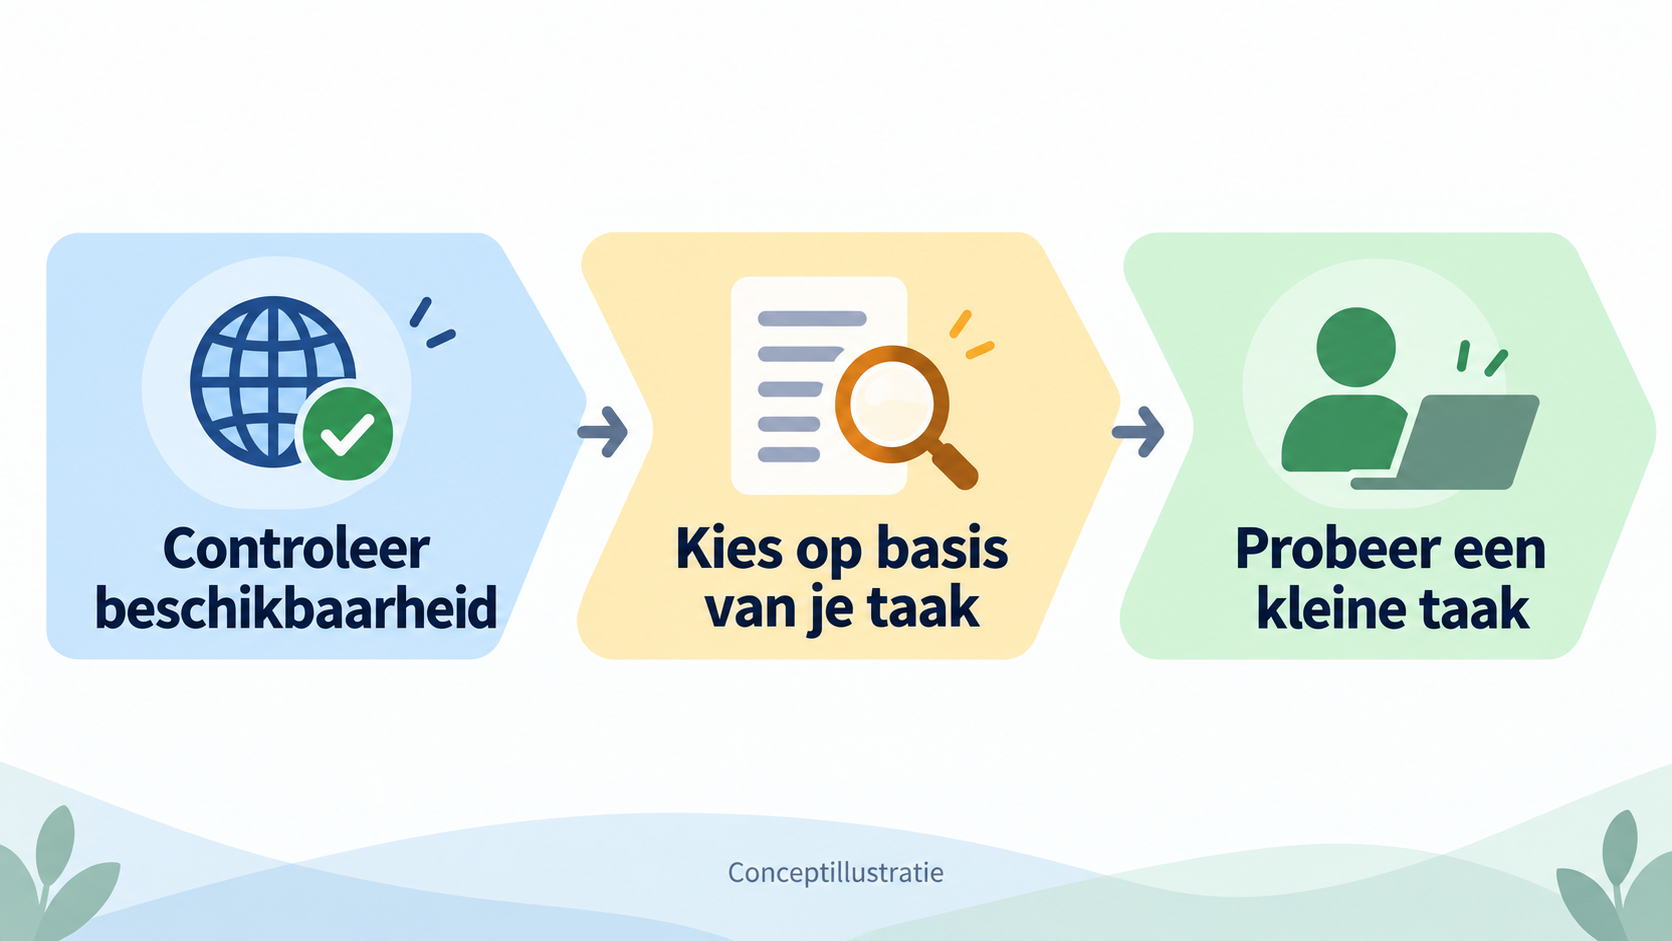
Afbeelding: door AI gegenereerde illustratie van het keuzepad: kijk eerst naar beschikbaarheid van account en regio, dan naar taakbehoeften, en valideer ten slotte met je eigen kleine taak. "Dit artikel voert geen enkele vergelijkende test uit" in de afbeelding betekent dat wij zelf geen tests onder gelijke omstandigheden hebben uitgevoerd; de benchmarktabel hierboven is een transcriptie van door Google gepubliceerde gegevens. Bekijk de afbeelding op volledige grootte (1672×941).

Als je taak is om twee programmeerassistenten te laten samenwerken, bekijk dan de samenwerkingstutorial voor Claude Code en Codex; als je een specifieke vraag wilt doorsturen naar een ingelogde ChatGPT Pro-pagina, bekijk dan de tutorial over Codex en Claude Code die ChatGPT Pro om hulp vragen. Deze twee artikelen behandelen workflowhandelingen en betekenen niet dat Gemini 4 Argon is geïntegreerd in PandaNpc.
FAQ
Gemini 4 Argon is officieel uitgebracht, waarom kan ik het niet vinden?
"Uitgebracht" betekent dat Google het model heeft aangekondigd en voor een beperkte groep heeft opengesteld; de officiële aankondiging heeft nog geen uniforme releasedatum gegeven voor alle ontwikkelaars en gewone consumenten. Controleer eerst de officiële modellenlijst van het Gemini-product en account dat je gebruikt, en zie de geruchten over "Gemini 4 Pro" niet als een beschikbare toegangspoort voor Argon.
Is Astra hetzelfde als Google's Project Astra?
Nee. GPT-6 Astra in dit artikel is een OpenAI-model; Google Project Astra is een ander onderzoeksproject en mag niet in de driemodel-prijstabel worden vermengd.
Als ik Claude Pro heb, kan ik Fable 5.1 dan binnen de abonnementslimiet gebruiken?
Niet per se. Anthropic's huidige abonnementsuitleg zegt dat Pro usage credits nodig heeft om Fable 5.1 te gebruiken, terwijl sommige abonnementen zoals Max het binnen een beperkte wekelijkse limiet kunnen gebruiken. Kijk vóór betaling naar je pagina "Gebruik/credits".
Kun je op basis van de bovenstaande prijzen direct bepalen wat het voordeligst is?
Nee. De API-tabel vergelijkt alleen lijstprijzen; bij het voltooien van een taak spelen ook invoerlengte, of herhaalde inhoud de cache raakt, toolkosten, het aantal runs en herwerk een rol. Vooral Argon is nog niet breed beschikbaar, dus we kunnen onze eigen "kosten per succesvolle taak" niet geven.
Gerelateerde gidsen

GPT-6 Sol vs Claude Opus 5.5: prijs, benchmarks en programmeertaken — hoe kies je?
Probeer voor algemene API-programmeertaken eerst GPT-6 Sol; vergelijk voor complexe taken Claude Opus 5.5 en gebruik GPT-6 Astra en Claude Fable 5.1 als opties voor hoge moeilijkheidsgraad. Dit artikel controleert de officiële specificaties van de vier modellen, cache- en Batch-prijzen en benchmarks van derden volgens dezelfde meetmethode, en biedt vijf narekenbare kostenscenario's.
Artikel lezen →
Claude Code vs Codex: functionaliteiten, externe bediening, machtigingen en gebruiksscenario's - wat kies je (2026)
Kort gezegd: Claude Code voor diepgaand terminalwerk, Hooks en het Claude-ecosysteem; Codex voor ChatGPT, cloudtaken en multi-Agent; PandaNpc om beide op afstand te bedienen via Windows, macOS, Linux en mobiel.
Artikel lezen →
ChatGPT Pro gebruiken met Codex en Claude Code in PandaNpc
In een Codex- of Claude Code-gesprek binnen PandaNpc kun je een specifieke vraag aan de ingelogde ChatGPT Pro-webpagina voorleggen, waarna het antwoord terugkomt in het oorspronkelijke gesprek.
Artikel lezen →