
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1: chọn thế nào? So sánh khả dụng, giá và trường hợp sử dụng
Gemini 4 Argon mở hạn chế; GPT-6 Astra, Claude Fable 5.1 sẵn có, chọn theo tác vụ/gói; giá API tách thuê bao; theo dữ liệu chính thức, không phải test cùng điều kiện, không đảm bảo mọi nơi.
Kiểm tra thông tin: ngày 30 tháng 9 năm 2026 (UTC). PandaNpc cung cấp dịch vụ AI Agent, liên quan đến việc lựa chọn mô hình. Bài viết này tổng hợp thông tin công khai của ba công ty và đưa ra gợi ý lựa chọn theo tác vụ; chúng tôi chưa có quyền dùng thử Gemini 4 Argon, chưa thực hiện đo kiểm ba mô hình trong cùng điều kiện. “Phù hợp” dưới đây chỉ vị thế chính thức và khả dụng hiện tại, không có nghĩa chúng tôi đã đo được mô hình nào mạnh hơn.
Kết luận trước: nếu cần dùng ngay hôm nay, hãy chọn giữa GPT-6 Astra và Claude Fable 5.1 theo tác vụ và gói hiện có; Gemini 4 Argon hiện chỉ mở cho một số ít người kiểm thử đáng tin cậy, người dùng phổ thông chưa thể coi nó là lựa chọn thứ ba sẵn có bất cứ lúc nào. Với thao tác liên phần mềm, tổng hợp tài liệu phức tạp hoặc lập trình khó, có thể thử Astra trước; với lập trình dài hạn, đọc đi đọc lại các dự án lớn hoặc tài liệu phức tạp, có thể thử Fable 5.1 trước. Khi Argon mở rộng phổ biến, hãy dùng cùng tác vụ để so chất lượng hoàn thành thực tế và tổng chi phí.
Xem ảnh bìa kích thước gốc PNG (1672×941)
Trước tiên xem có dùng được không: ba mô hình không cùng vạch xuất phát
| Mô hình | Ngày phát hành chính thức | Tính đến 30/9 ai dùng được | Điều này có nghĩa gì với người đọc phổ thông |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Trước tiên mở cho những người phòng thủ mạng đáng tin cậy và người kiểm thử của dự án Google Fairwind; việc mở rộng cho nhà phát triển, doanh nghiệp và người tiêu dùng còn chờ giai đoạn sau | Hôm nay thấy “đã phát hành” không có nghĩa tài khoản Gemini hoặc API của bạn đã chọn được Argon |
| GPT-6 Astra | 2026-09-03 | Đã ra mắt theo giai đoạn cho người dùng trả phí ChatGPT và người dùng API, hạn mức cụ thể tùy gói và tài khoản | Có thể kiểm tra danh sách mô hình và hạn mức sử dụng của mình, bắt đầu tác vụ thực tế ngay |
| Claude Fable 5.1 | 2026-09-01 | Có sẵn trong gói trả phí Claude và Claude API, nhưng các gói như Pro có thể cần thêm credit sử dụng | Kiểm tra quy tắc dùng Fable của gói trước, rồi quyết định có nâng cấp hay trả thêm |
Thông báo Gemini 4 Argon của Google ghi rõ hiện đang mở ở phạm vi nhỏ, kế hoạch tương lai sẽ mở rộng bắt đầu từ người dùng API trả phí và người đăng ký Google AI Ultra; chưa công bố ngày chắc chắn để người dùng phổ thông sử dụng.Thông báo Astra của OpenAI và giải thích Fable 5.1 của Anthropic lần lượt nêu phạm vi mở hiện có. Astra ở đây là mô hình của OpenAI, không phải dự án nghiên cứu Project Astra của Google.
Đối chiếu thông số: đừng nhầm “đọc được bao nhiêu” với “viết được bao nhiêu”
Cửa sổ ngữ cảnh đầu vào là lượng tài liệu có thể giao cho mô hình trong một lần; đầu ra tối đa là lượng nội dung tối đa nó có thể tạo trong một lần. Hai con số này không thể thay thế nhau, cũng không thể chỉ dựa vào con số để đánh giá chất lượng câu trả lời. Dưới đây đều là thông tin về model cụ thể được kiểm chứng ngày 30 tháng 9 năm 2026, không phải thông số chung cho toàn bộ dòng Gemini, GPT hay Claude.
| Thông số | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Cửa sổ ngữ cảnh đầu vào | Chưa công bố giới hạn chính thức | 1,050,000 token | 1,000,000 token |
| Đầu ra tối đa một lần | Thông báo Google nói 1,000,000 token; người dùng phổ thông chưa thể xác minh | 128,000 token | 128,000 token |
| Đầu vào có thể giao cho mô hình | Thông báo giới thiệu hiểu đa phương thức và video dài, nhưng danh sách đầy đủ loại đầu vào API chưa công bố | Văn bản, hình ảnh | Văn bản, hình ảnh |
| Cổng chính thức hiện tại | Người kiểm thử đáng tin cậy Fairwind; chưa công bố thời gian mở rộng | Tài khoản ChatGPT trả phí theo tiến độ ra mắt và gói, OpenAI API | Sản phẩm Claude trả phí và Claude API; các gói như Pro có điều kiện credit bổ sung |
Nguồn: Thông báo Gemini 4 Argon của Google, trang model GPT-6 Astra của OpenAI, trang model Claude Fable 5.1 của Anthropic và giải thích gói của Anthropic. “1 triệu” trong thông báo Google nói về giới hạn đầu ra, không thể coi là Argon đã công bố “cửa sổ ngữ cảnh đầu vào 1 triệu”. Thẻ model công khai đầy đủ và đo kiểm thực tế của người dùng phổ thông cho Argon vẫn chờ phát hành; “chưa công bố” trong bảng không phải “không có khả năng này”.
Bảng trên so sánh thông số công khai, không phải thắng thua về hiệu năng: chứa được càng nhiều nội dung chưa chắc trả lời càng chính xác. Bảng dưới mới là điểm chuẩn hiệu năng.
So sánh điểm benchmark chính thức: xem tác vụ cụ thể, đừng tính “nhà vô địch tổng”
Google DeepMind đã công bố bảng điểm bốn mô hình trên trang model chính thức Gemini 4 Argon. Ở đây chỉ trích ba cột Argon, GPT-6 Astra, Claude Fable 5.1 được bàn trong bài; bảng gốc còn có Claude Opus 5.5. Các điểm dưới đây đến từ trang web Google chính thức được đọc thực tế lúc 23:42 UTC ngày 30 tháng 9 năm 2026, do Google tổng hợp, không phải đo kiểm cùng điều kiện của PandaNpc. Ngoại trừ các dòng ghi chú F1, tỷ lệ vượt qua hoặc điểm một phần, giá trị giữ nguyên phần trăm của bảng gốc; mỗi dòng chỉ in đậm giá trị cao hơn trong ba mô hình này. “—” nghĩa là bảng gốc không có điểm so sánh được, không phải 0 điểm.
| Nhóm năng lực | Benchmark (hạng mục kiểm tra) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Công việc tri thức | Vals Index | 68.9% | 63.1% | 65.8% |
| Công việc tri thức | AutomationBench | 51.3% | 41.4% | 31.4% |
| Công việc tri thức | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| Công việc tri thức | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| Lập trình tự động | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| Lập trình tự động | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| Lập trình tự động | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| Lập trình tự động | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| Kỹ thuật học máy | PostTrainBench | 45.3% | 44.3% | 40.2% |
| Khoa học và toán | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| Khoa học và toán | LABBench 2 | 88.8% | 85.4% | 68.6% |
| Khoa học và toán | RiemannBench | 76.0% | 72.0% | 65.6% |
| Văn bản dài | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 91.4% |
| Văn bản dài | GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 65.0% |
| Thao tác máy tính | Agent's Last Exam (tỷ lệ vượt qua) | 39.5% | 34.2% | — |
| Thao tác máy tính | OSWorld-2.0 (tập con ngoại tuyến, điểm một phần) | 69.2% | 72.6% | — |
| Hiểu hình ảnh và văn bản | Chartography | 71.6% | 71.0% | 46.2% |
| Hiểu video | LVBench | 91.7% | 87.5% | 79.7% |
| An ninh phòng thủ | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
Dùng bảng này thế nào? Nếu bạn làm công việc tri thức, có thể xem Vals Index, Finance Agent trước; viết mã có thể xem đồng thời DeepSWE, FrontierSWE và Terminal-bench, đừng chỉ chọn một dòng: Argon dẫn đầu ở DeepSWE, nhưng Astra cao hơn ở FrontierSWE và Terminal-bench. Làm thao tác máy tính cần đặc biệt lưu ý, hai dòng của Fable trong bảng Google này là thiếu, không thể vì thế nói nó không biết thao tác máy tính. CWE-bench cho thấy Argon và Astra ngang nhau trong ba mô hình; đây cũng không phải bảo đảm cho công việc an ninh thực tế.
Tiêu chí kiểm thử: giải thích phương pháp đánh giá của Google ghi rõ, điểm của Argon thường là một lần thử, mức suy luận cao nhất; dữ liệu của các mô hình khác phần lớn đến từ tự báo cáo của nhà cung cấp hoặc bảng xếp hạng công khai, cũng có thể dùng mức suy luận cao nhất hoặc mức có thể đạt được của từng bên. Một số hạng mục do Google tự chạy, một số đến từ bên thứ ba, môi trường công cụ và phương pháp lấy mẫu không giống nhau ở mọi nơi. Ví dụ điểm Argon ở DeepSWE và Terminal-bench là Google tự đo, các mô hình khác dùng điểm công khai; LVBench lấy số khung hình video khác nhau cho các mô hình. Dòng GraphWalks dùng BFS F1, dòng OSWorld chỉ đại diện “điểm một phần” của tập con ngoại tuyến. Không thể lấy trung bình qua các dòng, không thể dựa vào đó tuyên bố đứng nhất tổng hợp trong cùng điều kiện kiểm tra. Trang kết quả của PDF phương pháp này ghi thêm “tính đến tháng 10 năm 2026”, không khớp với thời điểm chúng tôi đọc bảng trong bài là ngày 30 tháng 9; ngày hoàn thành đánh giá cụ thể chưa xác nhận được. Bài viết chỉ chép lại điểm hiển thị trên trang web chính thức lúc đó, không suy đoán đánh giá hoàn thành khi nào, cũng không nói đó là kết quả chúng tôi tái lập.
So sánh giá thế nào: phí hàng tháng và phí API phải tách riêng
Nếu chỉ muốn dùng trong sản phẩm chat hoặc công cụ lập trình, hãy xem gói đăng ký và hạn mức sử dụng trước. Trong giá công khai tại Mỹ, ChatGPT Plus là $20/tháng, Pro chia thành các mức $100, $200, $500/tháng, v.v.; lượng dùng Astra cụ thể thay đổi theo gói và tác vụ. Giải thích giá và lượng dùng ChatGPT Work/Codex của OpenAI nhắc rõ: báo giá API mỗi triệu token không thể dùng để suy ra trong gói đăng ký hoàn thành được bao nhiêu tác vụ.
Claude Pro giá hàng tháng tại Mỹ là $20, Max từ $100/tháng (bảng giá chính thức Claude). Nhưng “Pro có thể chọn Fable 5.1” không có nghĩa Fable đã nằm trong hạn mức thông thường của Pro: quy tắc gói Fable của Anthropic giải thích, Pro và ghế tiêu chuẩn Team dùng Fable 5.1 phải qua usage credits bổ sung; Max và ghế cao cấp có thể dùng trong một phần hạn mức hàng tuần. Google chưa đưa ra giá đăng ký thực tế hoặc ngày mở cho người dùng phổ thông dùng Argon, không thể lấy phí hàng tháng hiện có của Google AI Ultra làm báo giá “mua Argon hôm nay”.
Nếu trả phí API theo lượng sử dụng, dưới đây mới là báo giá văn bản tiêu chuẩn có thể đọc cùng đơn vị. Đầu vào là nội dung bạn giao cho mô hình đọc, đầu ra là câu trả lời nó tạo. Đơn vị đều là giá USD trên mỗi 1 triệu token (token là đơn vị tách văn bản v.v. khi tính phí); Argon trong bảng là giá dự kiến khi ra mắt do Google công bố, không phải hóa đơn thực tế chúng tôi đã trả hôm nay.
| Mô hình | Đầu vào thường | Đầu ra thường | Đọc cache nội dung lặp lại | Trạng thái |
|---|---|---|---|---|
| Gemini 4 Argon | Dự kiến ra mắt $2; sau ưu đãi $4 | Dự kiến ra mắt $10; sau ưu đãi $20 | Google nói đầu vào cache khi ra mắt được ưu đãi 95% so với giá đầu vào thường; quy tắc ra mắt cụ thể chờ kiểm chứng | Chưa mở rộng rãi |
| GPT-6 Astra | $10 | $50 | $1 | Giá API tiêu chuẩn hiện tại |
| Claude Fable 5.1 | $10 | $50 | $0.25 | Giá API tiêu chuẩn hiện tại |
Dữ liệu từ thông báo phát hành Argon của Google, trang giá model Astra của OpenAI và trang model Fable 5.1 của Anthropic. Giá chưa gồm công cụ bổ sung, khu vực, mức tốc độ hoặc khác biệt nền tảng; Astra khi đầu vào một lần vượt quá 272K token sẽ tính giá đầu vào và cache của toàn bộ yêu cầu gấp 2 lần, đầu ra gấp 1,5 lần. Giá cache chỉ áp dụng cho nội dung thực sự trúng cache, không thể ước tính toàn bộ tác vụ theo giá cache. Dù đơn giá dự kiến của Argon thấp hơn hai mô hình kia, không có dữ liệu tỷ lệ thành công và lượng dùng cùng tác vụ, cũng không thể khẳng định nó hoàn thành một tác vụ là rẻ nhất.
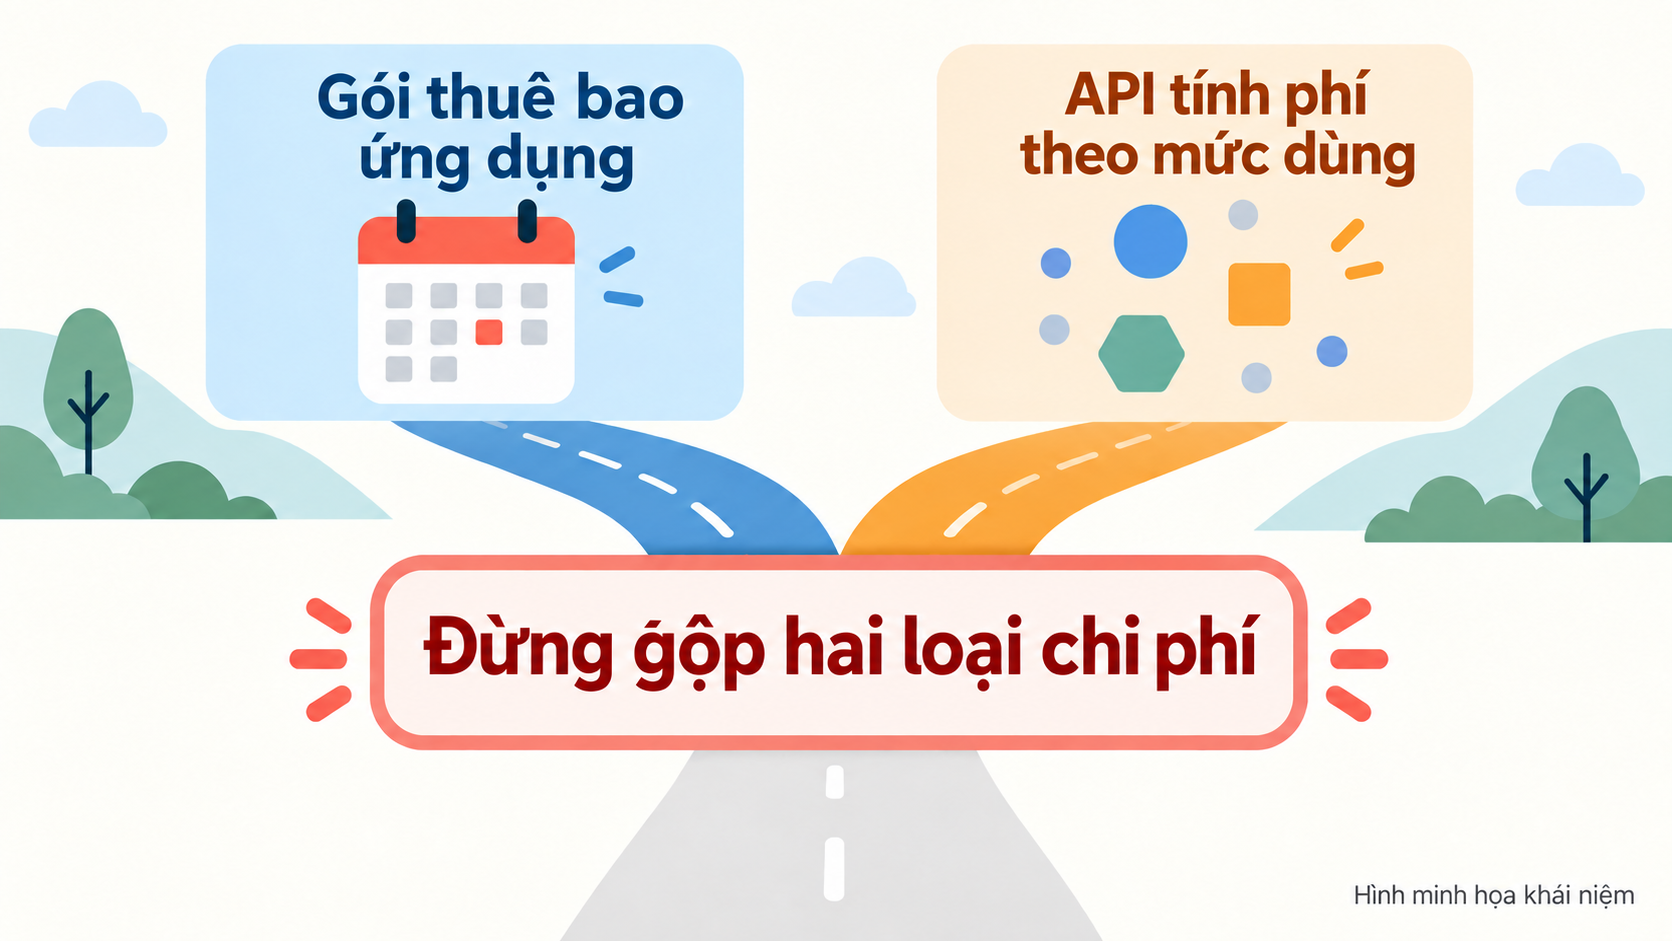
Hình: Sơ đồ minh họa cách tính phí do AI tạo, không phải hóa đơn sản phẩm; phí đăng ký hàng tháng không thể tính lẫn với đơn giá API. Xem ảnh kích thước gốc (1672×941).

Chọn theo tác vụ thế nào? Trước tiên dùng mô hình sẵn có trong tay
Tác vụ cần vượt nhiều phần mềm, hoặc cần duyệt web, thao tác giao diện và đưa ra phán đoán phức tạp: thử GPT-6 Astra trước. OpenAI xếp thao tác máy tính, duyệt web, lập trình khó và tài liệu chuyên nghiệp vào năng lực trọng tâm của nó. Nếu bạn đã có tài khoản ChatGPT trả phí hoặc quyền API phù hợp, hôm nay có thể giao một tác vụ thực tế cho nó, xem kết quả có đạt yêu cầu không. Giải thích model OpenAI.
Tác vụ là lập trình kéo dài nhiều giờ, review mã hoặc xử lý tài liệu lớn: thử Claude Fable 5.1 trước. Anthropic định vị nó cho tác vụ tự chủ thời gian dài, lập trình và nghiên cứu phức tạp. Người đã có quy trình Claude Code có thể tiếp tục dùng công cụ quen thuộc trước, nhưng cần xác nhận gói có trừ thêm credit sử dụng không; nếu mỗi ngày phải chạy nhiều tác vụ loại này, hãy so chi phí thực tế giữa Max và API. Giải thích model Anthropic.
Muốn thử Gemini 4 Argon: trước tiên xác nhận mình có quyền truy cập chính thức không. Hướng công bố của Google gồm lập trình phức tạp, công việc tri thức doanh nghiệp và tác vụ an ninh phòng thủ, đồng thời đưa ra giá dự kiến; những điều này đáng chú ý, nhưng chưa thể thay thế trải nghiệm đo kiểm thực tế của người dùng phổ thông. Khi không có quyền, không nên vì “dự kiến rẻ hơn” của Argon mà thay đổi quy trình đang chạy. Thông báo chính thức Google.
Những gợi ý này không có nghĩa “mô hình giỏi một loại tác vụ thì chỉ làm được loại đó”. Nếu sau này cả ba đều khả dụng, cách chọn chắc chắn nhất là: lấy cùng một tác vụ thực tế, đưa cùng tài liệu và tiêu chí nghiệm thu, ghi lại riêng việc có hoàn thành không, phải sửa lại thủ công, thời gian và tổng chi phí. Một màn trình diễn đẹp hoặc điểm số riêng của từng nhà cung cấp không thể trực tiếp chứng minh tác vụ của bạn cũng sẽ có kết quả tương tự.
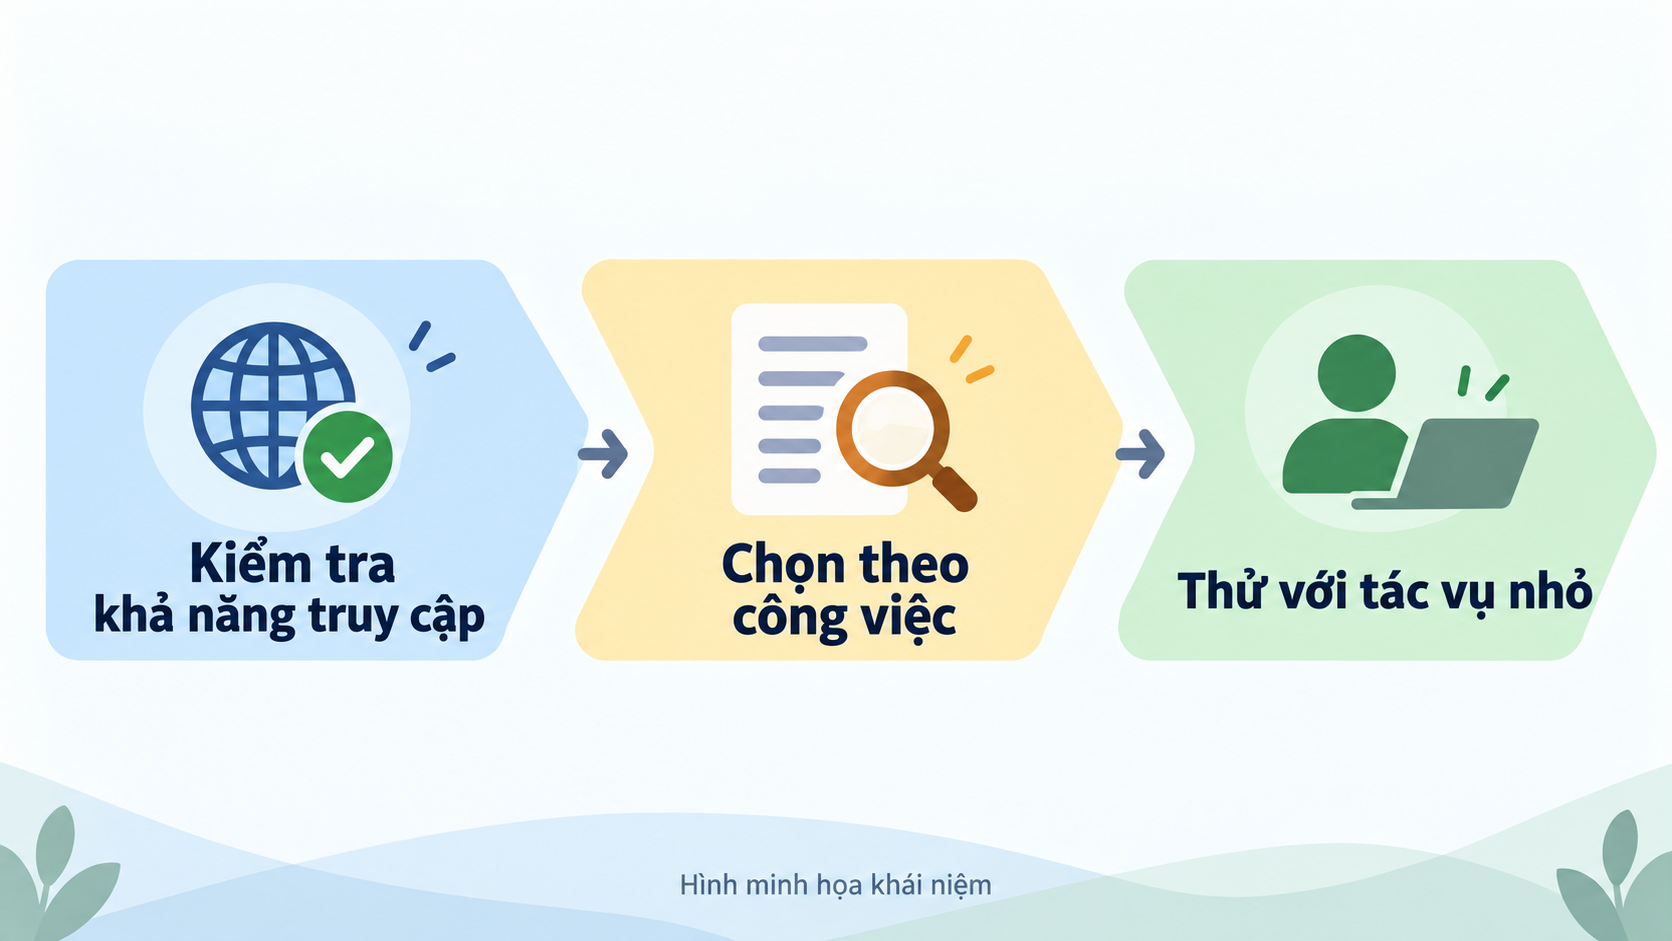
Hình: Sơ đồ minh họa đường chọn lựa do AI tạo, trước xem tài khoản và khu vực có khả dụng không, rồi xem nhu cầu tác vụ, cuối cùng dùng tác vụ nhỏ của bạn để xác minh. “Bài viết này không thực hiện bất kỳ so sánh kiểm thử nào” trong hình nghĩa là chúng tôi chưa tự chạy kiểm thử cùng điều kiện; bảng điểm ở trên là chép lại dữ liệu Google công bố. Xem ảnh kích thước gốc (1672×941).

Nếu tác vụ của bạn là để hai trợ lý lập trình phân công nhau, có thể xem hướng dẫn phối hợp Claude Code và Codex; nếu muốn giao câu hỏi cụ thể cho trang ChatGPT Pro đã đăng nhập, có thể xem hướng dẫn Codex và Claude Code nhờ ChatGPT Pro. Hai bài này giới thiệu thao tác quy trình, không có nghĩa Gemini 4 Argon đã được tích hợp vào PandaNpc.
Câu hỏi thường gặp (FAQ)
Gemini 4 Argon đã phát hành chính thức, tại sao tôi không tìm thấy?
“Phát hành” nghĩa là Google đã công bố mô hình và mở cho phạm vi hạn chế; thông báo chính thức chưa đưa ra ngày mở thống nhất cho tất cả nhà phát triển và người tiêu dùng phổ thông. Trước tiên hãy xem danh sách model chính thức của sản phẩm Gemini và tài khoản bạn đang dùng, đừng coi “Gemini 4 Pro” trong tin đồn là cổng vào khả dụng của Argon.
Astra có phải Project Astra của Google không?
Không. GPT-6 Astra trong bài là mô hình của OpenAI; Google Project Astra là một dự án nghiên cứu khác, không thể trộn vào bảng giá ba mô hình.
Đã đăng ký Claude Pro thì có thể dùng Fable 5.1 trong hạn mức gói không?
Không hẳn. Giải thích gói hiện hành của Anthropic cho biết, Pro dùng Fable 5.1 cần usage credits, còn một số gói như Max có thể dùng trong hạn mức hàng tuần giới hạn. Trước khi thanh toán, hãy xem trang “mức sử dụng/credit” của mình.
Có thể trực tiếp dựa vào giá trên để kết luận ai rẻ nhất không?
Không. Bảng API chỉ so giá niêm yết; khi hoàn thành tác vụ còn chịu ảnh hưởng của độ dài đầu vào, nội dung lặp lại có trúng cache không, phí công cụ, số vòng chạy và sửa lại. Đặc biệt Argon chưa mở rộng rãi, không thể đưa ra “chi phí mỗi tác vụ thành công” của chính chúng tôi.
Hướng dẫn liên quan

GPT-6 Sol vs Claude Opus 5.5: Chọn theo giá, điểm số và tác vụ lập trình như thế nào?
Với các tác vụ lập trình API thông thường, hãy thử GPT-6 Sol trước; với tác vụ phức tạp, có thể so sánh Claude Opus 5.5, sau đó dùng GPT-6 Astra và Claude Fable 5.1 làm các lựa chọn cho độ khó cao. Bài viết này kiểm tra thông số chính thức của bốn mô hình, giá bộ nhớ đệm và Batch, điểm benchmark bên thứ ba cùng tiêu chuẩn, đồng thời cung cấp năm nhóm tình huống chi phí có thể tính lại.
Đọc bài viết →
Claude Code vs Codex: Cách chọn giữa tính năng, điều khiển từ xa, quyền hạn và trường hợp sử dụng (2026)
Kết luận: Claude Code cho terminal chuyên sâu, Hooks và hệ sinh thái Claude; Codex cho ChatGPT, tác vụ đám mây và đa Agent; PandaNpc để điều khiển cả hai từ xa trên Windows, macOS, Linux và di động.
Đọc bài viết →
Cách dùng ChatGPT Pro cùng Codex và Claude Code trong PandaNpc
Trong cuộc trò chuyện Codex hoặc Claude Code của PandaNpc, bạn có thể giao một câu hỏi cụ thể cho trang web ChatGPT Pro đã đăng nhập, và câu trả lời sẽ quay trở lại cuộc trò chuyện ban đầu.
Đọc bài viết →