
Gemini 4 Argon、GPT-6 Astra、Claude Fable 5.1 の選び方:可用性・価格・適したユースケースの比較
2026年9月30日時点で、Gemini 4 Argonは信頼できるテスター限定、GPT-6 AstraとClaude Fable 5.1は有料で利用可能なため、公式公開データに基づき(同一条件の検証ではなく、API価格とサブスクリプションは別枠)、地域差を踏まえタスクとプランで選んでください。
資料確認:2026年9月30日(UTC)。 PandaNpc は AI Agent サービスを提供しており、モデル選定に関連します。本記事は3社が公開している情報を整理し、タスク別に選択するための提案を示します。私たちは Gemini 4 Argon の試用権限をまだ取得しておらず、3モデルを同一条件で実測したわけではありません。以下の「適している」は公式の位置づけと現在の可用性を指し、どれがより優れているかを私たちが測定したという意味ではありません。
先に結論:今日すぐ使うなら、まず GPT-6 Astra と Claude Fable 5.1 の間で、タスクと現在のプランに応じて選びましょう。Gemini 4 Argon は現在、少数の信頼できるテスターにのみ開放されており、一般ユーザーがいつでも選べる第3の選択肢として扱うことはまだできません。 複数ソフトをまたぐ操作、複雑な資料整理、高度なプログラミングなら、まず Astra を試せます。長期的なプログラミング、大規模プロジェクトや複雑な文書を繰り返し読む作業なら、まず Fable 5.1 を試せます。Argon が広く開放されたら、同じタスクで実際の完了品質と総コストを比較しましょう。
まず使えるかどうか:3モデルは同じスタートラインにない
| モデル | 公式リリース日 | 9月30日時点で誰が使えるか | 一般読者にとって何を意味するか |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | まず Google Fairwind プロジェクトの信頼できるサイバー防御担当者とテスターに開放。開発者・企業・消費者への広範な開放は今後の段階を待つ | 今日「リリース済み」を見かけても、あなたの Gemini アカウントや API で Argon を選べるようになったという意味ではない |
| GPT-6 Astra | 2026-09-03 | ChatGPT 有料ユーザーおよび API ユーザー向けに段階的に提供中。具体的な利用可能量はプランとアカウントによる | 自分のモデル一覧と利用枠を確認し、すぐに実際のタスクを始められる |
| Claude Fable 5.1 | 2026-09-01 | Claude 有料プランおよび Claude API で利用可能。ただし Pro などのプランでは追加の使用クレジットが必要な場合がある | まずプランの Fable 利用ルールを確認し、アップグレードや別途課金をするか決める |
Google の Gemini 4 Argon 発表では現在小規模開放と明記され、将来は有料 API ユーザーと Google AI Ultra 購読者から拡大する予定。一般ユーザーが利用可能になる確定日は公表されていません。OpenAI の Astra 発表とAnthropic の Fable 5.1 説明はそれぞれ既存の開放範囲を説明しています。ここでの Astra は OpenAI のモデルであり、Google の Project Astra 研究プロジェクトではありません。
パラメータ対照:「どれだけ読めるか」と「どれだけ書けるか」を混同しない
入力コンテキストウィンドウは、一度にモデルへ渡せる資料量です。最大出力は、一度に生成できる内容の最大量です。この2つの数字は互換ではなく、数字だけで回答品質を判断することもできません。以下はすべて2026年9月30日に確認した具体的なモデルの情報であり、Gemini、GPT、Claude の全ファミリー共通仕様ではありません。
| パラメータ | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| 入力コンテキストウィンドウ | 正式な上限は未公表 | 1,050,000 token | 1,000,000 token |
| 1回の最大出力 | Google の発表では 1,000,000 token。一般ユーザーはまだ検証できない | 128,000 token | 128,000 token |
| モデルに渡せる入力 | 発表ではマルチモーダルと長尺動画理解を示しているが、完全な API 入力タイプ一覧は未公表 | テキスト、画像 | テキスト、画像 |
| 現在の正式な入口 | Fairwind の信頼できるテスター。広範開放時期は未公表 | ChatGPT 有料アカウントは提供状況とプランによる、OpenAI API | Claude 有料製品と Claude API。Pro などのプランには追加クレジット条件がある |
出典:Google の Gemini 4 Argon 発表、OpenAI の GPT-6 Astra モデルページ、Anthropic の Claude Fable 5.1 モデルページとAnthropic のプラン説明。Google 発表の「100万」は出力上限を指しており、Argon が「100万入力コンテキストウィンドウ」を公表したと受け取ってはいけません。Argon の完全な公開モデルカードと一般ユーザーによる実測はまだ発表待ちです。表中の「未公表」は「その能力がない」という意味ではありません。
上の表が比較しているのは公開仕様であり、性能の勝敗ではありません。多くの内容を収容できても、回答がより正確とは限りません。次の表こそが性能ベンチマークの成績です。
公式ベンチマーク比較:具体的なタスクを見て、「総合王者」を決めない
Google DeepMind は Gemini 4 Argon 公式モデルページで4モデルのベンチマーク表を公表しました。ここでは本記事で扱う Argon、GPT-6 Astra、Claude Fable 5.1 の3列のみを抜粋します。原表には Claude Opus 5.5 も含まれます。以下の成績は 2026年9月30日 23:42 UTC に実際に読み取った Google 公式ページのもので、Google が編纂したものであり、PandaNpc による同一条件の実測ではありません。F1、通過率、部分スコアと明記した行を除き、数値は原表のパーセントをそのまま使用します。各行では、この3モデルの中で高い値のみを太字にしています。「—」は原表に比較可能な成績がないことを示し、0点ではありません。
| 能力グループ | Benchmark(テスト項目) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| ナレッジワーク | Vals Index | 68.9% | 63.1% | 65.8% |
| ナレッジワーク | AutomationBench | 51.3% | 41.4% | 31.4% |
| ナレッジワーク | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| ナレッジワーク | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| 自動プログラミング | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| 自動プログラミング | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| 自動プログラミング | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| 自動プログラミング | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| 機械学習エンジニアリング | PostTrainBench | 45.3% | 44.3% | 40.2% |
| 科学と数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| 科学と数学 | LABBench 2 | 88.8% | 85.4% | 68.6% |
| 科学と数学 | RiemannBench | 76.0% | 72.0% | 65.6% |
| 長文 | GraphWalks(≤128K,BFS F1) | 99.7% | 98.7% | 91.4% |
| 長文 | GraphWalks(256K–1M,BFS F1) | 84.2% | 71.8% | 65.0% |
| コンピュータ操作 | Agent's Last Exam(通過率) | 39.5% | 34.2% | — |
| コンピュータ操作 | OSWorld-2.0(オフラインサブセット,部分スコア) | 69.2% | 72.6% | — |
| 図表・画像理解 | Chartography | 71.6% | 71.0% | 46.2% |
| 動画理解 | LVBench | 91.7% | 87.5% | 79.7% |
| 防御的セキュリティ | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
この表をどう使うか? ナレッジワークなら、まず Vals Index、Finance Agent を見るとよいでしょう。コードを書くなら DeepSWE、FrontierSWE、Terminal-bench を同時に見て、1行だけを選ばないこと。Argon は DeepSWE でリードしていますが、Astra は FrontierSWE と Terminal-bench でより高いです。コンピュータ操作は特に注意が必要で、Fable はこの Google 表の2行が欠落していますが、それをもってコンピュータを操作できないとは言えません。CWE-bench では Argon と Astra が3モデル中で並んでいることが示されていますが、これも実際のセキュリティ業務を保証するものではありません。
テスト条件: Google の評価方法説明には、Argon の成績は通常、単回試行・最高思考レベルであると明記されています。他モデルのデータは多くが各ベンダーの自己申告または公開リーダーボードから来ており、それぞれの最高または利用可能な思考レベルを採用している可能性があります。一部の項目は Google が自ら実行し、一部は第三者から提供されており、ツール環境やサンプリング方法はどこも同じではありません。例えば DeepSWE と Terminal-bench の Argon 成績は Google の自社テストで、他モデルは公開成績を使用しています。LVBench ではモデルごとに抽出する動画フレーム数が異なります。GraphWalks 行は BFS F1 を使用し、OSWorld 行はオフラインサブセットの「部分スコア」のみを表します。行をまたいで平均を取ることはできず、これをもとに統一テスト条件下での総合1位を主張することもできません。この方法 PDF の結果ページには別途「2026年10月時点」と書かれており、本記事が 9月30日 に表を読み取った時点と一致しません。具体的な評価完了日は確認できませんでした。本記事は当時公式サイトで見られた成績を転記するだけであり、評価がいつ完了したかを推測せず、私たちが再現した結果であるとも述べません。
価格の比較方法:月額料金と API 費用は分けて考える
チャット製品やプログラミングツール内だけで使いたいなら、まずサブスクリプションと利用枠を確認しましょう。米国公開価格では、ChatGPT Plus は $20/月、Pro は $100、$200、$500/月などの段階があります。具体的な Astra 使用量はプランとタスクによって変わります。OpenAI の ChatGPT Work/Codex 価格と使用量説明は、API の100万 token あたりの価格から、サブスクリプション内でどれだけタスクを完了できるかを推測してはいけないと明確に注意しています。
Claude Pro の米国月額は $20、Max は $100/月からです(Claude 公式価格表)。ただし「Pro で Fable 5.1 を選べる」ことは、Fable が Pro の通常枠に含まれるという意味ではありません。Anthropic の Fable プランルールでは、Pro と Team の標準席で Fable 5.1 を使うには追加の usage credits が必要で、Max と上位席では週次枠の一部内で使えると説明されています。Google は一般ユーザーが Argon を使う際の実際のサブスクリプション価格や開放日をまだ示しておらず、Google AI Ultra の現在の月額を「今日 Argon を買う」価格と見なすことはできません。
API で使用量に応じて支払う場合、以下が同じ単位で読める標準テキスト価格です。入力はモデルに読ませる内容、出力は生成される回答を指します。単位はすべて 100万 token あたりの米ドル価格です(token は課金時に文字など内容を分割する単位)。表中の Argon は Google が公表した将来提供時の価格であり、私たちが今日すでに支払った実測請求ではありません。
| モデル | 通常入力 | 通常出力 | 繰り返し内容のキャッシュ読み取り | 状態 |
|---|---|---|---|---|
| Gemini 4 Argon | 初回提供予定 $2。優待期間後 $4 | 初回提供予定 $10。優待期間後 $20 | Google によると初回キャッシュ入力は通常入力価格から95%割引。具体的な提供ルールは要確認 | まだ広く開放されていない |
| GPT-6 Astra | $10 | $50 | $1 | 現在の API 標準価格 |
| Claude Fable 5.1 | $10 | $50 | $0.25 | 現在の API 標準価格 |
データはGoogle の Argon リリース発表、OpenAI の Astra モデル価格ページおよびAnthropic の Fable 5.1 モデルページによります。価格には追加ツール、地域、速度ティア、プラットフォーム差は含まれません。Astra では1回の入力が 272K token を超える場合、リクエスト全体の入力とキャッシュ価格が2倍、出力が1.5倍で計算されます。キャッシュ価格は実際にキャッシュにヒットした内容にのみ適用され、タスク全体をキャッシュ価格で見積もることはできません。たとえ Argon の予定単価が他の2モデルより低くても、同一タスクの成功率と使用量データがなければ、1タスクを最も安く完了できると断言することはできません。
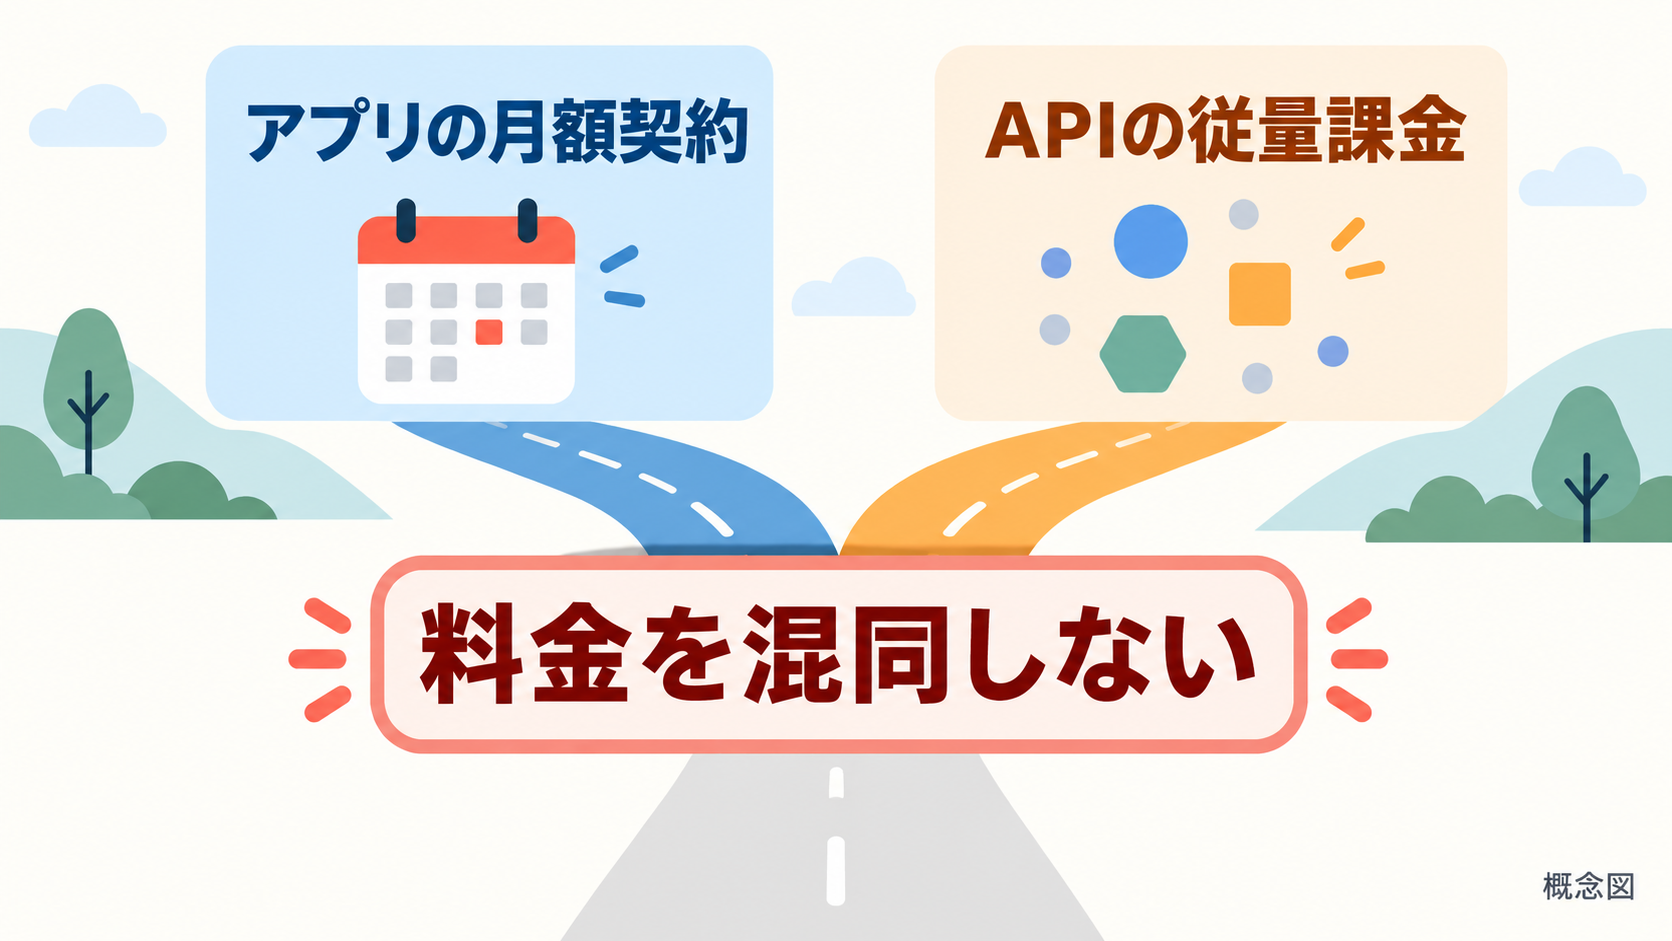
図:AI 生成による課金口径の概念図であり、製品の請求書ではありません。サブスクリプション月額と API 単価を混ぜて計算することはできません。原寸図(1672×941)を表示。

タスク別の選び方:まず手元で使えるモデルを使う
複数のソフトをまたぐタスク、またはWeb閲覧・インターフェース操作と複雑な判断が必要な場合:まず GPT-6 Astra を試す。 OpenAI はコンピュータ操作、閲覧、高度なプログラミング、専門文書を重点能力として挙げています。適切な ChatGPT 有料アカウントまたは API 権限がすでにあるなら、今日にでも実際のタスクを任せ、結果が要件を満たすか確認できます。OpenAI モデル説明。
数時間続くプログラミング、コードレビュー、大規模文書作業がタスクの場合:まず Claude Fable 5.1 を試す。 Anthropic はこれを長時間の自律タスク、複雑なプログラミングと研究に位置づけています。既に Claude Code ワークフローがある人は、慣れたツールをそのまま使ってよいですが、まずプランで使用クレジットが別途差し引かれるか確認しましょう。この種のタスクを毎日多く走らせるなら、Max と API の実際のコストを比較してください。Anthropic モデル説明。
Gemini 4 Argon を試したい場合:自分が公式アクセス権限を得ているか先に確認する。 Google が公表している方向性には、複雑なプログラミング、企業ナレッジワーク、防御的セキュリティタスクが含まれ、予定価格も示されています。これらは注目に値しますが、一般ユーザーの実測体験の代わりにはまだなりません。権限がない場合、Argon の「より安くなる見込み」のために現在稼働中のワークフローを変えることはおすすめしません。Google 公式発表。
これらの提案は「モデルがある種のタスクを得意とするなら、その種類しかできない」という意味ではありません。将来3モデルすべてが利用可能になったら、最も堅実な選び方は、同じ実タスクを用意し、同じ資料と受け入れ基準を与え、完了したか、人手によるやり直し、所要時間、総費用をそれぞれ記録することです。一度の見事なデモや各ベンダーそれぞれのベンチマークは、あなたのタスクでも同じ結果が得られると直接証明するものではありません。
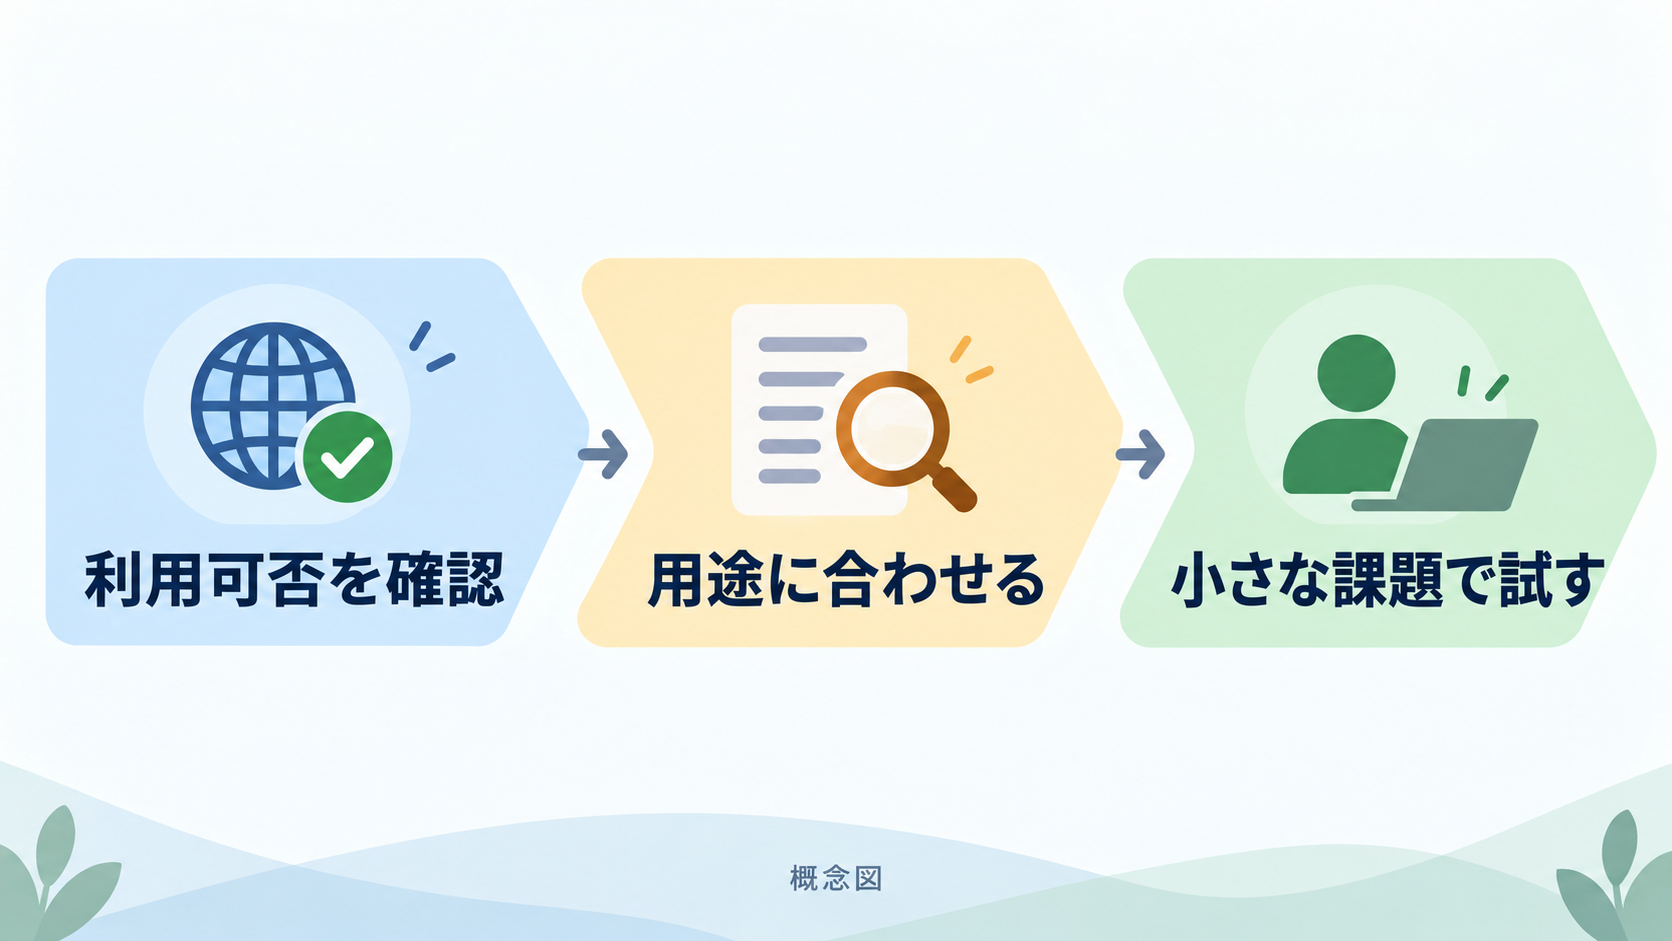
図:AI 生成による選択パスの概念図。まずアカウントと地域の可用性を見て、次にタスク要件を見て、最後に自分の小さいタスクで検証します。図中の「本記事はいかなる比較テストも行わない」とは、私たちが同一条件のテストを自ら実行していないことを指します。上記のベンチマーク表は Google が公表したデータの転記です。原寸図(1672×941)を表示。

2つのプログラミングアシスタントを分担させるタスクなら、Claude Code と Codex の協働チュートリアルをご覧ください。具体的な問題をログイン済みの ChatGPT Pro ページに渡すなら、Codex と Claude Code から ChatGPT Pro に助けを求めるチュートリアルをご覧ください。この2本はワークフロー操作を紹介するものであり、Gemini 4 Argon が PandaNpc に接続済みであることを意味しません。
よくある質問(FAQ)
Gemini 4 Argon は正式リリース済みなのに、なぜ見つからない?
「リリース」とは Google がモデルを公表し、限定範囲に開放したことを指します。公式発表は、すべての開発者と一般消費者向けの統一開放日をまだ示していません。まず自分が使う Gemini 製品とアカウントの正式なモデル一覧を確認し、噂の「Gemini 4 Pro」を Argon の利用可能な入口と見なさないでください。
Astra は Google の Project Astra ですか?
いいえ。本記事の GPT-6 Astra は OpenAI のモデルです。Google Project Astraは別の研究プロジェクトであり、3モデルの価格表に混ぜることはできません。
Claude Pro を契約すれば、プラン枠内で Fable 5.1 を使えますか?
必ずしもそうではありません。Anthropic の現行プラン説明では、Pro で Fable 5.1 を使うには usage credits が必要で、Max など一部プランでは限られた週次枠内で利用できるとされています。支払い前に自分の「使用量/クレジット」ページを確認してください。
上記の価格だけでどれが最もお得か判断できますか?
できません。API 表は表示価格を比較しているだけです。タスク完了時には、入力長、繰り返し内容がキャッシュにヒットしたか、ツール費用、実行ラウンド数、やり直しの影響も受けます。特に Argon はまだ広く開放されていないため、私たち自身の「成功タスクあたりコスト」を示すことはできません。
関連ガイド

GPT-6 Sol vs Claude Opus 5.5:価格、ベンチマークスコア、コーディングタスクでどう選ぶ?
一般的な API プログラミングタスクでは、まず GPT-6 Sol を試してください。複雑なタスクでは Claude Opus 5.5 と比較し、さらに高難度の選択肢として GPT-6 Astra と Claude Fable 5.1 を候補にしましょう。本記事では、4モデルの公式仕様、キャッシュと Batch の価格、同一条件の第三者ベンチマークを確認し、再計算可能な費用シナリオを5つ提供します。
記事を読む →
Claude Code vs Codex:機能、リモート制御、権限、利用シーンの選び方(2026)
結論:高度なターミナル操作、Hooks、Claude エコシステムなら Claude Code。ChatGPT、クラウドタスク、デスクトップのマルチ Agent なら Codex。Windows、macOS、Linux、スマホから両方を一元遠隔操作するなら PandaNpc。
記事を読む →
PandaNpcでCodex・Claude CodeからChatGPT Proを使う方法
PandaNpc の Codex または Claude Code の会話では、具体的な質問をログイン済みの ChatGPT Pro ウェブページに渡すことができ、回答は元の会話に戻ります。この記事では、英語のインターフェースのスクリーンショットを使って、準備、有効化、タスクの割り当て、結果の確認、自動送信の選択について明確に説明し、デモデータの範囲を示します。
記事を読む →