
Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 – hvordan vælger man? Sammenligning af tilgængelighed, pris og anvendelsesscenarier
Gemini 4 Argon har begrænset tilgængelighed; vælg nu tilgængelige GPT-6 Astra eller Claude Fable 5.1 efter opgave/plan, abonnement/API-priser adskilt, efter officielle data, ikke ens test.
Kildekontrol: 30. september 2026 (UTC). PandaNpc leverer AI Agent-tjenester, hvilket er relevant for modelvalg. Denne artikel sammenfatter offentligt tilgængelig information fra de tre virksomheder og giver anbefalinger til valg efter opgave; vi har endnu ikke fået prøveadgang til Gemini 4 Argon og har ikke udført sammenlignende tests af de tre modeller under samme betingelser. "Velegnet" nedenfor refererer til den officielle positionering og aktuelle tilgængelighed og betyder ikke, at vi har målt, hvem der er stærkest.
Konklusion først: Hvis du skal bruge den i dag, så vælg først mellem GPT-6 Astra og Claude Fable 5.1 ud fra opgave og nuværende abonnement; Gemini 4 Argon er i øjeblikket kun åben for et lille antal betroede testere, og almindelige brugere kan endnu ikke regne den som en tredje mulighed, der altid er tilgængelig. Til operationer på tværs af software, kompleks materialeorganisering eller svær programmering kan du først prøve Astra; til langvarig programmering, gentagen læsning af store projekter eller komplekse dokumenter kan du først prøve Fable 5.1. Når Argon bliver bredt tilgængelig, kan du sammenligne den faktiske kvalitet og de samlede omkostninger med de samme opgaver.
Se forsidebilledet i fuld størrelse PNG (1672×941)
Se først, om de kan bruges: de tre modeller starter ikke fra samme linje
| Model | Officiel udgivelsesdato | Hvem kan bruge den pr. 30. september | Hvad betyder det for almindelige læsere |
|---|---|---|---|
| Gemini 4 Argon | 2026-09-30 | Åbnes først for betroede cyberforsvarere og testere i Google Fairwind-projektet; bred åbning for udviklere, virksomheder og forbrugere afventer senere faser | At se "udgivet" i dag betyder ikke, at din Gemini-konto eller API allerede kan vælge Argon |
| GPT-6 Astra | 2026-09-03 | Udrulles gradvist til betalende ChatGPT-brugere og API-brugere; den konkrete tilgængelige kvote afhænger af abonnement og konto | Du kan kontrollere din modelliste og brugskvote og straks begynde på rigtige opgaver |
| Claude Fable 5.1 | 2026-09-01 | Tilgængelig i betalte Claude-abonnementer og Claude API, men abonnementer som Pro kan kræve ekstra usage credits | Tjek først abonnementets Fable-regler, og beslut derefter, om du vil opgradere eller betale ekstra |
Googles meddelelse om Gemini 4 Argon skriver, at der i øjeblikket er tale om en begrænset åbning, og at planen fremover er at udvide fra betalende API-brugere og Google AI Ultra-abonnenter; der er ikke offentliggjort en fast dato for, hvornår almindelige brugere kan bruge den. OpenAIs Astra-meddelelse og Anthropics Fable 5.1-beskrivelse forklarer hver især den nuværende åbning. Astra her er en OpenAI-model, ikke Googles Project Astra-forskningsprojekt.
Parametersammenligning: bland ikke "hvor meget den kan læse" med "hvor meget den kan skrive"
Input-kontekstvinduet er, hvor meget materiale der kan gives til modellen på én gang; maksimal output er, hvor meget indhold den maksimalt kan generere på én gang. De to tal kan ikke byttes om, og man kan heller ikke vurdere svar kvaliteten alene ud fra tallene. Alt nedenfor er oplysninger om de specifikke modeller, som blev verificeret den 30. september 2026, ikke generelle specifikationer for hele Gemini-, GPT- eller Claude-familierne.
| Parameter | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Input-kontekstvindue | Officiel øvre grænse ikke offentliggjort | 1.050.000 token | 1.000.000 token |
| Maksimal output pr. gang | Google meddelelse siger 1.000.000 token; almindelige brugere kan endnu ikke verificere det | 128.000 token | 128.000 token |
| Input, der kan gives til modellen | Meddelelsen viser multimodal og lang video-forståelse, men den fuldstændige liste over API-inputtyper er ikke offentliggjort | Tekst, billeder | Tekst, billeder |
| Aktuel officiel adgang | Fairwind-betroede testere; tidspunkt for bred åbning ikke offentliggjort | Betalte ChatGPT-konti efter udrulningsfremdrift og abonnement, OpenAI API | Betalte Claude-produkter og Claude API; abonnementer som Pro har ekstra kreditbetingelser |
Kilder: Googles meddelelse om Gemini 4 Argon, OpenAIs GPT-6 Astra-modelside, Anthropics Claude Fable 5.1-modelside og Anthropics abonnementsbeskrivelse. Googles meddelelse om "1 million" refererer til outputgrænsen og kan ikke tages som udtryk for, at Argon har offentliggjort et "1 million input-kontekstvindue". Argons fuldstændige offentlige modelkort og almindelige brugeres tests mangler stadig at blive udgivet; "ikke offentliggjort" i tabellen betyder ikke "denne funktion findes ikke".
Tabellen ovenfor sammenligner offentlige specifikationer, ikke hvem der vinder på ydeevne: Jo mere indhold den kan rumme, desto mere præcist er svaret ikke nødvendigvis. Tabellen nedenfor viser derimod benchmarkresultater.
Sammenligning af officielle benchmarkresultater: se på de konkrete opgaver, kår ikke en "samlet vinder"
Google DeepMind har på Gemini 4 Argons officielle modelside offentliggjort en benchmarktabel med fire modeller. Her udtrækkes kun de tre kolonner for Argon, GPT-6 Astra og Claude Fable 5.1, som diskuteres i denne artikel; den oprindelige tabel indeholder også Claude Opus 5.5. Resultaterne nedenfor kommer fra Googles officielle webside, som den blev læst den 30. september 2026 kl. 23:42 UTC, og er sammenstillet af Google, ikke en test udført af PandaNpc under samme betingelser. Bortset fra rækker, hvor F1, gennemførelsesrate eller delvis score er angivet, følger værdierne den oprindelige tabels procenter; i hver række er den højeste værdi blandt disse tre modeller fremhævet med fed. "—" betyder, at den oprindelige tabel ikke har et sammenligneligt resultat, ikke 0 point.
| Evnegruppe | Benchmark (testemne) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Vidensarbejde | Vals Index | 68.9% | 63.1% | 65.8% |
| Vidensarbejde | AutomationBench | 51.3% | 41.4% | 31.4% |
| Vidensarbejde | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% |
| Vidensarbejde | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% |
| Automatisk programmering | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% |
| Automatisk programmering | FrontierSWE v2 | 55.0% | 65.5% | 56.3% |
| Automatisk programmering | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| Automatisk programmering | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% |
| Machine learning-engineering | PostTrainBench | 45.3% | 44.3% | 40.2% |
| Videnskab og matematik | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% |
| Videnskab og matematik | LABBench 2 | 88.8% | 85.4% | 68.6% |
| Videnskab og matematik | RiemannBench | 76.0% | 72.0% | 65.6% |
| Lang tekst | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 91.4% |
| Lang tekst | GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 65.0% |
| Computerbetjening | Agent's Last Exam (gennemførelsesrate) | 39.5% | 34.2% | — |
| Computerbetjening | OSWorld-2.0 (offline-delsæt, delvis score) | 69.2% | 72.6% | — |
| Billede-tekst-forståelse | Chartography | 71.6% | 71.0% | 46.2% |
| Videoforståelse | LVBench | 91.7% | 87.5% | 79.7% |
| Defensiv sikkerhed | CWE-bench v1 | 68.0% | 68.0% | 58.0% |
Hvordan bruges denne tabel? Hvis du udfører vidensarbejde, kan du først se på Vals Index og Finance Agent; til kodning kan du samtidig se på DeepSWE, FrontierSWE og Terminal-bench, og ikke kun vælge én række: Argon fører i DeepSWE, men Astra er højere i FrontierSWE og Terminal-bench. Ved computerbetjening skal du være særligt opmærksom: Fable mangler i to rækker i denne Google-tabel, og det betyder ikke, at den ikke kan betjene en computer. CWE-bench viser, at Argon og Astra er sideordnede blandt de tre; det er heller ikke en garanti for reelt sikkerhedsarbejde.
Testgrundlag: Googles beskrivelse af evalueringsmetode angiver, at Argons resultater normalt er fra et enkelt forsøg på det højeste tænkeniveau; data for andre modeller kommer ofte fra leverandørernes egne oplysninger eller offentlige ranglister og kan også bruge deres eget højeste eller tilgængelige tænkeniveau. Nogle projekter køres af Google selv, andre kommer fra tredjeparter, og værktøjsmiljøer og samplingmetoder er ikke ens overalt. For eksempel er Argons resultater i DeepSWE og Terminal-bench Googles egne tests, mens andre modeller bruger offentlige resultater; LVBench udtrækker forskellige antal videoframes for forskellige modeller. GraphWalks-rækken bruger BFS F1, og OSWorld-rækken repræsenterer kun en "delvis score" for offline-delsættet. Man kan ikke tage gennemsnit på tværs af rækker, og man kan ikke på dette grundlag hævde en samlet førsteplads under ensartede testbetingelser. Dette metodes PDF's resultatside skriver desuden "pr. oktober 2026", hvilket ikke stemmer med det tidspunkt, hvor tabellen blev læst i denne artikel den 30. september; den præcise dato for evalueringens afslutning kunne ikke bekræftes. Denne artikel gengiver kun de resultater, der var synlige på det daværende officielle websted, og konkluderer ikke, hvornår evalueringen blev afsluttet, og fremstiller dem heller ikke som resultater, vi har reproduceret.
Hvordan sammenlignes priser: månedspris og API-omkostninger skal holdes adskilt
Hvis du kun vil bruge den i et chatprodukt eller programmeringsværktøj, skal du først se på abonnement og brugskvote. I de offentliggjorte amerikanske priser koster ChatGPT Plus $20/måned, og Pro findes i niveauer som $100, $200 og $500/måned; den konkrete Astra-forbrug afhænger af abonnement og opgave. OpenAIs pris- og forbrugsbeskrivelse for ChatGPT Work/Codex minder tydeligt om: API-prisen pr. million token kan ikke bruges til at beregne, hvor mange opgaver der kan udføres inden for et abonnement.
Claude Pro koster $20 om måneden i USA, og Max starter ved $100/måned (Claudes officielle prisliste). Men "Pro kan vælge Fable 5.1" betyder ikke, at Fable er inkluderet i Pros normale kvote: Anthropics Fable-abonnementsregler forklarer, at Pro og standardpladser i Team skal bruge ekstra usage credits for at bruge Fable 5.1; Max og højere pladser kan bruge den inden for en del af den ugentlige kvote. Google har endnu ikke oplyst den faktiske abonnementspris eller åbningsdato for almindelige brugeres brug af Argon, og den nuværende månedspris for Google AI Ultra kan ikke bruges som et tilbud på "at købe Argon i dag".
Hvis du betaler efter forbrug via API, er det først nedenstående standardtekstpriser, der kan læses i samme enhed. Input refererer til det indhold, du giver modellen at læse, og output refererer til det svar, den genererer. Enheden er USD-pris pr. 1 million token (token er den enhed, hvori tekst og andet indhold opdeles ved fakturering); Argon i tabellen er den fremtidige lanceringspris, som Google har offentliggjort, ikke en faktisk regning, vi har betalt i dag.
| Model | Almindeligt input | Almindeligt output | Cache-læsning af gentaget indhold | Status |
|---|---|---|---|---|
| Gemini 4 Argon | Foreløbig lanceringspris $2; efter rabatperioden $4 | Foreløbig lanceringspris $10; efter rabatperioden $20 | Google siger, at cachet input ved lancering får 95% rabat i forhold til almindelig inputpris; de konkrete lanceringsregler afventer verifikation | Ikke bredt tilgængelig endnu |
| GPT-6 Astra | $10 | $50 | $1 | Aktuel standard-API-pris |
| Claude Fable 5.1 | $10 | $50 | $0.25 | Aktuel standard-API-pris |
Data kommer fra Googles Argon-lanceringsmeddelelse, OpenAIs Astra-modelprisside og Anthropics Fable 5.1-modelside. Priserne inkluderer ikke ekstra værktøjer, regioner, hastighedsniveauer eller platformforskelle; for Astra, når et enkelt input overstiger 272K token, faktureres input og cachepris for hele anmodningen med 2x, og output med 1,5x. Cacheprisen gælder kun for indhold, der faktisk rammer cachen, og man kan ikke estimere hele opgaven efter cachepris. Selv om Argons foreløbige enhedspris er lavere end de to andre, kan man uden data om succesrate og forbrug for den samme opgave ikke hævde, at den billigst fuldfører en opgave.
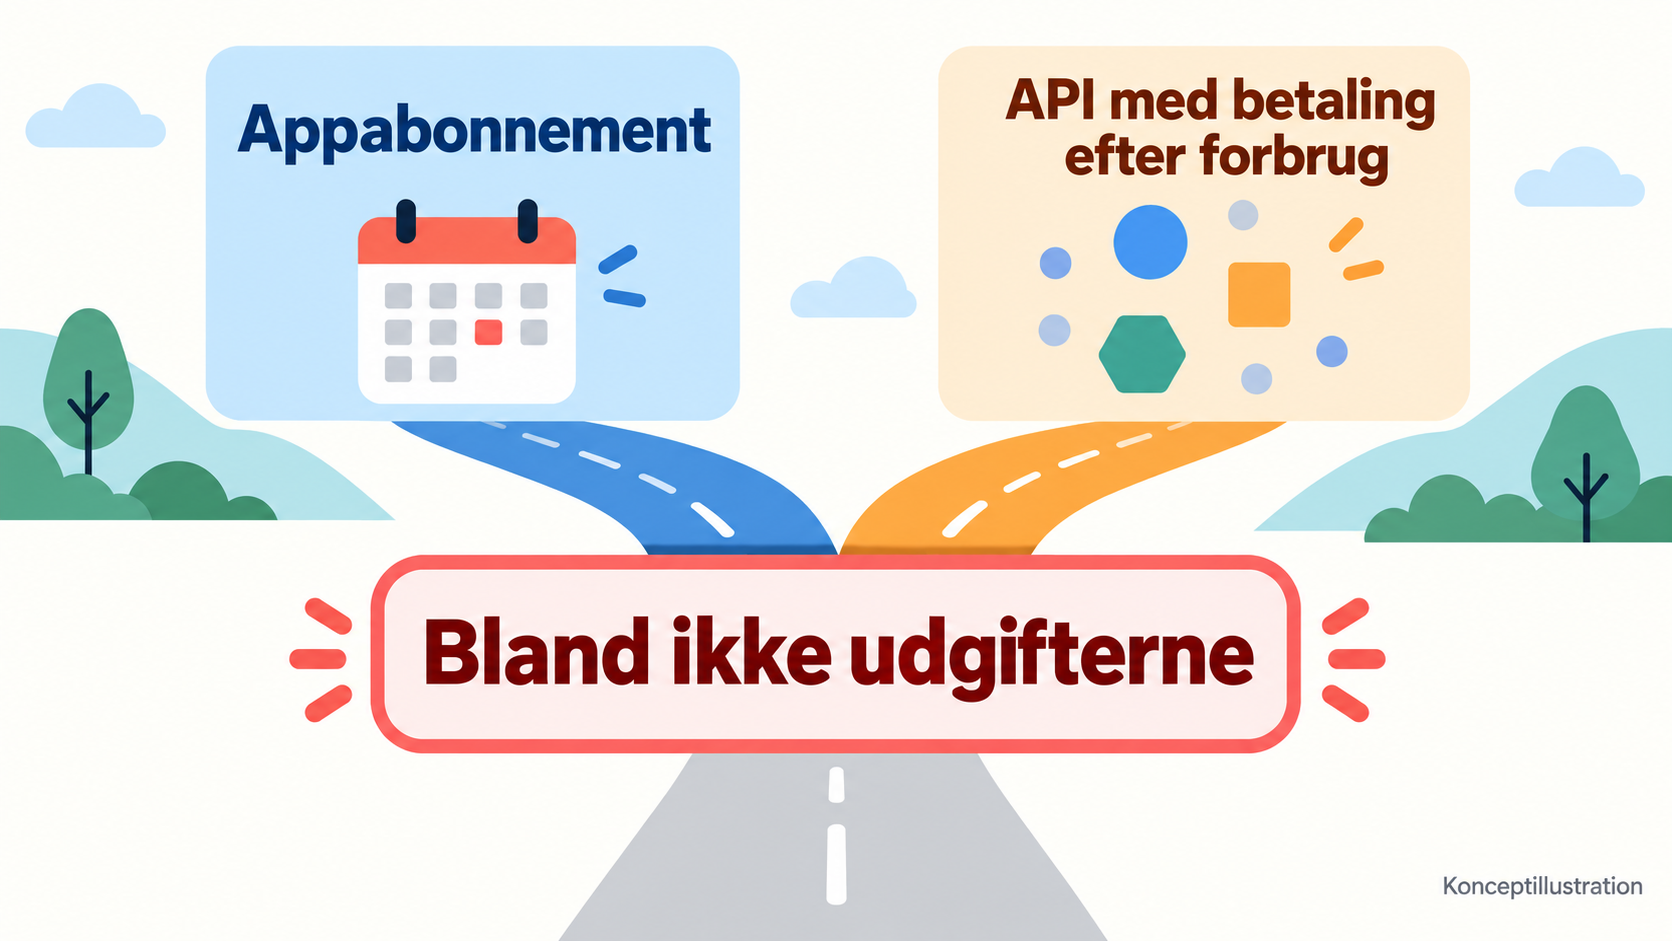
Figur: AI-genereret illustration af faktureringsgrundlag, ikke en produktregning; månedsabonnement kan ikke blandes sammen med API-enhedspris. Se billedet i fuld størrelse (1672×941).

Hvordan vælger man efter opgave? Brug først de modeller, du har til rådighed
Hvis opgaven går på tværs af flere programmer, eller kræver web browsing, betjening af grænseflader og komplekse vurderinger: prøv først GPT-6 Astra. OpenAI fremhæver computerbetjening, browsing, svær programmering og professionelle dokumenter som dens centrale kompetencer. Hvis du allerede har en passende betalt ChatGPT-konto eller API-adgang, kan du i dag give den en rigtig opgave og se, om resultatet opfylder kravene. OpenAI-modelbeskrivelse.
Hvis opgaven er programmering, kodegennemgang eller stort dokumentarbejde, der varer flere timer: prøv først Claude Fable 5.1. Anthropic positionerer den til langvarige autonome opgaver, kompleks programmering og forskning. Hvis du allerede har en Claude Code-arbejdsgang, kan du først fortsætte med de velkendte værktøjer, men du skal først bekræfte, om abonnementet trækker ekstra usage credits; hvis du skal køre mange sådanne opgaver hver dag, kan du derefter sammenligne de reelle omkostninger ved Max og API. Anthropic-modelbeskrivelse.
Vil du prøve Gemini 4 Argon: bekræft først, om du har officiel adgang. Googles offentliggjorte retninger omfatter kompleks programmering, virksomheders vidensarbejde og defensive sikkerhedsopgaver, og der er angivet foreløbige priser; det er værd at følge, men kan endnu ikke erstatte almindelige brugeres praktiske erfaringer. Hvis du ikke har adgang, anbefales det ikke at ændre en kørende arbejdsgang på grund af Argons "forventede lavere pris". Googles officielle meddelelse.
Disse anbefalinger betyder ikke, at "hvis en model er god til én type opgave, kan den kun bruges til den type". Hvis alle tre bliver tilgængelige i fremtiden, er den sikreste måde at vælge: Tag den samme virkelige opgave, giv de samme materialer og acceptkriterier, og registrer hver for sig, om den blev fuldført, manuel omarbejdelse, tidsforbrug og samlede omkostninger. En flot demonstration eller forskellige leverandørers egne benchmarkresultater kan ikke direkte bevise, at din opgave også vil få samme resultat.
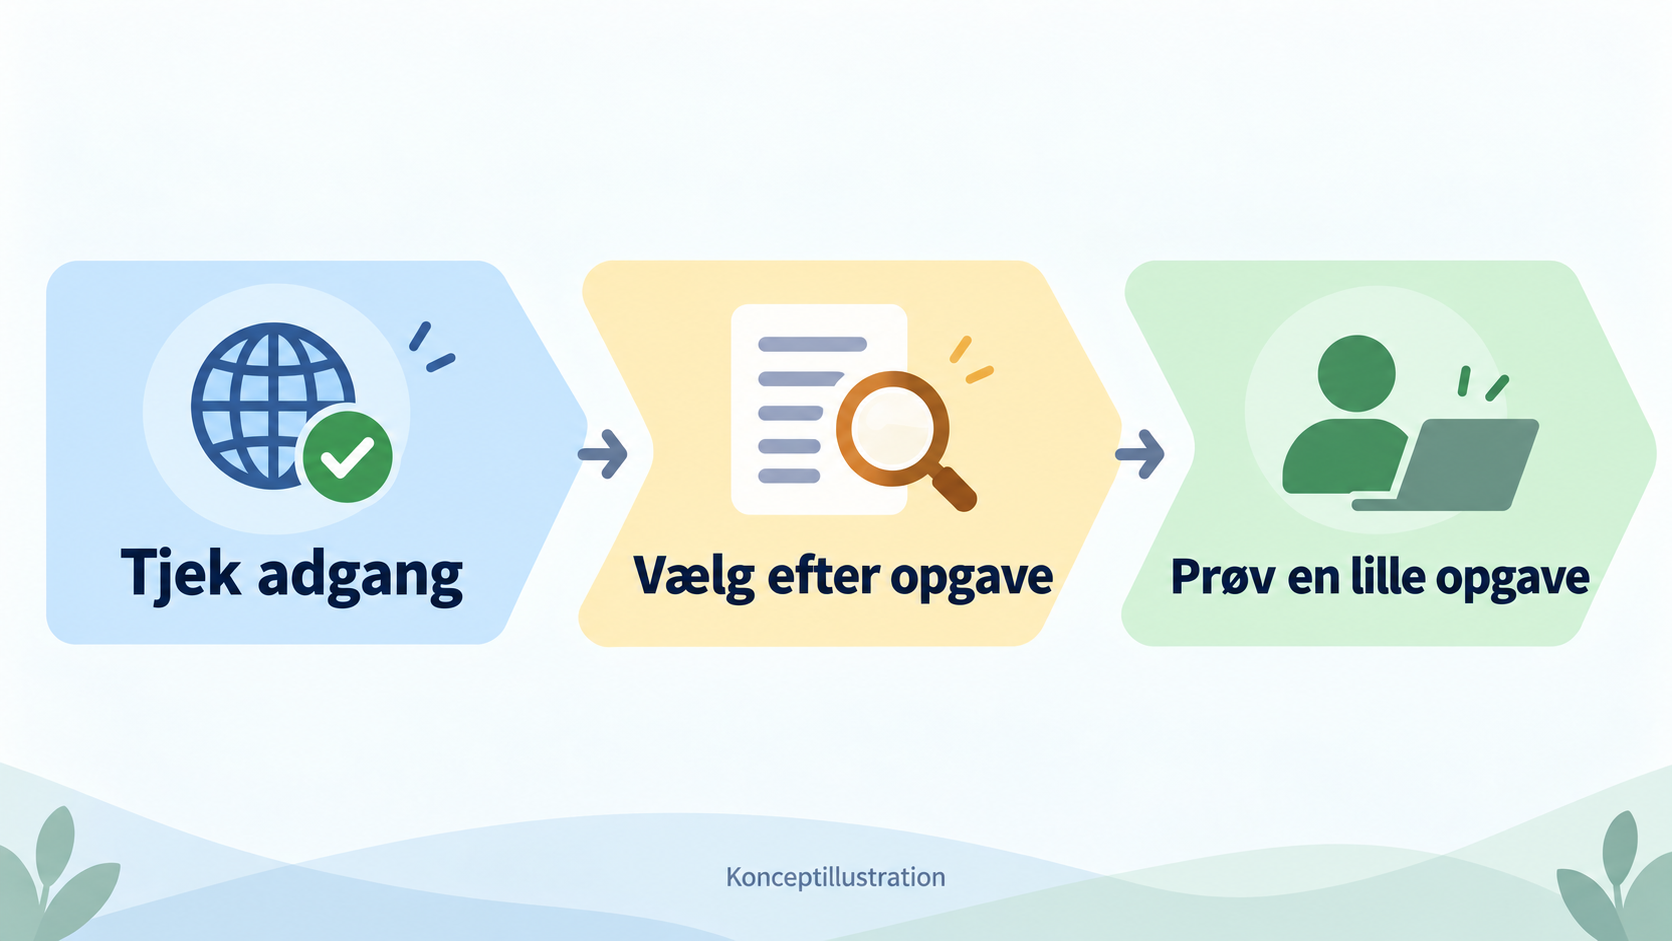
Figur: AI-genereret illustration af valgpath, se først på konto- og regional tilgængelighed, derefter på opgavebehov og til sidst verificer med din egen lille opgave. "Denne artikel udfører ingen sammenlignende tests" i figuren betyder, at vi ikke selv har kørt tests under samme betingelser; benchmarktabellen ovenfor er en gengivelse af data offentliggjort af Google. Se billedet i fuld størrelse (1672×941).

Hvis din opgave er at få to programmeringsassistenter til at dele arbejdet, kan du læse vejledningen om samarbejde mellem Claude Code og Codex; hvis du vil stille konkrete spørgsmål til en login-baseret ChatGPT Pro-side, kan du læse vejledningen om, hvordan Codex og Claude Code beder ChatGPT Pro om hjælp. Disse to artikler handler om arbejdsgangens udførelse og betyder ikke, at Gemini 4 Argon er integreret i PandaNpc.
Ofte stillede spørgsmål (FAQ)
Gemini 4 Argon er allerede officielt udgivet, hvorfor kan jeg ikke finde den?
"Udgivet" betyder, at Google har offentliggjort modellen og åbnet den for en begrænset kreds; den officielle meddelelse har endnu ikke angivet en fælles åbningsdato for alle udviklere og almindelige forbrugere. Tjek først den officielle modelliste for det Gemini-produkt og den konto, du bruger, og betragt ikke det "Gemini 4 Pro", der nævnes i rygter, som en tilgængelig indgang til Argon.
Er Astra Googles Project Astra?
Nej. GPT-6 Astra i denne artikel er en OpenAI-model; Google Project Astra er et andet forskningsprojekt og kan ikke blandes ind i pristabellen for de tre modeller.
Hvis jeg abonnerer på Claude Pro, kan jeg så bruge Fable 5.1 inden for abonnementets kvote?
Ikke nødvendigvis. Anthropics gældende abonnementsbeskrivelse siger, at Pro kræver usage credits for at bruge Fable 5.1, mens visse abonnementer som Max kan bruge den inden for en begrænset ugentlig kvote. Se din side for "forbrug/kreditter", før du betaler.
Kan man ud fra priserne ovenfor direkte afgøre, hvem der er mest økonomisk?
Nej. API-tabellen sammenligner kun listepriser; når en opgave udføres, påvirkes den også af inputlængde, om gentaget indhold rammer cachen, værktøjsomkostninger, antal kørselsrunder og omarbejdelse. Argon er især endnu ikke bredt tilgængelig, så vi kan ikke give vores egen "omkostning pr. succesfuld opgave".
Relaterede guider

GPT-6 Sol vs Claude Opus 5.5: Pris, score og kodningsopgaver – hvordan vælger man?
Prøv først GPT-6 Sol til almindelige API-programmeringsopgaver; til komplekse opgaver kan du sammenligne Claude Opus 5.5 og derefter overveje GPT-6 Astra og Claude Fable 5.1 til opgaver med høj sværhedsgrad. Denne artikel verificerer de fire modellers officielle specifikationer, cache- og Batch-priser, tredjepartsbenchmarks efter samme sammenligningsgrundlag og giver fem sæt genberegnelige omkostningsscenarier.
Læs artikel →
Claude Code vs Codex: Funktioner, fjernstyring, tilladelser og brugsscenarier – sådan vælger du (2026)
Kort sagt: Claude Code til dyb terminaladgang, Hooks og Claude-økosystemet; Codex til ChatGPT, cloudopgaver og flere Agent; PandaNpc til at fjernstyre begge på Windows, macOS, Linux og mobil.
Læs artikel →
Brug ChatGPT Pro med Codex og Claude Code i PandaNpc
I en Codex- eller Claude Code-samtale hos PandaNpc kan du give et specifikt spørgsmål videre til den ChatGPT Pro-webside, du er logget ind på, og svaret vender tilbage til den oprindelige samtale.
Læs artikel →