
Claude Code vs Codex: funkcje, zdalna kontrola, uprawnienia i przypadki użycia — jak wybrać (2026)
W skrócie: Claude Code do zaawansowanej pracy w terminalu, Hooks i ekosystemu Claude; Codex do ChatGPT, zadań w chmurze i wielu Agent; PandaNpc do zdalnego sterowania oboma na Windows, macOS, Linux i telefonie.
Konkluzja na początek: jeśli już działasz w ekosystemie Anthropic, polegasz na CLAUDE.md, Hooks, Skills i modelach Claude — wybierz Claude Code; jeśli już działasz w ekosystemie ChatGPT/OpenAI i chcesz trzymać lokalny CLI, IDE, aplikację desktopową i zadania w chmurze pod jednym kontem — wybierz Codex. Obie strony potrafią czytać i pisać kod, uruchamiać polecenia, wywoływać MCP, używać sub-agentów i zatwierdzać niebezpieczne operacje. W zwykłych zadaniach deweloperskich nie ma jednego zawsze poprawnego zwycięzcy.
Jeśli nadal nie jesteś pewien, najbardziej praktycznym podejściem nie jest patrzenie na tabelę benchmarków, ale pozwolenie obu narzędziom wykonać to samo zadanie w tym samym rzeczywistym repozytorium: ustal wersje, te same kryteria akceptacji, porównaj, czy rozumieją reguły projektu, czy zakres zmian jest kontrolowany, czy testy są kompletne i ile razy musisz interweniować.
Ujawnienie interesów: Rozwijamy PandaNpc, zdalny system łączący Claude Code, Codex i inne lokalne agenty. Różnice protokołów w drugiej części artykułu pochodzą z rzeczywistych doświadczeń integracyjnych; nie przeprowadziliśmy kontrolowanych benchmarków możliwości modeli, więc nie będziemy twierdzić, że któraś strona „koduje o ileś szybciej” czy „ma o ileś wyższą skuteczność”. Codex w tym artykule oznacza OpenAI Codex, a nie inny produkt o tej samej nazwie.
Data weryfikacji materiałów: 30 sierpnia 2026. Obie strony aktualizują się bardzo szybko; w przypadku zmiennych funkcji obowiązują oficjalna dokumentacja Claude Code i oficjalna strona OpenAI Codex.
Tabela: kluczowe różnice między Claude Code a Codex
| Wymiar | Claude Code | OpenAI Codex |
|---|---|---|
| Główny ekosystem kont | Claude / Anthropic | ChatGPT / OpenAI |
| Wejście lokalne | CLI, aplikacja desktopowa, rozszerzenia IDE | CLI, Codex w desktopowym ChatGPT, rozszerzenia IDE |
| Wejście chmurowe | Claude Code on the web, Slack, CI itd. | Codex Web/Cloud, Slack, SDK, przepływy pracy GitHub itd. |
| Długoterminowy opis projektu | CLAUDE.md, Rules, Skills |
AGENTS.md, Skills, konfiguracja projektu |
| Narzędzia zewnętrzne | MCP, wtyczki, Hooks, Channels | MCP, wtyczki, Skills, SDK |
| Praca równoległa | Sub-agenci, Agent teams, sesje worktree | Wiele agentów, wbudowane worktree, równoległe zadania w chmurze |
| Granice uprawnień | Tryby uprawnień, Hooks, sandbox i polityki organizacyjne | Polityki zatwierdzania, sandbox na poziomie systemu, reguły i polityki organizacyjne |
| Oficjalne zdalne sterowanie z telefonu | Claude App i claude.ai/code kontrolują lokalne sesje CLI/VS Code |
Wejście Remote w ChatGPT Mobile kontroluje obsługiwane sesje Codex na pulpicie |
| Dla kogo lepsze | Zespoły, które przyjęły przepływy Claude i potrzebują głębokiej automatyzacji cyklu życia | Zespoły, które przyjęły ChatGPT/OpenAI i potrzebują powiązania zadań lokalnych z chmurowymi |
Ta tabela porównuje przepływy pracy, a nie ranking modeli. Wersje modeli, okna kontekstu, szybkość i limity się zmieniają; zapisanie przewagi modelu z danego momentu jako „ten agent jest zawsze lepszy” zwykle dezaktualizuje się po kilku tygodniach.
Claude Code vs Codex: wybierz bezpośrednio według swojego przypadku
Wybierz Claude Code, jeśli bardziej zależy Ci na tych aspektach
- Projekt jest już zorganizowany wokół Claude. W repozytorium są już
CLAUDE.md, Rules, Skills, Subagents lub Hooks; koszt ich migracji jest znacznie większy niż zmiana nazwy modelu. - Potrzebujesz szczegółowej automatyzacji cyklu życia. Hooki Claude Code mogą wymuszać kontrole przy takich zdarzeniach jak wywołania narzędzi, prośby o uprawnienia, modyfikacje plików, kompresja i zakończenie sesji; bramki bezpieczeństwa wymagające „wykonania za każdym razem” łatwiej umieścić poza agentem.
- Korzystasz głównie z modeli Claude i konta Anthropic. Konto, limity, polityki zarządzania i istniejące sesje pozostają w jednym systemie.
- Chcesz sterować lokalnym CLI bezpośrednio z przeglądarki. Oficjalna funkcja Remote Control wyraźnie obsługuje przejmowanie lokalnych sesji CLI lub VS Code przez Claude App i
claude.ai/code.
Wybierz Codex, jeśli bardziej zależy Ci na tych aspektach
- Zespół już korzysta z ChatGPT/OpenAI. Codex CLI, IDE, wersja desktopowa i zadania w chmurze mogą współdzielić tożsamość ChatGPT i polityki przestrzeni roboczej.
- Często zlecasz zadania do wykonania w tle w chmurze. Codex umieszcza interakcję lokalną i delegowanie do chmury w jednym ekosystemie produktu — dobrze nadaje się do asynchronicznych PR-ów, przeglądów kodu, migracji i utrzymania zbiorczego.
- Chcesz zarządzać wieloma równoległymi zadaniami w jednym interfejsie. Aplikacja Codex kładzie nacisk na wbudowane worktree i przepływy wieloagentowe — dobrze nadaje się do jednoczesnego rozdzielania zadań, śledzenia postępu i scalania wyników.
- Potrzebujesz SDK lub wejścia automatyzacji. Oprócz
codex execw CLI, OpenAI oferuje Codex SDK, Slack oraz wejścia przepływów GitHub — dobrze nadaje się do osadzenia agenta w istniejących systemach inżynieryjnych.
Używanie obu narzędzi jest również w pełni uzasadnione
Duże zadania i prawdziwe zespoły rzadko zależą wyłącznie od możliwości modeli. Możesz pozwolić Claude Code obsługiwać repozytoria, w których osadzone są już Hooki/Skille Claude, a Codexowi zlecić zadania chmurowe w przestrzeni roboczej OpenAI; albo w tym samym repozytorium przeprowadzać wzajemny przegląd zmian wysokiego ryzyka. Czego naprawdę należy unikać: obie strony modyfikujące ten sam checkout bez worktree, granic zadań i osoby odpowiedzialnej za finalne scalenie.
Jakość kodowania i możliwości modeli: dlaczego ten artykuł nie wyznacza stałego zwycięzcy
„Czy Claude Code czy Codex pisze lepszy kod?” to najczęstsze pytanie i jednocześnie najłatwiejsze do błędnego udzielenia odpowiedzi. Wyniki agenta zależą jednocześnie od wersji modelu, intensywności rozumowania, kontekstu, instrukcji repozytorium, uprawnień narzędzi, szybkości testów i typu zadania. Pojedyncze przypadkowe pytanie nie reprezentuje długoterminowych wyników, a studia przypadków pokazywane przez producentów nie zastąpią akceptacji we własnym repozytorium.
Zalecamy porównanie na zestawie rzeczywistych zadań:
- modyfikacja funkcji obejmująca 3–5 plików;
- bug z niezaliczającym się testem;
- przegląd kodu tylko do odczytu;
- zadanie wymagające sprawdzenia dokumentacji, uruchomienia testów i wyjaśnienia kompromisów.
Zanotuj wskaźnik pierwszego sukcesu, modyfikacje wykraczające poza zakres, dowody z testów, liczbę poprawek ręcznych i łączny czas. Nie porównuj tylko tego, czyja finalna odpowiedź wygląda na mądrzejszą.
Wersja darmowa a subskrypcja: najpierw rozróżnij limity agentów i uprawnienia do zdalnej kontroli
„Czy darmowa wersja działa?” tak naprawdę obejmuje dwa różne rozliczenia: pierwsze to limit użycia modeli i agentów Claude/Codex; drugie to limit klientów zdalnych, urządzeń online i równoległych sesji. PandaNpc rozwiązuje tylko drugą warstwę połączeń — nie dołącza subskrypcji modeli Anthropic ani OpenAI.
| Produkt | Zakres darmowy | Zakres płatny/subskrypcja | Najczęstsze nieporozumienie |
|---|---|---|---|
| Claude Code | CLI może korzystać z Anthropic API Key lub obsługiwanych dostawców chmurowych z płatnością za zużycie; zwykłe Claude Free nie oznacza posiadania oficjalnej funkcji Remote Control | Pro, Max, Team, Enterprise mogą uruchamiać Claude Code w ramach subskrypcji; Remote Control obecnie wymaga jednej z tych płatnych subskrypcji | Claude Code sam w sobie obsługuje nie tylko subskrypcję, ale oficjalna funkcja Remote Control wymaga zalogowania przez płatną subskrypcję Claude.ai; nie obsługuje API Key, Bedrock, Vertex ani Foundry |
| Codex | OpenAI od czasu do czasu udostępnia Free/Go ograniczone czasowo limity Codex, w zależności od bieżącej promocji i konta; nie można tego traktować jako stałego świadczenia | Plany Plus, Pro, Business, Enterprise, Edu itd. umożliwiają korzystanie z Codex CLI, IDE, Web/Cloud i obsługiwanych przepływów aplikacji; limity i równoległość zmieniają się w zależności od planu | Codex Remote zależy również od wersji aplikacji desktopowej, tej samej przestrzeni roboczej ChatGPT, autoryzacji urządzeń oraz polityk administratora/RBAC |
| PandaNpc | Free: maksymalnie 2 urządzenia agentów online, 5 równoległych sesji agentów; dostępne połączenia takie jak zdalna kontrola Claude Code, Codex, prywatna sieć urządzeń, MCP | VIP: 10 urządzeń / 10 sesji; SVIP: 50 urządzeń / 50 sesji, plus wyższe limity innych produktów | Członkostwo PandaNpc rozszerza połączenia i równoległość, ale nie płaci za zużycie Claude, ChatGPT, API ani modeli niestandardowych |
Na dzień 30 sierpnia 2026 strona wymagań Remote Control firmy Anthropic wymienia uprawnienia: Pro, Max, Team, Enterprise i wyraźnie wyklucza API Key; w Team/Enterprise może być też wymagane włączenie przez administratora. OpenAI prowadziło ograniczone czasowo udostępnianie dla Free/Go, więc „darmowa dostępność” Codex musi być sprawdzana na bieżącym stanie konta — nie można jej zapisać jako stałej obietnicy. Aktualne poziomy i ceny PandaNpc znajdują się na stronie członkowskiej; zużycie modeli i subskrypcja członkowska to dwa niezależne rozliczenia.
Czym różni się zdalna kontrola między Claude Code a Codex
Łączy je to, że kod i narzędzia nadal działają na hoście, a telefon jest tylko interfejsem sterowania; gdy host przejdzie w stan uśpienia, zostanie wyłączony lub straci sieć, żadne z nich nie może kontynuować zadań lokalnych. Ale dwa oficjalne wejścia nie są obecnie symetryczne.
| Możliwość zdalna | Claude Code Remote Control | Codex Remote | PandaNpc |
|---|---|---|---|
| Obiekt kontroli | Lokalne sesje Claude Code CLI lub VS Code | Obsługiwane sesje Codex w desktopowym ChatGPT/Codex | Claude Code, Codex CLI, PandaCode, harness DeepSeek, Pi itd. na hoście |
| System hosta | Lokalne hosty obsługiwane przez Claude Code | Skupia się na desktopowym ChatGPT na macOS/Windows | Windows, macOS, Linux, serwery i kontenery deweloperskie |
| Uruchamianie/parowanie | claude remote-control, claude --remote-control, /remote-control |
Ustawienia desktopowe zezwalają na wykrywanie i kontrolę; autoryzacja urządzenia przez tę samą przestrzeń roboczą ChatGPT | Instalacja PandaPaw na hoście i zalogowanie konta lub dołączenie bez nadzoru za pomocą jednorazowego klucza urządzenia |
| Wejście z telefonu | Strona Code w aplikacji Claude | Zakładka Remote w ChatGPT Mobile | PandaNpc iOS, przeglądarka mobilna |
| Wejście z przeglądarki | claude.ai/code może kontrolować sesje lokalne |
Oficjalna pomoc obecnie mówi, że Codex nie można wybrać bezpośrednio w Web/Mobile; Remote jest przeznaczony głównie do łączenia urządzeń mobilnych z sesjami desktopowymi | Strona /agent może kontrolować wszystkie podłączone silniki |
| Desktop do desktop | Dowolna przeglądarka może wejść na claude.ai/code |
Oficjalne Remote nie jest równoznaczne z dostępem projektowym desktop-do-desktop; między desktopami zwykle używa się SSH/projektów zdalnych | Klienty desktopowe Windows/macOS/Linux współdzielą tę samą listę połączeń |
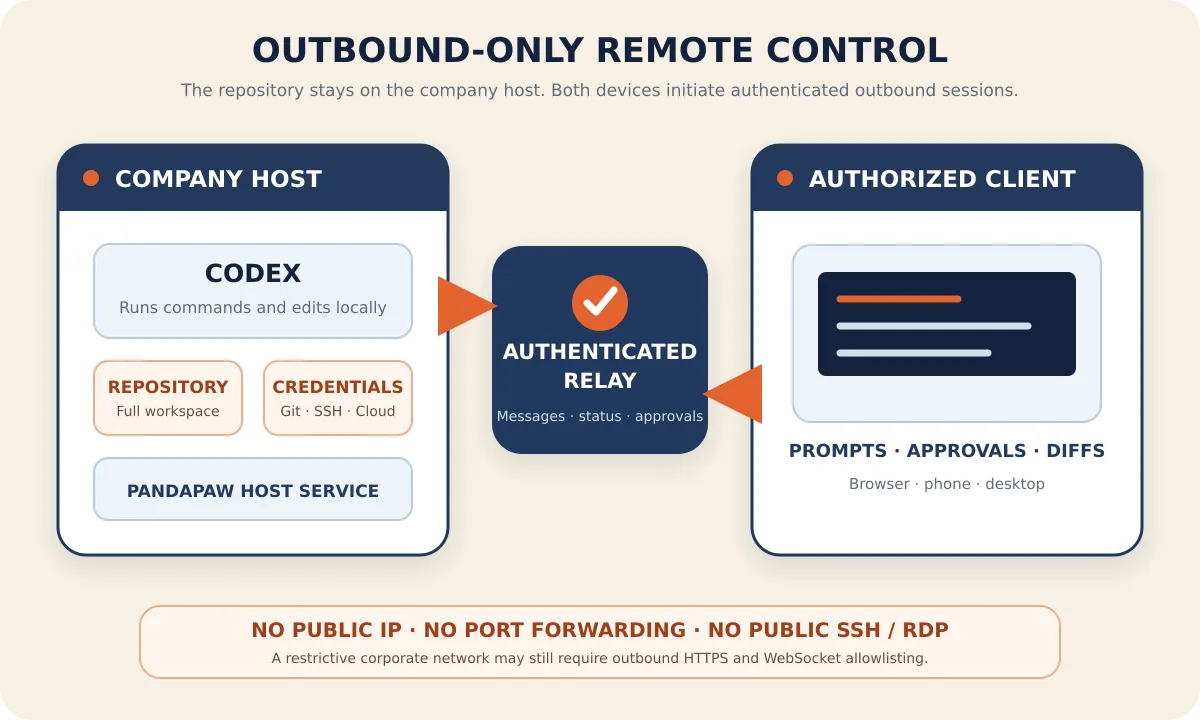
| Lokalne pliki i narzędzia | Pozostają na hoście Claude Code, z zachowaniem lokalnego MCP i konfiguracji | Pozostają na hoście desktopowego Codex | Pozostają na hoście każdego agenta; zdalnie przesyłane są tylko wiadomości, status, Diff i zatwierdzenia |
| Nowa sesja | Tryb server może tworzyć sesje na wskazanym hoście zdalnie | Skupia się na autoryzowanych urządzeniach i obsługiwanych sesjach desktopowych; możliwości zmieniają się wraz z wersją aplikacji | Można wybrać maszynę, silnik i katalog roboczy, aby utworzyć lub wznowić sesję |
| Ograniczenia konta oficjalnego | Płatna subskrypcja Claude.ai; API Key i dostawcy zewnętrzni nie mogą korzystać z oficjalnego Remote Control | To samo konto/przestrzeń robocza ChatGPT; możliwe ograniczenia planu, administratora i RBAC | Konto PandaNpc odpowiada za połączenie; uwierzytelnianie modeli nadal używa własnych subskrypcji/API/dostawców poszczególnych silników na hoście |
| Wiele silników/maszyn | Tylko Claude Code; każdy host rejestrowany osobno | Tylko Codex; skoncentrowany na urządzeniach ChatGPT/Codex | Jedno konto zarządza wieloma silnikami, maszynami, prywatną siecią urządzeń i statusem online |
| Publiczny port przychodzący | Niewymagany | Niewymagany | Niewymagany; host i klient oba aktywnie łączą się z uwierzytelnionym przekaźnikiem, prywatna sieć urządzeń preferuje bezpośrednie połączenie |
| Darmowe korzystanie | Oficjalne Remote Control nie obsługuje Claude Free | Free/Go mogą mieć okresowe limity; uprawnienia Remote zależą od faktycznego stanu konta | Free obsługuje 2 urządzenia agentów online i 5 równoległych sesji; nadal wymagane są własne kwalifikacje modeli z góry |
Claude Code Remote Control bardziej przypomina „udostępnienie lokalnej sesji CLI dla Claude Web/Mobile”; oficjalna dokumentacja Codex Remote bardziej przypomina „łączenie się z obsługiwaną sesją desktopową Codex z ChatGPT Mobile”. Jeśli potrzebujesz także dostępu z innego komputera desktopowego, ujednoliconego wejścia przeglądarkowego, hosta Linux, modeli niestandardowych lub jednoczesnego zarządzania Claude Code i Codex CLI, potrzebujesz dodatkowej warstwy połączeń zdalnych.
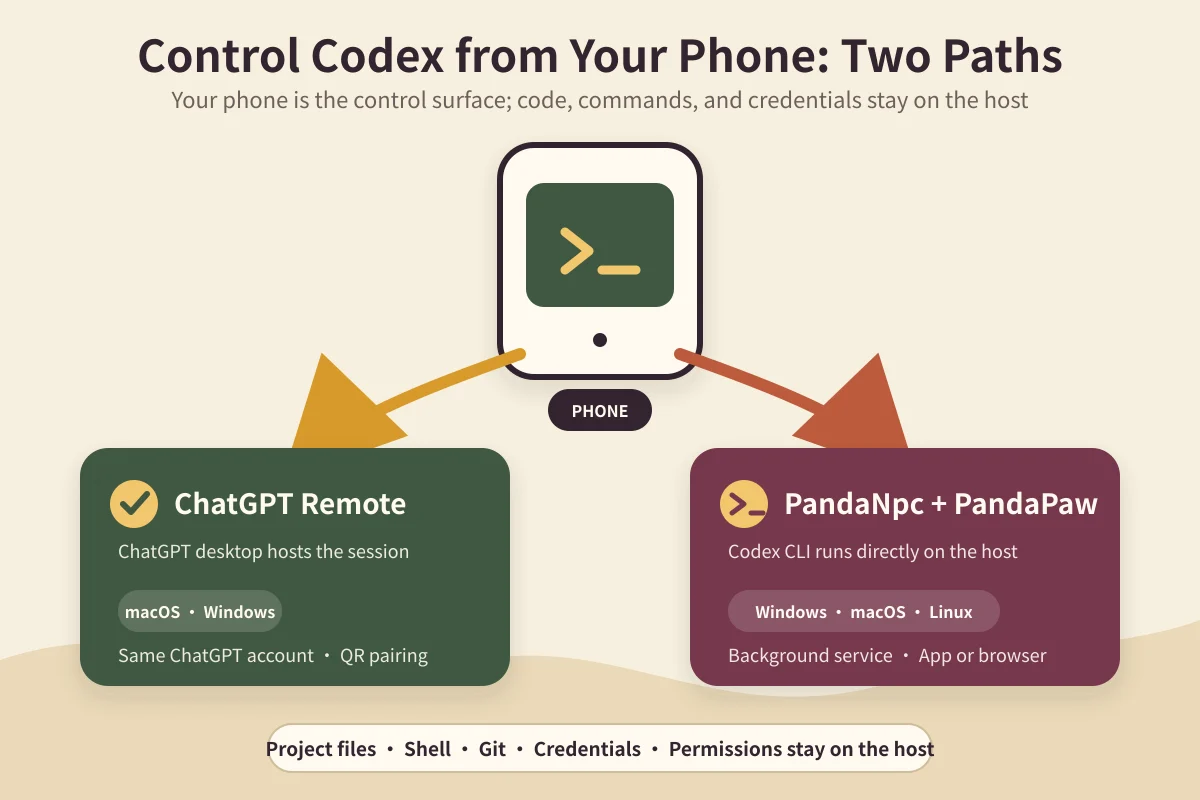
Podejście PandaNpc polega na uruchomieniu PandaPaw obok hosta i ujednoliconym wystawieniu połączeń Claude Code, Codex, PandaCode itd. dla przeglądarki, iOS i klientów desktopowych. Obie strony nawiązują tylko połączenia wychodzące — nie trzeba otwierać publicznych portów agentów; wykonywanie narzędzi nadal pozostaje na hoście.
Pełniejsze oficjalne kroki zdalne / kroki PandaNpc znajdują się odpowiednio w przewodniku Claude Code Remote Control i przewodniku zdalnej kontroli Codex na telefonie.
Jak porównać uprawnienia, MCP i możliwości dostosowywania
Obie strony mogą łączyć się z MCP i oferują narzędzia do plików, Shell, wyszukiwania i łatek; prawdziwa różnica leży w „jak ograniczane są narzędzia” i „gdzie przechowywane są reguły projektu”.
- Claude Code:
CLAUDE.mdzapewnia stały kontekst projektu, Skills ładują przepływy pracy, Hooki wykonują deterministyczne bramki w punktach cyklu życia, a Subagents/Agent teams zapewniają izolację i pracę równoległą. - Codex:
AGENTS.mdi Skills wyrażają reguły projektu, polityki zatwierdzania i sandbox systemowy kontrolują uprawnienia lokalne, App/Cloud zapewniają zadania równoległe i worktree, a SDK podłącza tego samego agenta do systemów automatyzacji.
Jeśli zespołowi najbardziej zależy na tym, aby „każdy agent musiał przejść ten sam zestaw kontroli”, nie zapisuj wymagań tylko w promptach. Umieść testy, blokowanie niebezpiecznych poleceń, skanowanie kluczy i autoryzację wdrożeń w Git, CI, sandboxie, Hookach lub innej zewnętrznej warstwie wymuszającej — oba agenty będą mogły pracować wyłącznie w tych granicach.
Część pogłębiona: dlaczego nie można współdzielić jednego adaptera przy podłączaniu obu silników do tego samego systemu
Zanim omówimy różnice, trzeba jasno powiedzieć: modele mentalne obu narzędzi są bardzo podobne — oba działają w terminalu, oba opierają się na sesjach, oba potrafią wywoływać narzędzia, modyfikować pliki i uruchamiać polecenia, oba wymagają potwierdzenia niebezpiecznych operacji przez użytkownika i oba potrafią przetwarzać wieloetapowe zadania w jednej sesji. Właśnie dlatego przy integracji łatwo dojść do wniosku „wystarczy napisać jedną warstwę adaptera” — i tak właśnie zaczęliśmy.
Różnice nie leżą w warstwie możliwości, lecz w warstwie protokołu. To znaczy: zachowanie widoczne w terminalu może być niemal identyczne, ale emitowane przez nie ramki, kolejność ramek i organizacja pól różnią się. To właśnie powód, dla którego takie różnice trudno wykryć z wyprzedzeniem: używając narzędzi na własnym komputerze, nigdy na nie nie trafisz.
Szybka tabela siedmiu różnic protokołów
| # | Wymiar | Zachowanie Claude Code | Zachowanie Codex | Kogo ugryzie brak obsługi |
|---|---|---|---|---|
| 1 | Identyfikator wiadomości asystenta | Ma stabilne id | Może go nie mieć | Osoby robiące persistencję wiadomości / synchronizację między urządzeniami |
| 2 | Sprawdzanie żywotności sesji | Forma zbiorcza, jedna partia naraz | Oczekuje pojedynczego id sesji | Osoby robiące wyświetlanie statusu online |
| 3 | Kolejność odtwarzania historii | Zgodna z rzeczywistą chronologią | Ramki aktywności wątków podrzędnych umieszczane całą partią na końcu | Osoby robiące widoki sub-agentów / wielowątkowe |
| 4 | Struktura poleceń wywołań narzędzi | Kompletna | Może być rozdrobniona | Osoby robiące UI zatwierdzania narzędzi |
| 5 | Subskrypcja zdarzeń kanału | Pełni rolę wykonawcy przełączania sesji | Nie może jednocześnie wykonywać przełączania | Osoby robiące multi-relay |
| 6 | Limit połączeń online | Współdzieli tę samą pulę liczników z Codex | Tak samo | Osoby robiące limity |
| 7 | Wydajność przy długiej historii | Liniowa | Przy złym przetwarzaniu degeneruje się do nieliniowej | Osoby robiące aplikacje mobilne |
Poniżej omawiamy każdą pozycję według schematu „objawy → jak zdiagnozować → jak naprawić”.
1. Czy wiadomości asystenta mają stabilne id — to określa twoją strategię deduplikacji
Objawy: Otwierasz sesję Codex — zaraz po rozmowie wszystko jest w porządku; po wyjściu i ponownym wejściu ta sama odpowiedź asystenta pojawia się jako 2, 3 wpisy, a przy kolejnych wejściach coraz więcej. Wiadomości użytkownika nie są dotknięte — mnożą się tylko odpowiedzi asystenta. W sesjach Claude Code to nie występuje.
Jak zdiagnozować: Ten objaw jest bardzo łatwy do błędnej oceny jako problem renderowania po stronie klienta lub zduplikowanego ładowania historii, po czym zaczyna się grzebanie we frontendzie. Prawidłowy pierwszy krok to sprawdzenie, ile wpisów faktycznie znajduje się w cache serwera — jeśli w cache rzeczywiście jest N wpisów, problem leży w warstwie danych, a nie w renderowaniu. Właśnie ten krok wyprowadził nas wtedy z kierunku klienta.
Przyczyna źródłowa: Wiadomości asystenta w Claude Code mają stabilny identyfikator, więc przy odtwarzaniu historii i dostarczaniu w czasie rzeczywistym można je deduplikować bezpośrednio po id. Wiadomości asystenta po stronie Codex nie gwarantują takiego identyfikatora — przy zastosowaniu tej samej logiki „deduplikacji po id” ta sama odpowiedź jest zapisywana jako dwie różne wiadomości.
Jak naprawić: Dla wiadomości bez stabilnego id zastosuj składanie oparte na „kotwicy rundy + treści” — kotwicą jest hash najbliższej wiadomości użytkownika poprzedzającej tę odpowiedź.
⚠️ Jest tu pułapka, którą warto omówić osobno: nasza pierwsza wersja składała według czystego tekstu; po wdrożeniu, podczas skanowania danych historycznych odkryliśmy, że błędnie usunęła 691 identycznych odpowiedzi z różnych rund. Powód: krótkie odpowiedzi Codex mają bardzo wysoką powtarzalność („OK.”, „Zrobione.” itp.), a zbiór deduplikacji był na poziomie sesji — gdy raz zapisano hash danego zdania, każde kolejne wystąpienie tego samego zdania w dowolnej późniejszej rundzie tej sesji było połykane. To była utrata treści, poważniejsza niż duplikacja. Warstwy kotwicy nie można pominąć.
2. Sprawdzanie żywotności: jedno wymaga pojedynczej pozycji, drugie partii
Objawy: Sesja wyraźnie działa, ale interfejs pokazuje offline.
Jak zdiagnozować: Ta różnica wygląda, jakby można ją było uogólnić — nazwy pól po obu stronach są podobne, więc przy pisaniu łatwo uznać, że jeden kod obsłuży obie. Metoda jest prosta: wyślij strukturę zbiorczą i sprawdź, czy odpowiedź ma oczekiwany kształt.
Przyczyna źródłowa: Interfejsy do sprawdzania „czy sesja nadal żyje” różnią się po obu stronach. Po stronie Claude Code używamy formy zbiorczej — jednym razem wysyłamy zestaw id sesji; strona Codex oczekuje pojedynczego id sesji.
Jak naprawić: Rozdziel dwie ścieżki wywołań — nie próbuj ich współdzielić. Sama różnica nie jest trudna do obsłużenia; problem w tym, że nie zgłasza błędu — wysłanie złej struktury nie rzuca wyjątku, tylko zwraca odpowiedź o błędnym znaczeniu.
3. Różna kolejność ramek w odtwarzaniu historii — stan sub-agenta się zacina
To najbardziej zawiły punkt w procesie debugowania.
Objawy: Kropka stanu sub-agenta na pasku bocznym cały czas pulsuje na pomarańczowo („uruchomiony”), mimo że faktycznie już dawno się zakończył lub został przerwany. Odświeżenie strony też nie pomaga — każde odświeżenie powtarza problem. Występuje tylko w sesjach Codex.
Jak zdiagnozować: „Odświeżenie też nie pomaga” to kluczowe kryterium. Oznacza, że problem nie leży w dostarczaniu w czasie rzeczywistym, lecz w samym odtwarzaniu historii — każde odtworzenie ponownie zapisuje stan błędnie.
Przyczyna źródłowa: Podczas odtwarzania najpierw rozkładane są wszystkie wpisy wątku rodzica (w tym ramki powiadomień oznaczające „sub-agent zakończony”), a następnie ramki aktywności każdego wątku podrzędnego są dopisywane całą partią na końcu. Klient otrzymuje więc kolejność: najpierw powiadomienie „przerwano”, a dopiero później wcześniejsze chronologicznie ramki aktywności. Logika zapisująca stan nie porównuje znaczników czasu, więc ostatnia partia wcześniejszych ramek bezwarunkowo nadpisuje stan końcowy z powrotem na „uruchomiony”.
Jak naprawić: Dodaj w gałęzi zapisu stanu strażnika stanu końcowego — wpis, który już jest w stanie końcowym (ukończony/niepowodzenie/zatrzymany), może zostać nadpisany tylko przez nowszą ramkę. Uważaj, aby kryterium korzystało z tego samego mapowania stanów co reszta kodu — nie pisz osobnego, bo w przeciwnym razie dwa miejsca zaczną się różnić w rozumieniu „co jest stanem końcowym”.
Wspólna cecha tego typu problemów: każda ramka z osobna jest poprawna — błąd tkwi w ich względnej kolejności. Dlatego patrzenie na logi pojedynczych ramek nigdy nie ujawni problemu.
4. Struktura poleceń wywołań narzędzi: ulega fragmentacji
Objawy: Na kartach narzędzi w sesji Codex polecenia wyświetlają się jako fragmenty w rodzaju 1,220p lub /pid=…/ {print}; czasami cały skrypt jest pocięty, a nawet po zakończeniu odpowiedzi wiszą karty narzędzi bez domknięcia.
Jak zdiagnozować: Patrz na rzeczywistą strukturę pola polecenia w surowych ramkach, nie na wynik renderowania. Jeśli sięgasz po „jakie polecenie wykonał użytkownik” ścieżką pól z Claude Code, dostajesz pocięte fragmenty.
Jak naprawić: Napisz osobną warstwę rekompozycji poleceń dla Codex — scal fragmenty z powrotem w pełne polecenie i dopiero wtedy przekaż do UI.
Ta różnica jest szczególnie dotkliwa dla osób robiących zatwierdzanie narzędzi: użytkownik ma na telefonie kliknąć „Zezwól / Odrzuć”, a polecenie na karcie jest pocięte — to jak podpisywanie w ciemno. Funkcja bezpieczeństwa tracąca sens jest znacznie poważniejsza niż brzydki wygląd.
5. Różny zakres subskrypcji zdarzeń kanału
Objawy: Dwóch użytkowników wylogowuje siebie nawzajem.
Przyczyna źródłowa: Jeśli oba łącza relay subskrybują i wykonują zdarzenia typu „przełączanie sesji”, każda strona wyloguje jedną ofiarę, tworząc podwójne wyrzucenie. Akcja przełączania musi mieć dokładnie jednego wykonawcę.
Jak naprawić: Nasze rozwiązanie: łącze Codex subskrybuje tylko zdarzenia wylogowania i unieważnienia cache, nigdy zdarzeń przełączania — prawo wykonania przełączania jest przypisane na stałe do drugiego łącza.
Tego rodzaju decyzje „celowo czegoś nie robimy” zostawiają w kodzie zwykle tylko jeden komentarz, ale powstają dopiero po nadepnięciu na problem — a gdy późniejszy programista „przy okazji uzupełni” to ograniczenie, awaria wróci. Dlatego w komentarzu trzeba jasno napisać, dlaczego się tego nie robi, a nie tylko że się nie robi.
6. Limity i liczenie połączeń są scal
Objawy: Użytkownik myśli, że ma jeszcze limit, a faktycznie już przekroczył.
Przyczyna źródłowa: Jeśli, tak jak my, ograniczasz liczbę połączeń online, uważaj: połączenia obu silników trafiają do tej samej puli liczników. Gdy użytkownik ma jednocześnie otwarte sesje Claude Code i Codex, zajmują one tę samą porcję limitu.
To nie jest wada, lecz decyzja projektowa — z perspektywy użytkownika „ile łącznie sesji mogę mieć otwartych jednocześnie” jest łatwiejsze do zrozumienia niż „ile mogę otworzyć dla każdego silnika”. Jeśli jednak twoja implementacja liczy osobno dla każdego silnika, saldo pokazywane we frontendzie nie będzie się zgadzać z faktycznym odjęciem po stronie backendu.
Jak naprawić: Najpierw zdecyduj, którą miarę chcesz, a potem zapewnij, że frontend i backend używają tej samej. Mieszanie dwóch miar jest gorsze niż wybranie błędnej.
7. Różne cechy wydajności przy rosnącej historii
Objawy: Aplikacja mobilna zawiesza się przy otwieraniu sesji z długą historią.
Przyczyna źródłowa: Na iOS napotkaliśmy wyraźne zawieszenie, którego przyczyną była operacja w przetwarzaniu historii o złożoności kwadratowej względem liczby wiadomości. Trzeba podkreślić: to nie jest problem samego silnika, lecz niedopasowanie jego struktury historii do naszego wcześniejszego sposobu przetwarzania — ten sam sposób przetwarzania nie ujawnił się na drugim silniku.
Jak naprawić: Zamień powtarzane skanowanie rosnące z liczbą wiadomości na jednorazowy indeks. Ważniejsze jest jednak projektowanie z wyprzedzeniem: długa historia musi być uwzględniona od początku — nie można czekać, aż użytkownik zgromadzi kilka tysięcy wiadomości, żeby to odkryć.
Dla integratorów platform: którą stronę łatwiej podłączyć
Zastrzeżenie: poniższe zalecenia wynikają z perspektywy integracji, nie są oceną możliwości kodowania. Nie przeprowadzaliśmy porównawczych testów benchmarkowych; żadne stwierdzenie w rodzaju „ktoś jest o ileś szybszy” nie pochodzi z tego artykułu.
Kiedy lepiej wybrać Codex
- Twój zespół jest już w ekosystemie OpenAI — konto, limity i rozliczenia w jednym miejscu, o jedną warstwę mniej zarządzania finansami i poświadczeniami. Tego oszczędzenia nie należy lekceważyć.
- Twoje procesy są już zbudowane wokół jego modelu sesji i zadań — refaktoryzacja narzędzi peryferyjnych dla migracji zwykle się nie opłaca; siedem różnic powyżej to w odwróceniu koszt migracji.
Kiedy lepiej wybrać Claude Code
- Chcesz sam budować narzędzia peryferyjne — z naszego doświadczenia integracyjnego wynika, że stabilne identyfikatory wiadomości znacznie ułatwiają persistencję i synchronizację między urządzeniami; pierwsza, trzecia i czwarta różnica są łatwiejsze do obsłużenia właśnie po tej stronie.
- Chcesz robić interakcje typu zatwierdzanie narzędzi — struktura poleceń jest kompletna, przy budowie UI zatwierdzania nie trzeba dodatkowo składać fragmentów, więc nie ma ryzyka „podpisywania w ciemno”.
Jeśli chcesz tylko zmienić model, nie musisz zmieniać agenta
Jeśli twoim celem jest tylko „zmienić model dla tej samej interakcji”, lepiej wymienić backend modelu niż silnik. Częściowo właśnie dlatego stworzyliśmy PandaCode: warstwa interakcji pozostaje bez zmian, a model zostaje wymieniony.
Jeśli migrujesz: nakład zmian odpowiadający siedmiu różnicom
Wiele osób szuka tych dwóch nazw, bo tak naprawdę ocenia: „ile zapłacę za przejście z jednego na drugie”. Poniżej przeliczamy siedem różnic na koszt migracji.
Zastrzeżenie: Ta sekcja to nakład zmian wyprowadzony z poprzednich siedmiu różnic, a nie zapis pełnej migracji, którą przeprowadziliśmy — nasza droga to „równoległe podłączenie”, a nie „przejście z jednego na drugi”. Traktuj to jako listę kontrolną, nie szacunek roboczogodzin.
Migrując z Claude Code do Codex, zmiany koncentrują się w tych miejscach:
- Logika deduplikacji wymaga przepisania (punkt 1) — to miejsce najłatwiej lekceważyć. Dotychczasowy kod deduplikacji po id nie da się użyć bezpośrednio, a błąd nie zgłasza się — po prostu po cichu dodaje lub gubi wiadomości. Jeśli masz persistencję wiadomości, przed migracją koniecznie przemyśl, co ma być kotwicą.
- Sprawdzanie statusu online wymaga zmiany formy wywołania (punkt 2) — nakład mały, ale pominięcie powoduje „działa, a pokazuje offline” i nie rzuca wyjątku.
- Wszystkie funkcje zależne od chronologii historii wymagają ponownej weryfikacji (punkt 3) — widoki sub-agentów, paski postępu i każda logika „wnioskowania bieżącego stanu z historii”.
- UI zatwierdzania narzędzi wymaga warstwy rekompozycji poleceń (punkt 4) — jeśli twój produkt ma funkcję zatwierdzania, tego nie można pominąć, bo to równoznaczne z pozwoleniem użytkownikowi na podpisywanie w ciemno.
Kierunek przeciwny (Codex do Claude Code) zwykle jest prostszy: deduplikację można uprościć z powrotem do id, a struktura poleceń nie wymaga warstwy rekompozycji. Uważaj jednak, nie usuwaj od razu warstwy kompatybilności napisanej dla Codex — jeśli chcesz zachować możliwość jednoczesnego wsparcia, ta logika jest atutem, nie obciążeniem.
Co trzeba potwierdzić ponownie w obu kierunkach: miara limitów (punkt 6) i wydajność długiej historii (punkt 7). Te dwie rzeczy nie są tak bezpośrednio związane z silnikiem, ale to właśnie je najłatwiej zapomnieć przetestować po zmianie silnika.
Jedna rada: jeśli twój system jest już w produkcji i ma istniejące dane sesji, przed migracją uruchom nową logikę na istniejących danych dla porównania — nie przełączaj od razu. Tak powstała nasza lekcja z błędnego usunięcia 691 wpisów — sama logika wyglądała na poprawną, ale dopiero skan danych historycznych ujawnił, że połyka treści. Nowa logika poprawna ≠ bezpieczna dla istniejących danych.
Nasze podejście: nie wybieramy — podłączamy oba
Ponieważ musieliśmy wspierać oba narzędzia jednocześnie, naszym wnioskiem było wchłonięcie różnic w warstwie pośredniej — w górę wystawia ujednolicony model wiadomości i sesji, w dół adaptuje się do silnika. Koszt: każdy nowy silnik wymaga ponownego wyrównania tych siedmiu zachowań. Zysk: użytkownik może swobodnie przełączać silniki w tym samym interfejsie, a doświadczenie sesji, historii i zatwierdzania jest spójne.
Lista kontrolna podłączania nowego silnika
Jeśli też chcesz iść tą drogą, zalecamy weryfikację w tej kolejności: pierwsze cztery pozycje decydują, czy się da; ostatnie trzy decydują, czy na produkcji nie będzie problemów:
- Identyfikator wiadomości — czy wiadomości asystenta mają stabilne id? Jeśli nie, jaka jest twoja kotwica deduplikacji?
- Żywotność sesji — czy interfejs sprawdzania żywotności przyjmuje pojedynczą pozycję czy partię? Czy wysłanie złej struktury zgłasza błąd, czy po cichu zwraca błędną odpowiedź?
- Kolejność odtwarzania historii — czy kolejność ramek po odtworzeniu jest zgodna z rzeczywistą chronologią? Szczególnie przy wątkach podrzędnych.
- Struktura wywołań narzędzi — czy pole polecenia po pobraniu jest kompletne? Czy bywa pocięte?
- Zakres subskrypcji zdarzeń — które zdarzenia muszą mieć dokładnie jednego wykonawcę? Co się stanie przy podwójnym wykonaniu?
- Miara limitów — czy liczenie jest osobne dla silnika czy scalone? Czy frontend i backend są zgodne?
- Wydajność długiej historii — gdy liczba wiadomości wzrośnie dziesięciokrotnie, czy czas przetwarzania rośnie liniowo, czy szybciej?
Dla każdej pozycji zalecamy najpierw przetestować na małej ilości danych, potem na dużej historii — pozycje 3 i 7 ujawniają się dopiero po zwiększeniu ilości danych.
Odwrotne wyszukiwanie po objawach: na którą różnicę trafiłeś
Jeśli już wpadłeś w problem, wnioskowanie wstecz od objawów zwykle jest szybsze niż czytanie całej dokumentacji:
| Objaw, który widzisz | Najprawdopodobniej | Metoda jednoznacznej kwalifikacji |
|---|---|---|
| Po wyjściu i ponownym wejściu odpowiedzi asystenta się mnożą | Punkt 1 (identyfikator wiadomości) | Sprawdź bezpośrednio, ile wpisów jest w cache serwera — od razu widać, czy to warstwa danych, czy renderowania |
| Sesja działa, ale pokazuje offline | Punkt 2 (sprawdzanie żywotności) | Sprawdź, czy żądanie żywotności wysyła pojedynczą pozycję czy strukturę zbiorczą |
| Stan sub-agenta zaciął się na „uruchomiony”, odświeżenie też nie pomaga | Punkt 3 (kolejność odtwarzania) | „Odświeżenie też nie pomaga” jest kryterium: problem leży w odtwarzaniu, nie w dostarczaniu na żywo |
| Polecenia na kartach narzędzi są pocięte / karty narzędzi wiszą po zakończeniu odpowiedzi | Punkt 4 (struktura poleceń) | Patrz na strukturę pola polecenia w surowych ramkach, nie na wynik renderowania |
| Dwóch użytkowników wylogowuje siebie nawzajem | Punkt 5 (zakres subskrypcji) | Sprawdź, czy dwóch wykonawców jednocześnie przetwarza zdarzenia przełączania |
| Frontend pokazuje, że limit jest, a backend już go przekroczył | Punkt 6 (miara limitów) | Potwierdź, czy frontend i backend liczą osobno dla silnika, czy scalone |
| Aplikacja mobilna zawiesza się przy otwieraniu długiej sesji | Punkt 7 (długa historia) | Porównaj czas dla sesji o podwojonej liczbie wiadomości i sprawdź, czy wzrost jest nieliniowy |
Uniwersalne kryterium: jeśli objaw stabilnie powtarza się przy każdym odświeżeniu, problem najpewniej leży w odtwarzaniu historii lub warstwie danych; jeśli pojawia się tylko sporadycznie przy interakcji na żywo, dopiero wtedy szukaj w łańcuchu dostarczania. To kryterium oszczędziło nam sporo czasu — punkty 1 i 3 początkowo były błędnie klasyfikowane jako problemy klienta.
FAQ: Często zadawane pytania
Który jest naprawdę lepszy: Claude Code czy Codex?
Nie ma stałego zwycięzcy niezależnego od zadania i wersji. Jeśli procesy są już zbudowane wokół Hooks, Skills i CLAUDE.md Claude — wybierz Claude Code; jeśli już korzystasz z ChatGPT, aplikacji Codex, zadań w chmurze i przestrzeni roboczej OpenAI — wybierz Codex. Dla projektów wysokiego ryzyka porównanie w repozytorium przy ustalonym zadaniu i kryteriach akceptacji jest bardziej wiarygodne niż wyniki benchmarków stron trzecich.
Czy darmowy użytkownik Claude Code może korzystać z Remote Control?
Oficjalnie wymagana jest subskrypcja Pro, Max, Team lub Enterprise na Claude.ai, z wyraźnym wykluczeniem API Key, Bedrock, Vertex, Foundry i innych metod uwierzytelniania. Sam Claude Code CLI nadal może działać przez API Key lub obsługiwanych dostawców chmurowych z płatnością za zużycie, ale to nie oznacza posiadania oficjalnego uprawnienia Remote Control.
Czy darmowy użytkownik może korzystać z Codex?
OpenAI od czasu do czasu udostępnia użytkownikom Free/Go ograniczone czasowo limity Codex, ale to nie jest stabilne stałe świadczenie. Do długoterminowego użytkowania obowiązują obecnie obsługiwane plany, takie jak Plus, Pro, Business, Enterprise, Edu itd.; Remote zależy również od wersji aplikacji desktopowej, autoryzacji urządzeń i polityk przestrzeni roboczej.
Czy darmowa wersja PandaNpc zawiera limity modeli Claude lub Codex?
Nie. PandaNpc Free oferuje maksymalnie 2 urządzenia agentów online i 5 równoległych sesji agentów oraz zapewnia zdalną kontrolę i łączność między urządzeniami; koszty Claude, ChatGPT, API lub innych modeli nadal pokrywa własne konto nadrzędne użytkownika.
Jak wybrać zdalną kontrolę między Claude Code, Codex i PandaNpc?
Jeśli kontrolujesz tylko oficjalny Claude Code CLI, Claude Remote Control jest najbardziej bezpośrednim rozwiązaniem; jeśli używasz desktopowego Codex w ChatGPT i łączysz się głównie z telefonu, wybierz Codex Remote; jeśli chcesz jednolicie kontrolować z przeglądarki i różnych systemów desktopowych Claude Code, Codex CLI oraz wiele hostów Linux/Windows/macOS, albo zachować konfigurację API i modeli niestandardowych, użyj wielosilnikowej warstwy połączeń, takiej jak PandaNpc.
Czy Codex CLI i OpenAI Codex to to samo?
Codex omawiany w tym artykule oznacza narzędzie kodowania w wierszu poleceń od OpenAI. Na rynku istnieją też inne produkty o nazwie Codex (w tym oprogramowanie z obszaru prawa i zgodności), co łatwo myli przy wyszukiwaniu — dodanie „CLI” lub „OpenAI” znacznie zwiększa precyzję.
Czy te różnice zmieniają się wraz z wersjami?
Tak. Każda z powyższych pozycji to zachowanie, na które trafiliśmy w konkretnym momencie; oba silniki szybko ewoluują. Dlatego ważniejsza jest lista kontrolna — konkretne różnice się zmienią, ale wymiary wymagające weryfikacji raczej nie.
Czy można podłączyć oba silniki jednocześnie?
Można — właśnie tak zrobiliśmy. Klucz to wchłonięcie różnic w warstwie pośredniej, a nie pozwolenie im przeniknąć do warstwy UI — w przeciwnym razie każdy nowy silnik wymaga rozwidlenia logiki interfejsu.
Dalsze plany
Planujemy dodać porównawcze testy zadań (ta sama partia zadań, ustalone wersje, publiczna metodologia i surowe wyniki), a wyniki zaktualizujemy w tym artykule. Do tego czasu artykuł nie zawiera żadnych liczb dotyczących wydajności ani wskaźników sukcesu — tego, czego nie przetestowaliśmy, nie opiszemy jako przetestowanego.
Artykuł oparty na naszym rzeczywistym doświadczeniu inżynieryjnym z podłączania Claude Code i OpenAI Codex do tego samego systemu zdalnego dostępu. Ostatnia aktualizacja: 2026-08-30. Oba silniki są stale aktualizowane — szczegółowe zachowania należy sprawdzać w oficjalnej dokumentacji każdego z nich.
Powiązane przewodniki
Jak korzystać z Claude Code Remote Control? Zdalne sterowanie z telefonu, oficjalne ograniczenia i alternatywy (2026)
Jak włączyć Claude Code Remote Control? W tym artykule przedstawiamy trzy oficjalne sposoby użycia: claude remote-control, claude --remote-control oraz /remote-control, wyjaśniamy łączenie telefonu z przeglądarką, wymagania konta, metody weryfikacji i typowe błędy, a także porównujemy rozwiązanie PandaNpc w scenariuszach z niestandardowymi modelami, Codex i wieloma maszynami.
Przeczytaj artykuł →
Czy subskrypcję Claude można współdzielić? Jak bezpiecznie udostępnić Claude Code znajomym i zespołowi (bez podawania hasła, z możliwością odwołania w każdej chwili)
Można — i to bez przekazywania komukolwiek danych logowania. PandaNpc umożliwia udostępnienie połączenia Claude Code z Twojej maszyny za pomocą linku znajomym, rodzinie lub członkom zespołu: druga osoba zdalnie korzysta z Twojego limitu subskrypcji do uruchamiania Claude Code, każde udostępnienie to niezależny, odwoływalny token, można ustawić ważność na 1/7/30 dni lub bezterminowo, jednym kliknięciem odwołujesz dostęp, a druga osoba natychmiast traci połączenie, całkowicie bez wpływu na Twoje własne korzystanie.
Przeczytaj artykuł →
Używaj Codex na telefonie: ChatGPT Remote vs CLI (2026)
Używaj Codex na iPhone lub Androidzie: ChatGPT Remote steruje czatami na Mac/Windows, a PandaNpc — Codex CLI i hostami Linux. Porównaj konfigurację, ograniczenia i rozwiązywanie problemów.
Przeczytaj artykuł →