
Claude Fable 5.1 – Analiză completă: benchmark-uri, îmbunătățiri, preț și viteză
Rezultatele complete ale lui Claude Fable 5.1 pe 7 categorii de benchmark-uri principale, comparate punctual cu Fable 5, Opus 5, GPT-5.6 Sol, și explicarea modificărilor din 5.1 privind sarcinile lungi, apelurile de instrumente, costurile de cache, viteza, limitele planurilor și migrarea.

Claude Fable 5.1 a fost lansat oficial pe 1 septembrie 2026. Concluzia pe scurt: nu este o actualizare obișnuită de model pentru întrebări generale, ci un model flagship cu costuri ridicate, gândit pentru sesiuni lungi de programare, cercetare complexă, apeluri de instrumente între aplicații și agenți nesupravegheați. În cele 7 categorii principale de benchmark-uri publicate de Anthropic, Fable 5.1 îl depășește pe Fable 5 în toate; totuși, prețul său unitar API este de două ori mai mare decât cel al Opus 5, iar oficialii descriu latența relativă drept „mai lentă”.
Dacă sarcina ta este doar să modifici un fișier, să scrii un text scurt sau să răspunzi la întrebări obișnuite, Anthropic îți recomandă tot să începi cu Opus 5. Fable 5.1 este mai potrivit pentru sarcini cu lanț lung, pe care modelele obișnuite nu le pot finaliza stabil nici măcar cu effort ridicat. Acest articol reunește datele oficiale de lansare, semnificația fiecărui benchmark, îmbunătățirile concrete din 5.1, prețul, viteza și limitările de migrare, ca să nu te uiți doar la un clasament de tip „cine a câștigat”.
Specificațiile Fable 5.1 dintr-o privire
| Specificație | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Fereastră de context | 1M token | 1M token | 1M token |
| Ieșire maximă | 128K token | 128K token | 128K token |
| Preț de intrare | $10 / MTok | $5 / MTok | $2 / MTok |
| Preț de ieșire | $50 / MTok | $25 / MTok | $10 / MTok |
| Latență relativă | Mai lentă | Medie | Rapidă |
| Thinking | Adaptive, mereu activ | Adaptive | Adaptive |
| Effort implicit | High | High | High |
| Limita cunoștințelor fiabile | iunie 2026 | mai 2026 | ianuarie 2026 |
„Mai lentă” provine din catalogul de modele Anthropic și reprezintă o treaptă de latență relativă, nu un număr fix de tokeni pe secundă. Cât durează efectiv finalizarea unei sarcini depinde de effort, de numărul rundelor de apeluri de instrumente, de rata de succes a cache-ului, de lungimea contextului și de reîncercările după eșecuri.

Tabelul complet al benchmark-urilor principale pentru Fable 5.1
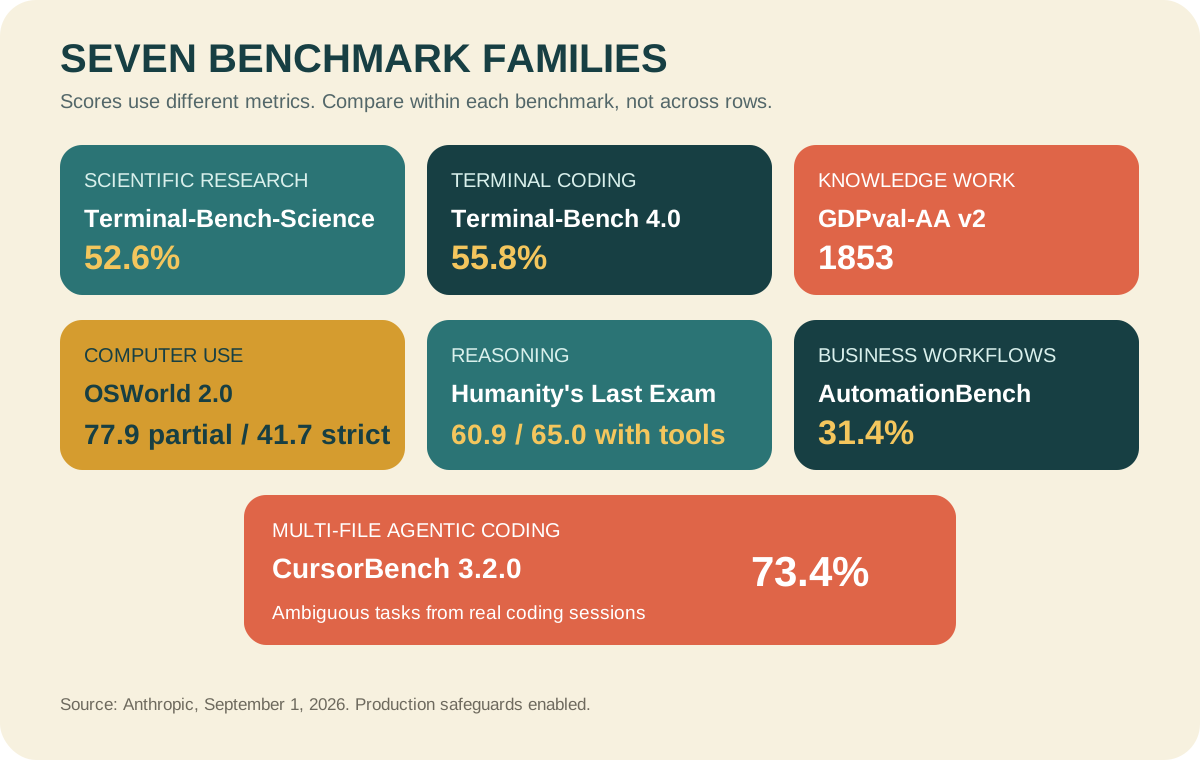
Tabelul de mai jos reproduce tabelul principal din pagina de lansare Anthropic din 1 septembrie 2026. Pentru a evita interpretările greșite, procentele, scorul brut GDPval-AA, scorurile partial/strict de la OSWorld și rezultatele HLE cu/fără instrumente sunt listate separat. Fiecare benchmark își păstrează numele oficial în engleză, iar pe rândul următor primește numele în limba locală; versiunile în alte limbi afișează și ele traducerea corespunzătoare sub numele englezesc.
| Capacitate | Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol | 5.1 față de Fable 5 |
|---|---|---|---|---|---|---|
| Cercetare științifică cu agenți | Terminal-Bench-Science 0.1 Benchmark de terminal pentru cercetare științifică cu agenți |
52,6% | 24,7% | 29,0% | 22,4% | +27,9 puncte procentuale |
| Programare în terminal cu agenți | Terminal-Bench 4.0 Benchmark de programare în terminal pentru agenți |
55,8% | 42,0% | 52,3% | 37,3% | +13,8 puncte procentuale |
| Muncă profesională de specialitate | GDPval-AA v2 Benchmark de sarcini profesionale cu valoare economică reală |
1853 | 1723 | 1824 | 1711 | +130 de puncte |
| Operarea computerului | OSWorld 2.0 — Partial Benchmark real de operare a computerului: scor finalizare parțială |
77,9% | 72,9% | 75,4% | — | +5,0 puncte procentuale |
| Operarea computerului | OSWorld 2.0 — Strict Benchmark real de operare a computerului: rată strictă de finalizare |
41,7% | 36,1% | 39,6% | — | +5,6 puncte procentuale |
| Raționament multidisciplinar | Humanity's Last Exam — No tools Ultimul examen al umanității: fără instrumente |
60,9% | 57,8% | 56,6% | — | +3,1 puncte procentuale |
| Raționament multidisciplinar | Humanity's Last Exam — With tools Ultimul examen al umanității: cu instrumente |
65,0% | 63,8% | 63,6% | — | +1,2 puncte procentuale |
| Fluxuri de lucru de afaceri | AutomationBench Benchmark pentru automatizarea fluxurilor de afaceri între aplicații |
31,4% | 17,1% | 26,9% | 19,6% | +14,3 puncte procentuale |
| Programare cu agenți | CursorBench 3.2.0 Benchmark de sarcini reale de programare multi-fișier |
73,4% | 70,5% | 70,0% | 67,2% | +2,9 puncte procentuale |
— înseamnă că tabelul principal Anthropic nu oferă un scor corespunzător pentru acel câmp, nu că modelul respectiv nu poate îndeplini sarcinile. Pe Terminal-Bench 4.0, Mythos 5.1 – care are mai puține restricții și este disponibil doar prin programe de încredere – a obținut 60,9%; acest articol se concentrează pe Fable 5.1, disponibil utilizatorilor obișnuiți, și nu amestecă scorurile Mythos în coloana Fable.
Ce măsoară Terminal-Bench-Science 0.1
Terminal-Bench-Science 0.1 include 70 de fluxuri reale de cercetare din cinci domenii majore: științele vieții, științele fizice, științele Pământului, matematică și inginerie. Sarcinile nu sunt întrebări cu variante de răspuns, ci cer Agentului să realizeze în terminal analiza datelor, inferențe statistice, simulări, optimizări, demonstrarea teoremelor, reconstrucție de imagini sau machine learning științific și să verifice rezultatele prin teste reproductibile.
Scorul de 52,6% al Fable 5.1, comparat cu 24,7% al Fable 5 în experimentele oficiale de reproducere, înseamnă o creștere de 27,9 puncte procentuale – cel mai clar salt din tot tabelul. Dar oficialii indică în același timp o eroare standard de aproximativ ±3,5–4,5 puncte procentuale pentru fiecare model, deci nu trebuie să tratezi prima zecimală drept un clasament absolut exact.
Ce măsoară Terminal-Bench 4.0 și CursorBench 3.2.0
Terminal-Bench pune Agentul să gestioneze sarcini complexe într-un mediu real de terminal, urmărind dacă acesta înțelege mediul, apelează instrumente, modifică fișiere și trece în cele din urmă de verificări. Fable 5.1 obține 55,8%, cu 13,8 puncte procentuale peste Fable 5 și peste scorul de 52,3% al Opus 5.
CursorBench 3.2 provine din sarcini neclare, multi-fișier, din sesiuni reale Cursor; versiunea 3.2 adaugă probleme legate de respectarea instrucțiunilor și de utilizarea avansată a instrumentelor. Fable 5.1 Max obține 73,4% – avansul nu este la fel de spectaculos ca la Terminal-Bench-Science – dar folosește în medie 72.060 de tokeni per sarcină, la un cost de 9,64 $; Fable 5 Max folosește 103.525 de tokeni și costă 17,32 $. Ceea ce merită mai multă atenție aici este scăderea numărului de tokeni și a costurilor pentru același tip de sarcini, nu cele 2,9 puncte procentuale în sine.
Ce măsoară GDPval-AA v2
GDPval-AA v2 folosește 220 de sarcini create de profesioniști din industrie, care acoperă 44 de ocupații și 9 industrii, pentru a evalua capacitatea modelelor de a gestiona muncă intelectuală reală, cu valoare economică. Scorul 1853 este un scor compozit, nu 1853%. Rezultatul arată că Fable 5.1 îl depășește pe Fable 5 la documente profesionale, analize și livrabile, și îl depășește ușor și pe Opus 5.
De ce OSWorld 2.0 are două scoruri
OSWorld 2.0 include 108 fluxuri de lucru lungi de operare a computerului, cu o durată medie de finalizare umană de aproximativ 1,6 ore per sarcină. Partial acordă puncte pentru finalizare parțială pe baza mai multor puncte de control; Strict consideră succes doar atingerea completă a obiectivului.
Așadar, scorurile Fable 5.1 de 77,9% partial și 41,7% strict nu se contrazic: modelul finalizează deseori cea mai mare parte a pașilor, dar unele sarcini nu sunt duse până la capăt, end-to-end. Asta ne reamintește că un Agent de computer care „pare să tot lucreze” nu înseamnă că sarcina a fost finalizată cu succes.
Ce măsoară Humanity's Last Exam
Humanity's Last Exam a fost creat de Center for AI Safety și Scale AI și conține 2.500 de întrebări interdisciplinare, de nivel expert, greu de rezolvat printr-o simplă căutare. Fable 5.1 îl depășește pe Fable 5 cu 3,1 puncte procentuale fără instrumente, dar doar cu 1,2 puncte procentuale când instrumentele sunt permise. Este într-adevăr mai puternic, dar nu toate benchmark-urile arată creșteri duble.
Ce măsoară AutomationBench
AutomationBench verifică dacă Agentul poate finaliza fluxuri de vânzări, marketing, operațiuni, suport clienți, finanțe și resurse umane prin instrumente SaaS simulate, cum ar fi CRM, e-mail, calendar, mesagerie și management de proiecte. Fable 5.1 urcă de la 17,1% la 31,4%, o îmbunătățire relativă de aproximativ 84%, ceea ce arată un progres real în gestionarea stării între mai multe aplicații și în execuția pașilor lungi; dar 31,4% arată și că acest tip de automatizare de afaceri nesupravegheată este încă departe de a fi rezolvat.

Ce îmbunătățiri aduce Fable 5.1 față de Fable 5
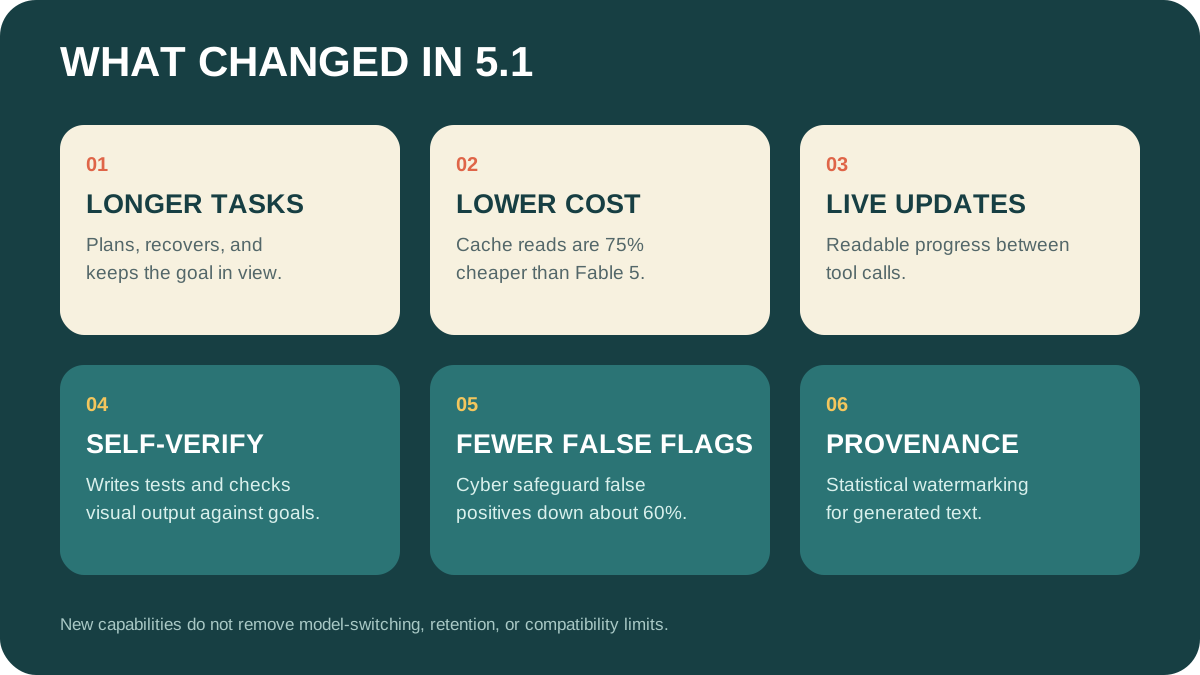
1. Mai puține scurtături în sarcinile lungi
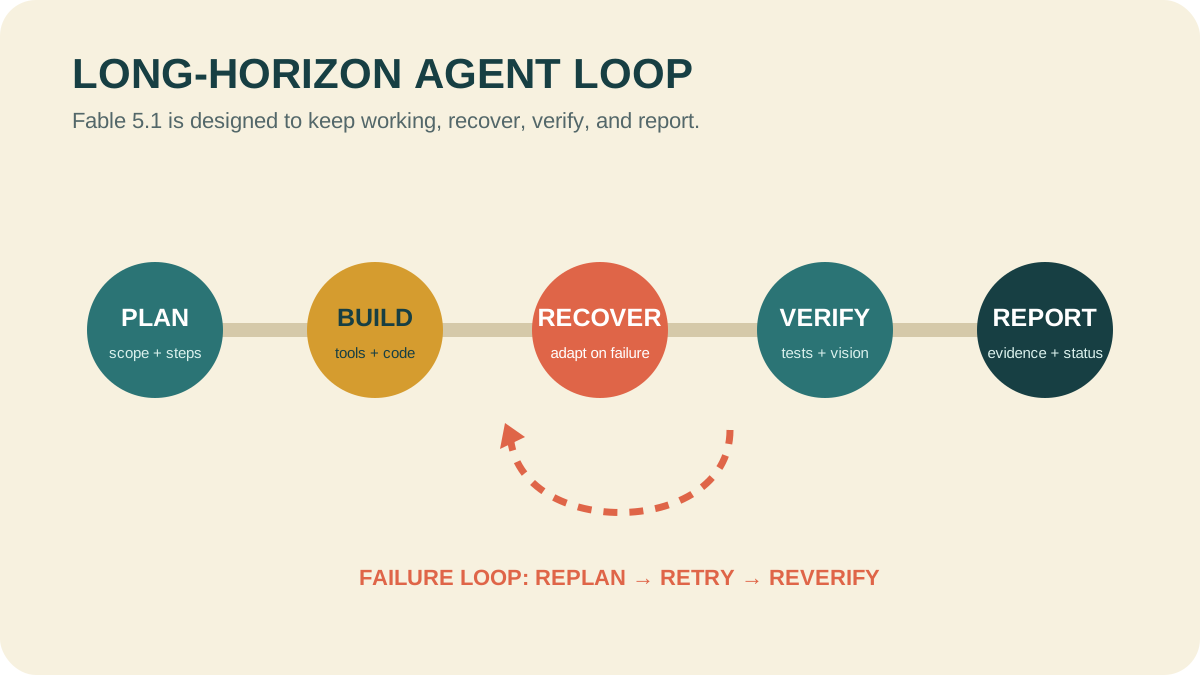
Anthropic poziționează Fable 5.1 ca model Agent de lungă durată: mai întâi planifică, apoi folosește instrumente, își revine după eșecuri, verifică rezultatele și raportează proactiv progresul. Accentul cade mai mult pe repararea cauzei rădăcină, nu pe ocoliri locale menite doar să facă un singur test să devină verde cât mai repede. Scenariile țintă enumerate oficial includ funcționalități care traversează mai multe baze de cod, code review, optimizarea performanței, sesiuni autonome de mai multe zile, cercetare, documentație, foi de calcul și prezentări.
2. Effort scăzut poate apropia rezultatele de cele costisitoare ale generației anterioare
Fable 5.1 adaugă posibilitatea de a ajusta effort-ul pentru fiecare mesaj. Curbele oficiale de cost arată că, pe unele sarcini, effort Low sau Medium poate atinge sau depăși Fable 5, reducând în același timp numărul de tokeni și costurile. Claude Code folosește implicit effort High; Claude.ai și Cowork folosesc implicit Medium, așa că atunci când compari modele trebuie mai întâi să confirmi effort-ul – nu pune direct față în față rezultate de la niveluri diferite.
3. Progres lizibil între apelurile de instrumente
API-ul adaugă o capacitate de test display: "updates", care permite modelului să ofere actualizări de progres destinate utilizatorului între apelurile de instrumente. Pentru sarcinile care rulează ore întregi, este mai ușor să îți dai seama ce face modelul și dacă s-a abătut de la obiectiv, decât dacă ai vedea doar carduri de instrumente apărând continuu.
4. Scriere, verificare vizuală și auto-testare mai complete
Oficialii spun că 5.1 scrie proactiv teste pentru a-și valida propriile modificări și folosește capacități vizuale pentru a verifica rezultatele în raport cu obiectivele de design. Evaluările partenerilor evidențiază și ele progres mai concis, răspunsuri mai complete la întrebările cu mai multe părți, urmărirea lanțurilor de apeluri între mai multe servicii și păstrarea lizibilității după rulări lungi. Sunt feedback-uri calitative și nu ar trebui să treacă drept o concluzie unitară de benchmark.
5. Interceptarea de securitate este mai precisă, dar nu a dispărut
Scutul de securitate cibernetică al Fable 5.1 reduce alarmele false cu aproximativ 60% față de lansarea Fable 5, iar întrebările de bază din biologie și medicină declanșează degradări cu aproximativ 85% mai rar. Modelul poate fi folosit acum pentru a descoperi vulnerabilități software, dar sarcinile cu dublă utilizare – cum ar fi testele de penetrare, generarea de cod de exploatare sau scanarea vulnerabilităților binare – pot fi în continuare direcționate către Opus. Cererile direcționate astfel nu sunt facturate la prețul Fable.
6. Noutate: marcarea provenienței conținutului
Fable 5.1 introduce content provenance. Textul generat poate purta un filigran statistic, care poate fi verificat prin instrumentul de verificare a conținutului de la Anthropic. Nu adaugă marcaje vizibile în corpul textului, dar pentru platformele de conținut, educație și auditurile enterprise este un comportament nou de care trebuie să ții cont din timp.

Cum se calculează costul Fable 5.1
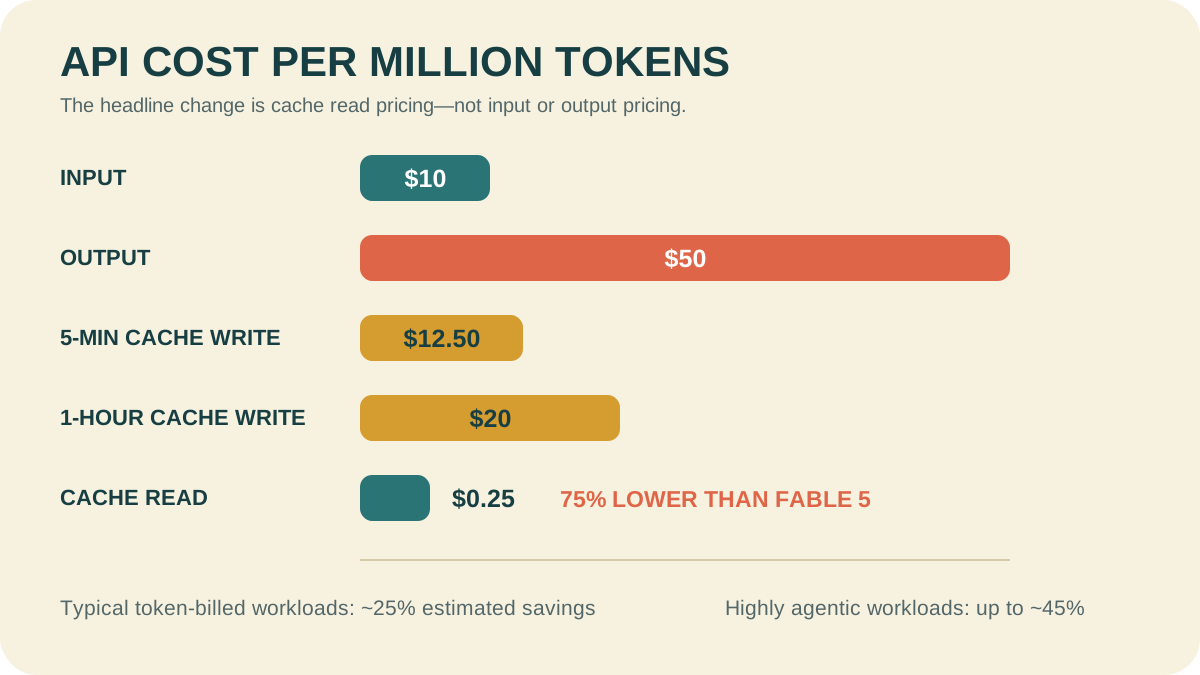
| Element de facturare | Preț Fable 5.1 | Comparativ cu Fable 5 |
|---|---|---|
| Intrare | $10 / 1 milion de tokeni | Identic |
| Ieșire | $50 / 1 milion de tokeni | Identic |
| Scriere cache 5 minute | $12,50 / 1 milion de tokeni | Același nivel |
| Scriere cache 1 oră | $20 / 1 milion de tokeni | Același nivel |
| Citire cache | $0,25 / 1 milion de tokeni | Redusă cu 75% |
| Batch API | 50% din prețul de intrare și de ieșire | Conform regulilor Batch |
Să presupunem că o sarcină lungă citește în total 10 milioane de tokeni din cache, generează 200.000 de tokeni noi de intrare și 50.000 de tokeni de ieșire, fără a lua în calcul scrierile în cache:
缓存读取:10 × $0.25 = $2.50
新输入:0.2 × $10 = $2.00
输出:0.05 × $50 = $2.50
合计:$7.00
Aceleași 10 milioane de citiri din cache costă aproximativ 10 $ pe Fable 5, deci doar acest element face o diferență de 7,50 $. Pe baza acestor date, Anthropic estimează că sarcinile tipice facturate pe tokeni pot avea costuri reale mai mici cu aproximativ 25%, iar sarcinile puternic orientate pe agenți, care reutilizează frecvent contexte lungi, pot ajunge la reduceri de până la aproximativ 45%. Nu este o ieftinire generală a prețului de listă API, ci cu cât cache-ul este accesat cu succes mai des, cu atât economiile sunt mai evidente.
Abonații nu beneficiază neapărat direct de reducerea pentru cache-ul API
Locurile premium (premium seat) Max și Team/Enterprise pot folosi până la 50% din cota săptămânală pentru modelele Fable; Pro și locurile standard folosesc usage credits de la început. Consumul exact afișat este cel din pagina Usage a contului. Reducerea pentru citirea din cache vizează în principal scenariile de facturare pe tokeni, așa că nu poți converti direct reducerea de 75% pentru cache-ul API într-un „plan Max de patru ori mai mult”.

Este Fable 5.1 rapid sau nu?
Răspunsul: răspunsul pe o singură rundă este mai lent, dar timpul total de finalizare pentru sarcini complexe poate fi mai scurt.
- Catalogul de modele Anthropic marchează Fable 5.1 drept
Slower, Opus 5 dreptModerate, iar Sonnet 5 dreptFast. - Claude Code folosește implicit effort High, ceea ce aduce în mod natural mai mult timp de raționament decât Low sau Medium.
- Every afirmă că, pe propriile încărcături de lucru, Fable 5.1 este de aproximativ două ori mai rapid decât Opus 5 și folosește jumătate din numărul de tokeni; este un test specific al unui partener, nu o garanție generală de viteză.
- În CursorBench, Fable 5.1 Max parcurge în medie 70 de pași și 72.060 de tokeni; Fable 5 Max are tot 72 de pași, dar folosește 103.525 de tokeni. Avantajul lui 5.1 seamănă mai degrabă cu „mai puține ocolișuri, mai puțini tokeni consumați”, nu neapărat cu un prim răspuns mai rapid.
Prin urmare, pentru chat, cod scurt și interacțiuni frecvente alege mai degrabă Sonnet 5 sau Opus 5; pentru depanare care traversează mai multe baze de cod, cercetare lungă și sarcini nesupravegheate care trebuie să își verifice singure rezultatele, ia în considerare Fable 5.1.
Modificări de compatibilitate de rezolvat înainte de trecerea la Fable 5.1
Claude Code trebuie actualizat cel puțin la 2.1.250
Documentația Anthropic despre planuri și disponibilitate cere Claude Code 2.1.250 sau o versiune mai nouă. Dacă nu vezi Fable 5.1, verifică mai întâi:
claude --versionApoi actualizează prin metoda oficială de upgrade pentru Claude Code și repornește sesiunea. ID-ul modelului API pentru Fable 5.1 este:
claude-fable-5-1Forced tool use poate genera erori direct
Dacă o cerere forțează modelul să apeleze un anumit instrument, Fable 5.1 poate returna o eroare. Înainte de migrare, verifică tool_choice și fluxurile care forțează instrumente în agenții construiți intern; nu presupune că comportamentul Fable 5 este complet compatibil.
Thinking blocks nu pot fi reutilizate arbitrar între modele
Modelele mai vechi nu pot citi thinking blocks provenite de la Fable 5.1. Când schimbi modelul, lasă SDK-ul să gestioneze aceste blocuri conform regulilor oficiale, în loc să i le trimiți altui model exact ca atare.
Modificarea istoricului vechi poate duce la eroarea 400
Pentru conturile API noi create după 31 august 2026, thinking blocks sunt valide doar sub prefixul conversației originale în care au fost generate. Dacă modifici system, tools sau mesajele mai vechi și apoi redai thinking blocks, poți primi eroarea 400. Oficialii recomandă să păstrezi istoricul append-only; când ai nevoie de compactare, înlocuiește tot istoricul vechi cu un rezumat nou – nu modifica runde vechi păstrând în același timp thinking blocks originale. Instrucțiunile detaliate sunt în Ghidul de prompting și migrare pentru Fable 5.1.
Când ar trebui să alegi Fable 5.1
Potrivit pentru:
- sarcini lungi care traversează mai multe repository-uri, servicii sau aplicații;
- agenți care trebuie să ruleze ore întregi și să își revină singuri după eșecuri;
- cercetare științifică, analiză complexă de date și livrabile profesionale în mai multe etape;
- probleme de sistem greu de reprodus, optimizări de performanță și investigarea cauzelor rădăcină;
- încărcături de lucru API care reutilizează intens contexte lungi și au o pondere mare de citiri din cache.
Nepotrivit pentru:
- chat simplu, texte scurte sau modificări mici într-un singur fișier;
- interacțiuni în timp real foarte sensibile la latența primului răspuns;
- sarcini cu volum mare de ieșire, buget fix și fără reutilizarea cache-ului;
- scenarii care nu pot accepta păstrarea implicită de 30 de zile a datelor de monitorizare de securitate și care nu îndeplinesc condițiile de excepție enterprise;
- fluxuri de lucru care cer ca toate cererile de securitate cibernetică sau de științe ale vieții să nu declanșeze niciodată degradări.
Cum să urmărești de la distanță sarcinile lungi
Valoarea lui Fable 5.1 apare adesea în sarcini care durează ore sau chiar zile, dar asta nu înseamnă că trebuie să stai permanent lângă mașina de dezvoltare. Confirmă mai întâi că Fable 5.1 este disponibil în Claude Code 2.1.250+ instalat local, apoi folosește PandaNpc Agent pentru a vedea din browser, de pe desktop sau de pe telefon sesiunile Claude Code de pe aceeași mașină de dezvoltare, pentru a răspunde la interacțiuni și pentru a trimite instrucțiuni în continuare.
Ceea ce se schimbă este punctul de control; codul, instrumentele și build-urile rulează în continuare pe mașina ta de dezvoltare. Poți citi mai întâi Ghidul de acces remote pentru Claude Code și Tutorialul de conectare la Claude Code de pe telefon, iar după ce ai confirmat legătura remote poți încredința sarcinile lungi lui Fable 5.1.
Întrebări frecvente (FAQ)
Cu cât este mai puternic Fable 5.1 decât Fable 5?
Diferențele variază mult în funcție de sarcină. Pe Terminal-Bench-Science, creșterea este de 27,9 puncte procentuale; pe AutomationBench, de 14,3 puncte procentuale; pe HLE cu instrumente, creșterea este de doar 1,2 puncte procentuale. Nu poți folosi o singură creștere maximă pentru a reprezenta toate sarcinile.
Este Fable 5.1 mai rapid decât Opus 5?
În tabelul oficial al latenței relative, Fable 5.1 este „mai lent”, iar Opus 5 este „mediu”. Unii parteneri au observat însă că Fable 5.1 este mai rapid pe sarcini complete, pentru că folosește mai puțini tokeni și presupune mai puțină muncă refăcută. Cele două concluzii nu măsoară același lucru.
Este Fable 5.1 mai potrivit pentru programare decât GPT-5.6 Sol?
În tabelele publicate de Anthropic, Fable 5.1 are scoruri mai mari pe Terminal-Bench-Science, Terminal-Bench, AutomationBench și CursorBench; dar modelele diferite folosesc harness-uri de Agent diferite, effort diferit, instrumente diferite și prețuri diferite, așa că nu se poate afirma că Fable câștigă pe toate repository-urile reale. Poți consulta Tutorialul de configurare a contextului 1M pentru GPT-5.6 Sol, apoi poți face propriile teste A/B pe sarcini reprezentative.
De ce trece Fable 5.1 brusc pe Opus?
Unele cereri de securitate cibernetică și de științe ale vieții sunt direcționate către Opus de safeguards. Schimbarea modelului nu este neapărat o defecțiune; Anthropic spune că cererile astfel direcționate nu sunt facturate la prețul Fable.
Are Fable 5.1 filigran?
Da, există un mecanism statistic de content provenance, dar nu se adaugă etichete vizibile la suprafața textului. Nu este același lucru cu filigranele vizibile din colțul imaginilor.
Concluzie
Cele mai vizibile progrese ale Claude Fable 5.1 se concentrează pe cercetarea științifică, sarcinile din terminal și fluxurile de lucru de afaceri care traversează aplicații multiple: modelul reușește să execute mai susținut, să își revină după eșecuri, să verifice rezultatele și să reducă costurile sarcinilor lungi prin citiri din cache mai ieftine. Dar rămâne scump, cu latență mai mare pe răspuns individual, și aduce schimbări de compatibilitate legate de thinking blocks, forțarea apelurilor de instrumente și editarea istoricului.
Întrebarea corectă în alegerea lui nu este „este primul la scoruri?”, ci: sarcina ta este suficient de lungă și de complexă, iar costul eșecurilor și al muncii refăcute este suficient de mare ca Fable 5.1 să merite? Dacă răspunsul este nu, de obicei este mai potrivit să începi cu Opus 5 sau Sonnet 5.
Ghiduri conexe

Codex: activează contextul GPT-5.6 Sol 1M – Tutorial de configurare `config.toml` cu 3 linii
GPT-5.6 Sol acceptă oficial un context de 1,05 milioane de tokeni. Trebuie doar să adaugi 3 linii de configurare în partea de sus a config.toml din Codex pentru a rula cu o fereastră de 1 milion și pentru a comprima automat istoricul la aproximativ 900 de mii de tokeni. Include configurare permanentă, comandă unică, verificare și memento de costuri.
Citește articolul →
Cum se folosește Claude Code Remote Control? Control de la distanță de pe telefon, limitări oficiale și alternative (2026)
Cum se activează Claude Code Remote Control? Acest articol prezintă trei utilizări oficiale: claude remote-control, claude --remote-control și /remote-control, explică conectarea telefonului și a browserului, cerințele contului, metodele de verificare și erorile frecvente, și compară soluția PandaNpc în scenariile cu modele personalizate, Codex și cu mai multe mașini.
Citește articolul →
Conectează-te la Claude Code de pe telefon: vizualizează sesiunile și aprobările oricând pe iOS
Acest articol se adresează dezvoltatorilor și prezintă cele mai bune practici pentru conectarea la Claude Code de pe telefon. Prin aplicația PandaNpc iOS, puteți vizualiza conversațiile în timp real, aproba apelurile de instrumente și răspunde la întrebări. Cu ajutorul pandapaw și iOS Live Activity, puteți controla de la distanță în mod eficient, sporind flexibilitatea codării.
Citește articolul →